
Résumé :
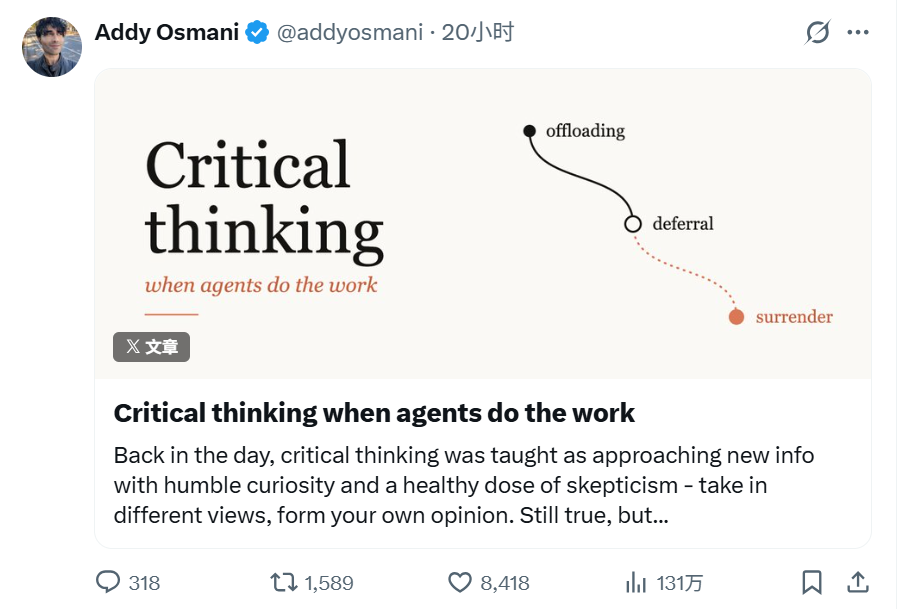
Le 4 novembre, Addy Osmani, ingénieur de l'équipe Claude Code d'Anthropic et ancien responsable technologique de Google, a récemment publié un long article sur la plateforme sociale. Il appelle ce phénomène
"abandon cognitif"
(Abandon cognitif).
Osmani travaille chez Google depuis plus de 14 ans et est responsable de l'expérience des développeurs Chrome et des activités liées à Google Cloud AI. Il travaille actuellement sur Claude Code chez Anthropic.
Osmani a déclaré qu'il était un fervent partisan du flux de travail des agents IA et qu'il exécutait souvent plusieurs agents en même temps dans son travail quotidien. Mais il a découvert un changement qui mérite vigilance :
À mesure que les modèles d'IA continuent de s'améliorer, il y a de moins en moins d'erreurs évidentes dans les résultats, ce qui rend plus difficile pour les humains de rester vigilants.
Dans le passé, les gens devaient généralement passer par un processus de collecte d'informations, d'analyse, de jugement, etc. pour obtenir la réponse, mais aujourd'hui, ce processus peut être réduit à quelques secondes. Le contenu généré par l’IA est souvent bien structuré, exprimé couramment et correct dans la plupart des cas, ce qui permet aux utilisateurs d’éviter de plus en plus facilement la réflexion et la vérification indépendantes.
Il a divisé l'état de l'utilisation humaine de l'IA en trois niveaux : le premier est le
"déchargement cognitif"
(Cognitive Offloading), ce qui signifie que la tâche est confiée à l'IA pour achèvement, mais qu'elle est toujours responsable des résultats ; la seconde est"reporter le jugement"
(Différé), c'est-à-dire que les résultats de l'IA ne sont plus considérés comme une hypothèse qui doit être vérifiée, mais directement utilisés comme base pour la prochaine étape du travail ; le dernier est"Abandon cognitif"
,C'est-à-dire que le résultat de l'IA devient progressivement le propre jugement de l'utilisateur, et l'utilisateur ne pense même plus qu'il est nécessaire de vérifier.
Parmi eux, le concept de « capitulation cognitive » a été proposé pour la première fois par les chercheurs de la Wharton School, Steven Shaw et Gideon Nave.
Osmani estime que
cette transformation ne se produit souvent pas soudainement, mais se forme progressivement au cours du processus d'utilisation continue de l'IA
.
Les utilisateurs peuvent lire attentivement le premier rapport sur l’IA, jeter un rapide coup d’œil au deuxième et même simplement vérifier les grandes lignes du troisième. Finalement, lorsqu’on les interroge sur une conclusion spécifique, les utilisateurs peuvent se retrouver incapables d’en expliquer la logique.Il a lié ce phénomène à la « dette cognitive ». Dans le domaine du développement logiciel, l'IA peut générer une grande quantité de code et tous les tests peuvent réussir, mais la compréhension des membres de l'équipe de l'architecture du système et de la logique de mise en œuvre diminue constamment. Ce n'est que le jour où le système a dû être modifié que les développeurs ont découvert que personne ne comprenait vraiment le fonctionnement de certaines fonctionnalités.
Cependant, Osmani ne pense pas que les développeurs doivent se souvenir de tous les détails d'une énorme base de code. Il a souligné que l'équipe Claude Code utilisera également l'IA pour rétablir la compréhension de modules de code spécifiques lorsque cela est nécessaire. Ce qui est vraiment important, ce n'est pas de tout savoir à tout moment, mais de savoir ce qu'on ne sait pas et d'avoir la capacité de le re-comprendre.
Quant à la manière d'éviter la « capitulation cognitive », Osmani a suggéré :
Avant de poser des questions complexes à l'IA, les humains devraient formuler leurs propres hypothèses préliminaires au lieu de s'appuyer entièrement sur l'IA pour fournir des réponses.
Même si l’estimation initiale n’est pas exacte, elle peut aider les utilisateurs à conserver une base de jugement indépendant lors de la réception des résultats de l’IA.Il a également suggéré que
les utilisateurs recherchent activement des preuves susceptibles d'infirmer les conclusions de l'IA, plutôt que de simplement demander au modèle dans quelle mesure il est sûr de sa réponse.
Pour les questions controversées, différents modèles peuvent présenter des arguments issus de positions opposées, ce qui permet aux humains de porter des jugements complets.Dans le domaine du développement de logiciels, Osmani estime que le goulot d'étranglement à l'ère de l'IA passe de l'écriture de code à la vérification de l'exactitude du code.
Actuellement, les agents IA peuvent écrire du code de manière indépendante, exécuter des tests, lire des messages d'erreur et les modifier à plusieurs reprises jusqu'à ce que le test réussisse. Mais le problème est que les tests eux-mêmes peuvent également être écrits par l’IA. Si la logique et le code du test comportent les mêmes erreurs, même si tous les tests réussissent, cela ne peut pas prouver que le logiciel n'a pas de problèmes.
Par conséquent, il a souligné que les développeurs doivent non seulement faire attention à la réussite du test, mais également clarifier ce que le test prouve et quels risques ne sont pas couverts. Pour les résultats fournis par l’IA, les critères d’acceptation doivent être des preuves vérifiables telles que des résultats de tests réels, des journaux d’opérations, des captures d’écran, etc., plutôt qu’un résumé apparemment raisonnable généré par l’IA.
Osmani a également proposé que les développeurs demandent à l'agent de lister clairement les décisions qu'il a prises de manière autonome lors de l'exécution de la tâche, les hypothèses qu'il a adoptées et les conditions qu'il a ignorées, car ces contenus n'apparaissent généralement pas dans le résumé final du travail.
À mesure que l'IA est capable d'effectuer de plus en plus de tâches simultanément, un autre problème commence à surgir. Osmani appelle cela une
"taxe d'orchestration"
(Taxe d'Orchestration), c'est-à-dire l'écart entre la vitesse à laquelle l'IA génère des résultats et la vitesse à laquelle les humains peuvent les examiner attentivement et être prêts à en assumer la responsabilité.Lorsque les résultats du travail générés par l'IA continuent de s'accumuler et que les humains n'ont plus assez de temps pour les examiner, continuer à augmenter le nombre d'agents ne résoudra pas le problème. Il estime que dans ce cas, l'équipe devrait améliorer le mécanisme de vérification automatique ou réduire de manière appropriée la vitesse de génération des tâches.
Osmani a également averti que
le degré élevé d'automatisation de l'IA pourrait amener les humains à abandonner progressivement la pratique de leurs compétences d'origine.
Il recommande aux développeurs d'essayer d'écrire du code sans utiliser l'IA chaque semaine, de revoir les compétences qu'ils ont cessé de pratiquer chaque mois et de juger quelles capacités valent encore la peine d'être conservées.Il a également cité les recherches d'Anthropic sur l'utilisation de l'IA par les ingénieurs et chercheurs internes, soulignant qu'il existe un « paradoxe de la supervision » : superviser Claude nécessite des capacités de programmation, mais une utilisation excessive de l'IA peut dégrader ces capacités.
Osmani a souligné que ces points de vue ne signifient pas que l'utilisation de l'IA devrait être réduite. Il n’y a aucun problème dans les tâches où le coût de l’erreur est faible, entièrement confié à l’IA, mais lorsqu’il s’agit d’investissements, de choix de carrière, de sécurité des produits ou de décisions majeures qui affectent d’autres personnes, les humains devraient toujours conserver des droits de jugement clés.
Selon lui, les futurs modèles d'IA pourraient être plus efficaces que les humains pour détecter les erreurs, mais cela n'élimine pas la responsabilité humaine.
Décider quels produits développer, pourquoi ils valent la peine d'être développés, sur qui ils impacteront et quel prix ils sont prêts à payer pour cela nécessite toujours des choix humains.
Il a conclu à la fin de l'article : "
Vous pouvez confier le travail et la plupart des tâches de révision à AI, mais vous ne pouvez pas également en confier la responsabilité.
»
Commentaires