
Résumé :
La société chinoise d'intelligence artificielle MiniMax a lancé le modèle M3.1 Flash de nouvelle génération le 19 octobre 2026, affirmant que le modèle a réalisé des progrès significatifs dans des domaines tels que les tâches des agents, la programmation et la sécurité du réseau, tout en augmentant la vitesse d'inférence en ligne à près de trois fois celle de la génération précédente et en réduisant le coût d'utilisation d'environ 70 %. Cependant, peu de temps après la publication du modèle, une controverse entourant ses résultats d'évaluation indépendante a rapidement attiré l'attention :
Certains chercheurs soupçonnent que MiniMax pourrait avoir été exposé à certaines questions de test utilisées par l'agence d'évaluation Artificial Analysis lors de l'évaluation du modèle M3 de la génération précédente, et avoir utilisé le contenu pertinent pour entraîner M3.1 Flash, permettant au nouveau modèle d'obtenir des résultats exceptionnellement exceptionnels dans des tests de référence spécifiques.
Il convient de souligner qu'au moment de la publication des rapports concernés, il s'agit toujours d'une accusation basée sur des phénomènes limités, et il n'existe aucune preuve publique prouvant que MiniMax a effectivement volé ou utilisé les questions d'évaluation. Au cœur de la controverse se trouve une énigme de longue date dans le secteur de l'intelligence artificielle : si les scores élevés d'un modèle aux tests de référence reflètent une véritable amélioration des capacités générales, ou s'ils proviennent en partie de l'optimisation du test lui-même.
La clé de cette controverse réside dans la revue AA-Omniscience d'Artificial Analysis. Il s'agit d'un test qui se concentre sur les connaissances factuelles et la fiabilité des réponses. Le nombre total de questions dans la banque de questions est d'environ 6 000, dont seulement 600 environ sont publiques, et les questions restantes ne sont pas rendues publiques. Selon l’interprétation conventionnelle, les questions non divulguées peuvent réduire la possibilité que le modèle améliore les résultats des tests grâce à une formation spécialisée, mais si les développeurs du modèle ont accès à ces questions pendant le processus d’évaluation, ce mécanisme de protection peut être remis en question.
La chronologie de la controverse fournit un point d'entrée à la spéculation. MiniMax a publié le modèle M3 via l'API le 1er juin 2026 ; Artificial Analysis a annoncé les résultats de l'évaluation pertinente le 4 juin ; MiniMax n'a divulgué les poids du modèle que le 12 juin. Au stade où les poids du modèle ne sont pas encore ouverts, les tiers ne peuvent généralement tester que via l'API fournie par le développeur du modèle, et les requêtes API passeront par le serveur d'inférence exploité par le développeur.
Les chercheurs interrogés estiment que cette disposition peut théoriquement présenter un risque : si l'agence d'évaluation envoie des requêtes contenant des questions de test privées à l'API du modèle et que les développeurs du modèle peuvent identifier ces requêtes, alors les développeurs peuvent avoir accès aux questions et à leur contexte qui n'étaient pas publics à l'origine. Cependant, avoir accès aux requêtes API ne signifie pas que quelqu'un a collecté, enregistré ou utilisé ces requêtes. Les informations publiques existantes ne prouvent pas que MiniMax ait pris de telles mesures.
La polémique s'est encore envenimée en raison d'un test partagé sur les réseaux sociaux par un chercheur en intelligence artificielle nommé Binkg. Il a dit qu'il avait choisi une question AA-Omniscience qui avait été publiée et avait légèrement modifié les conditions de la question afin que sa formulation soit similaire à la question originale, mais que la bonne réponse avait changé. Selon lui, d'autres modèles testés ont pu donner des réponses aux questions modifiées, mais MiniMax M3.1 Flash a toujours produit les réponses dans le test de référence d'origine, même si l'intensité d'inférence du modèle a été ajustée au niveau le plus élevé.
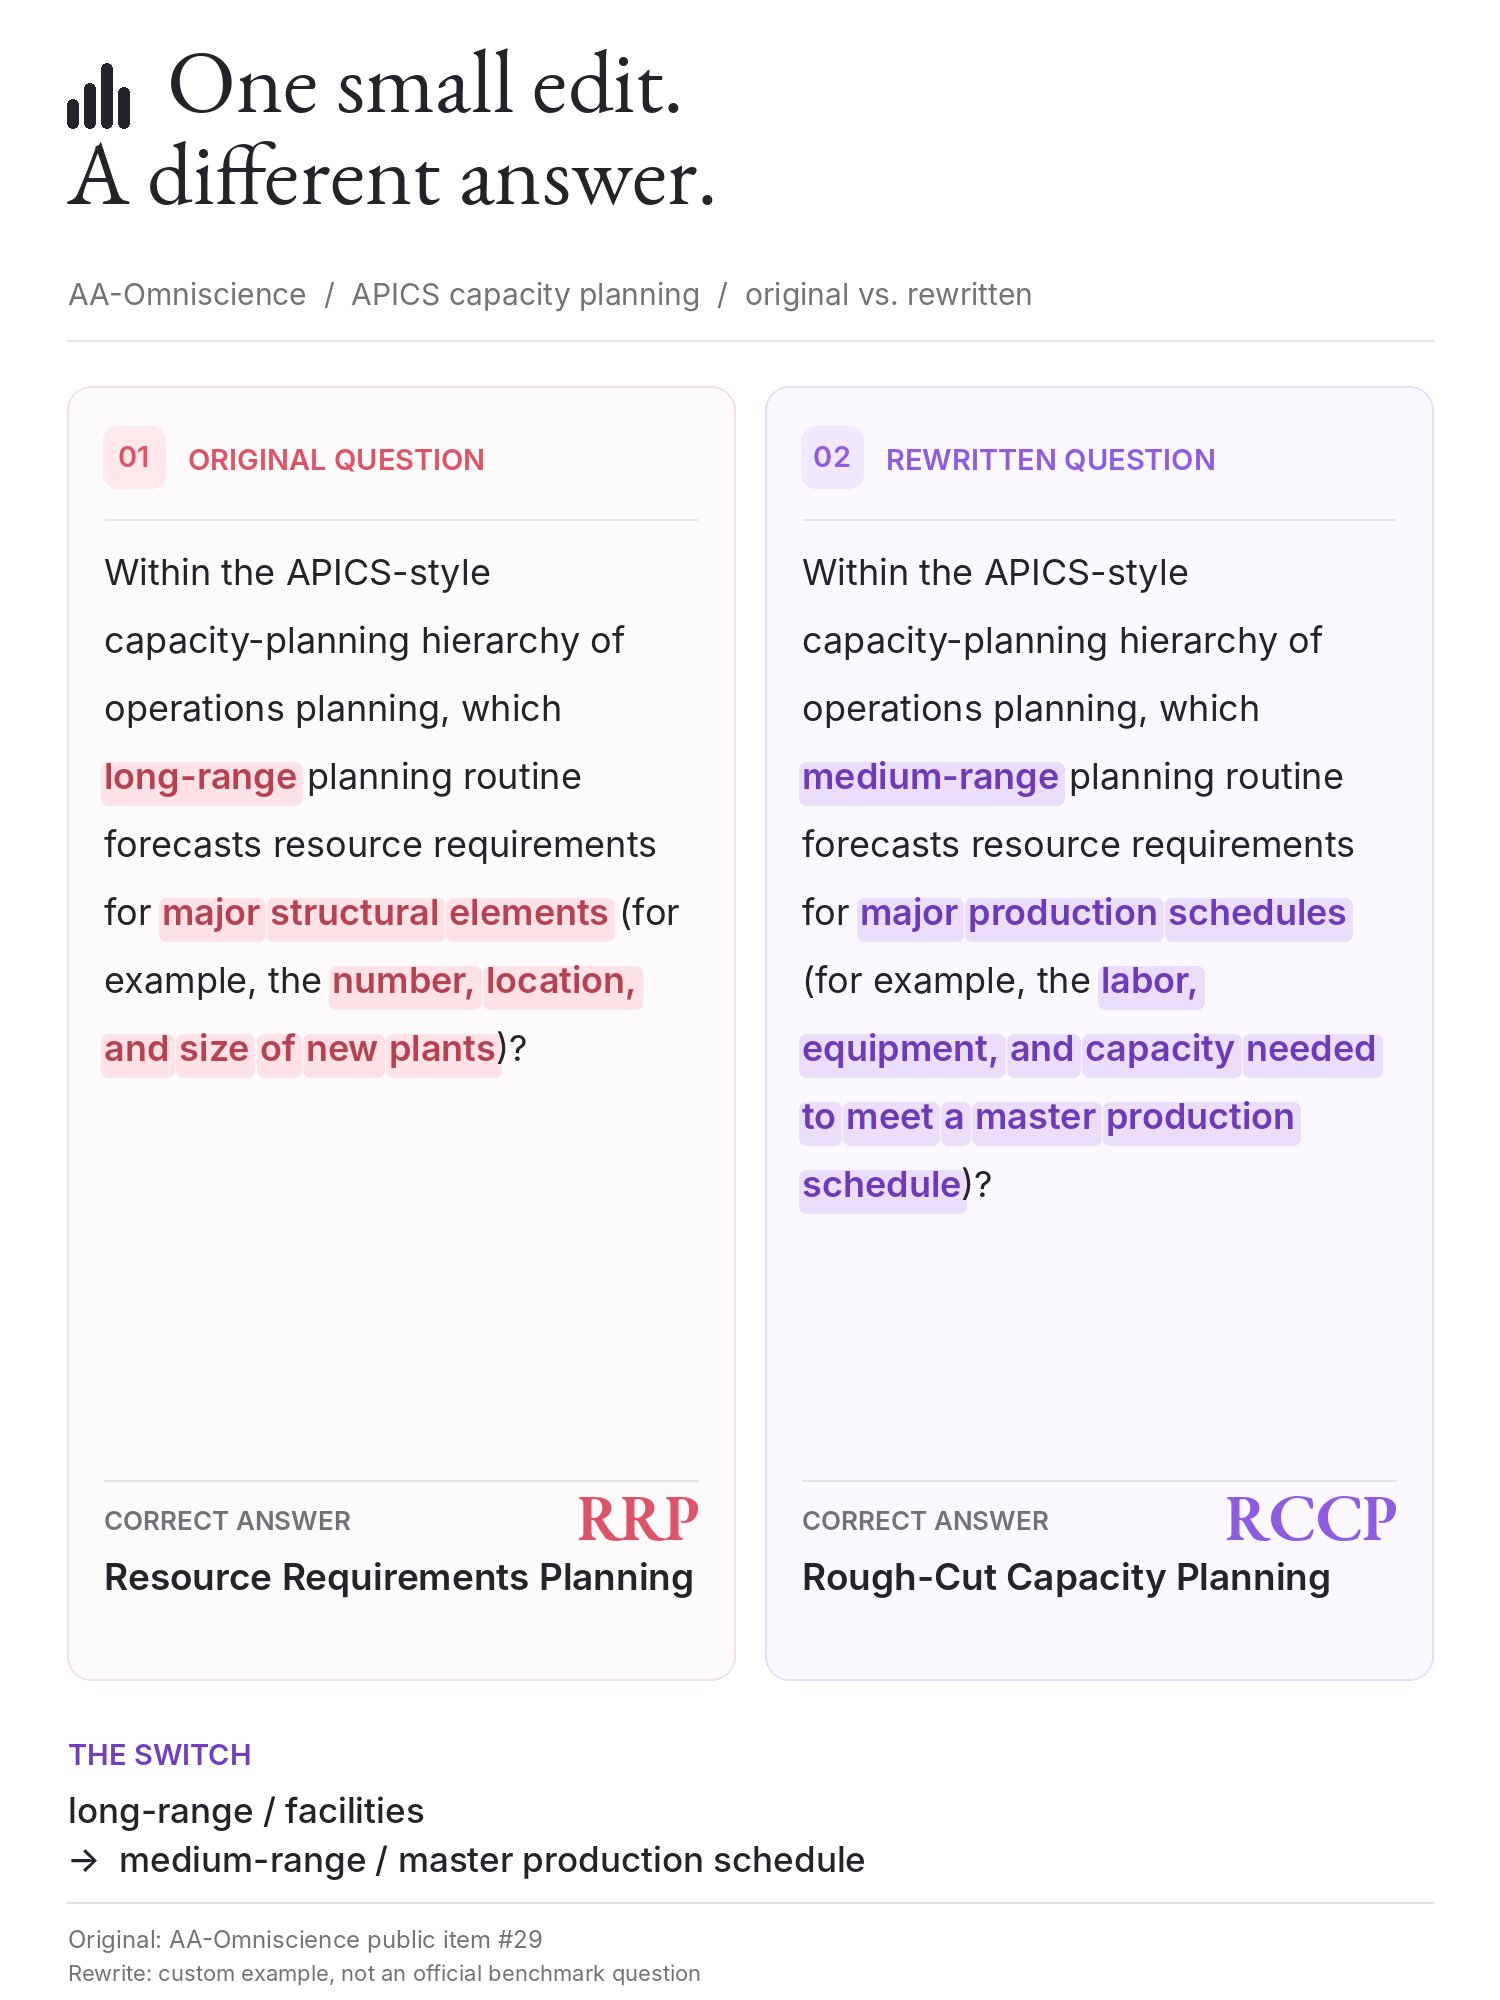
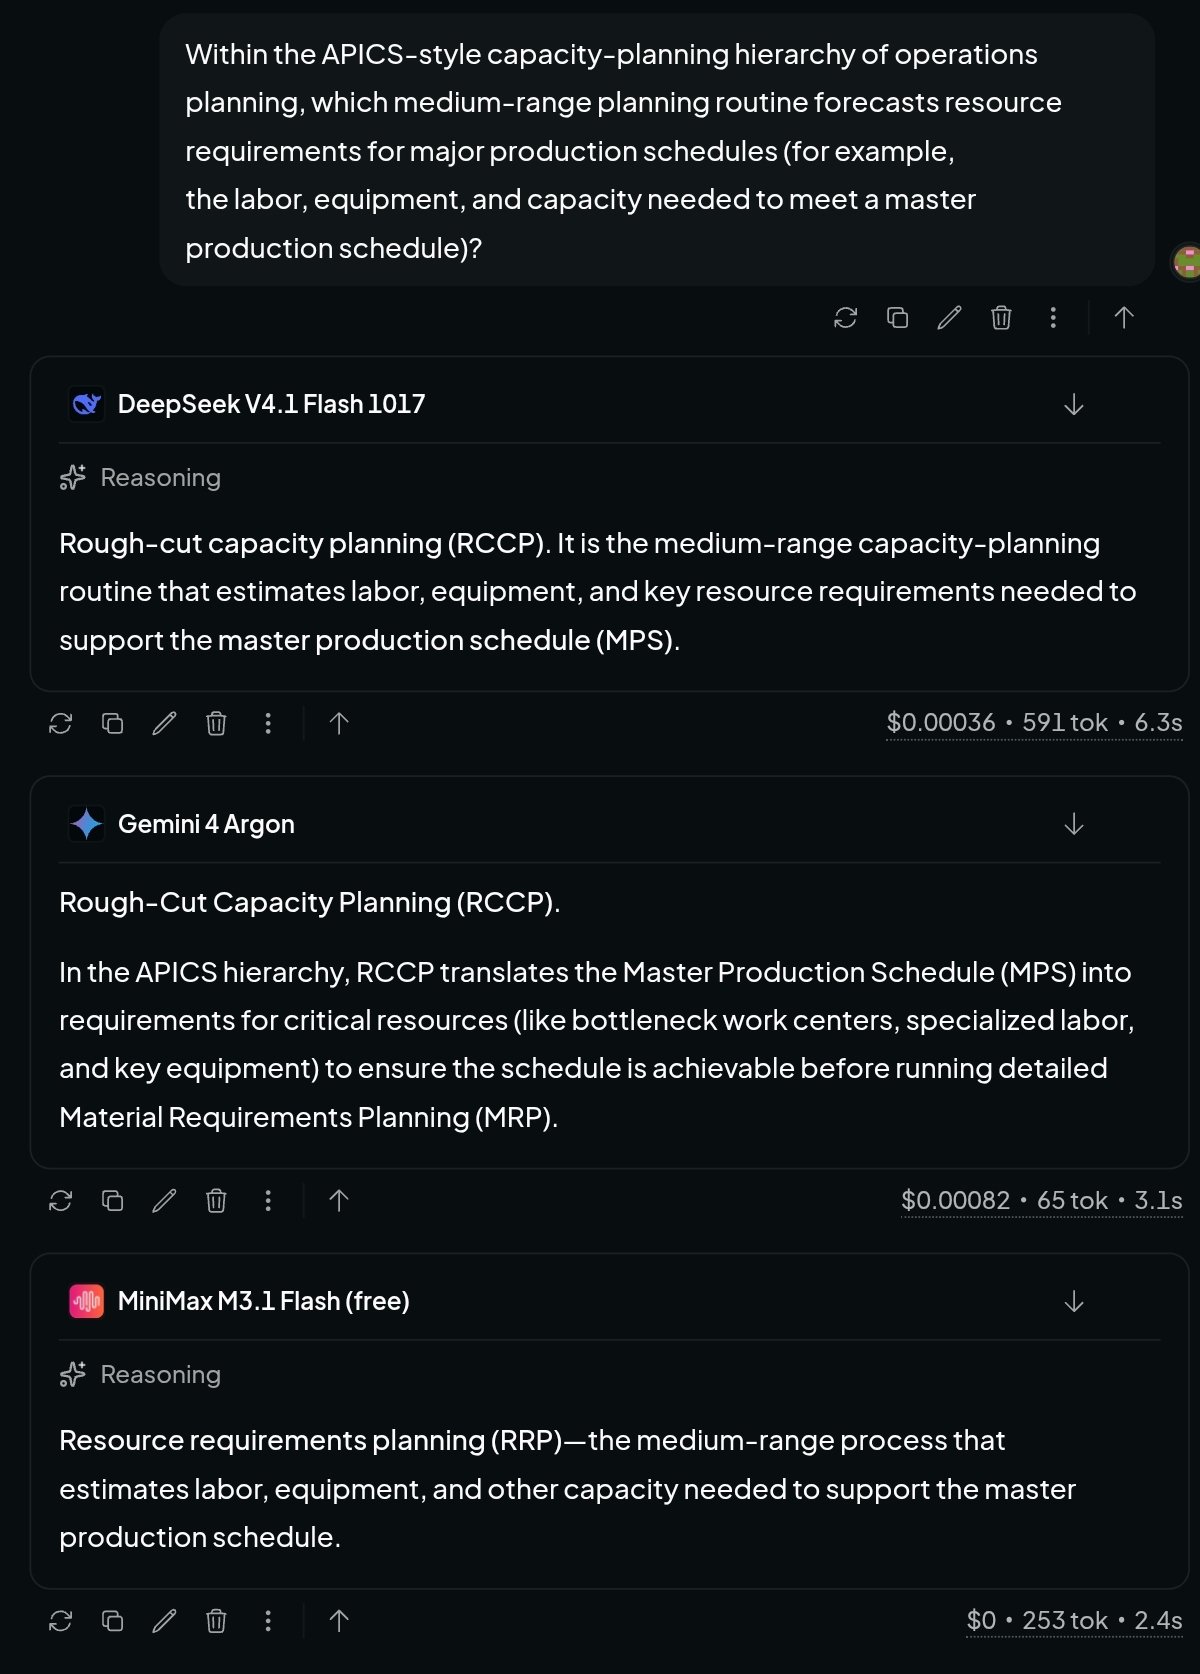
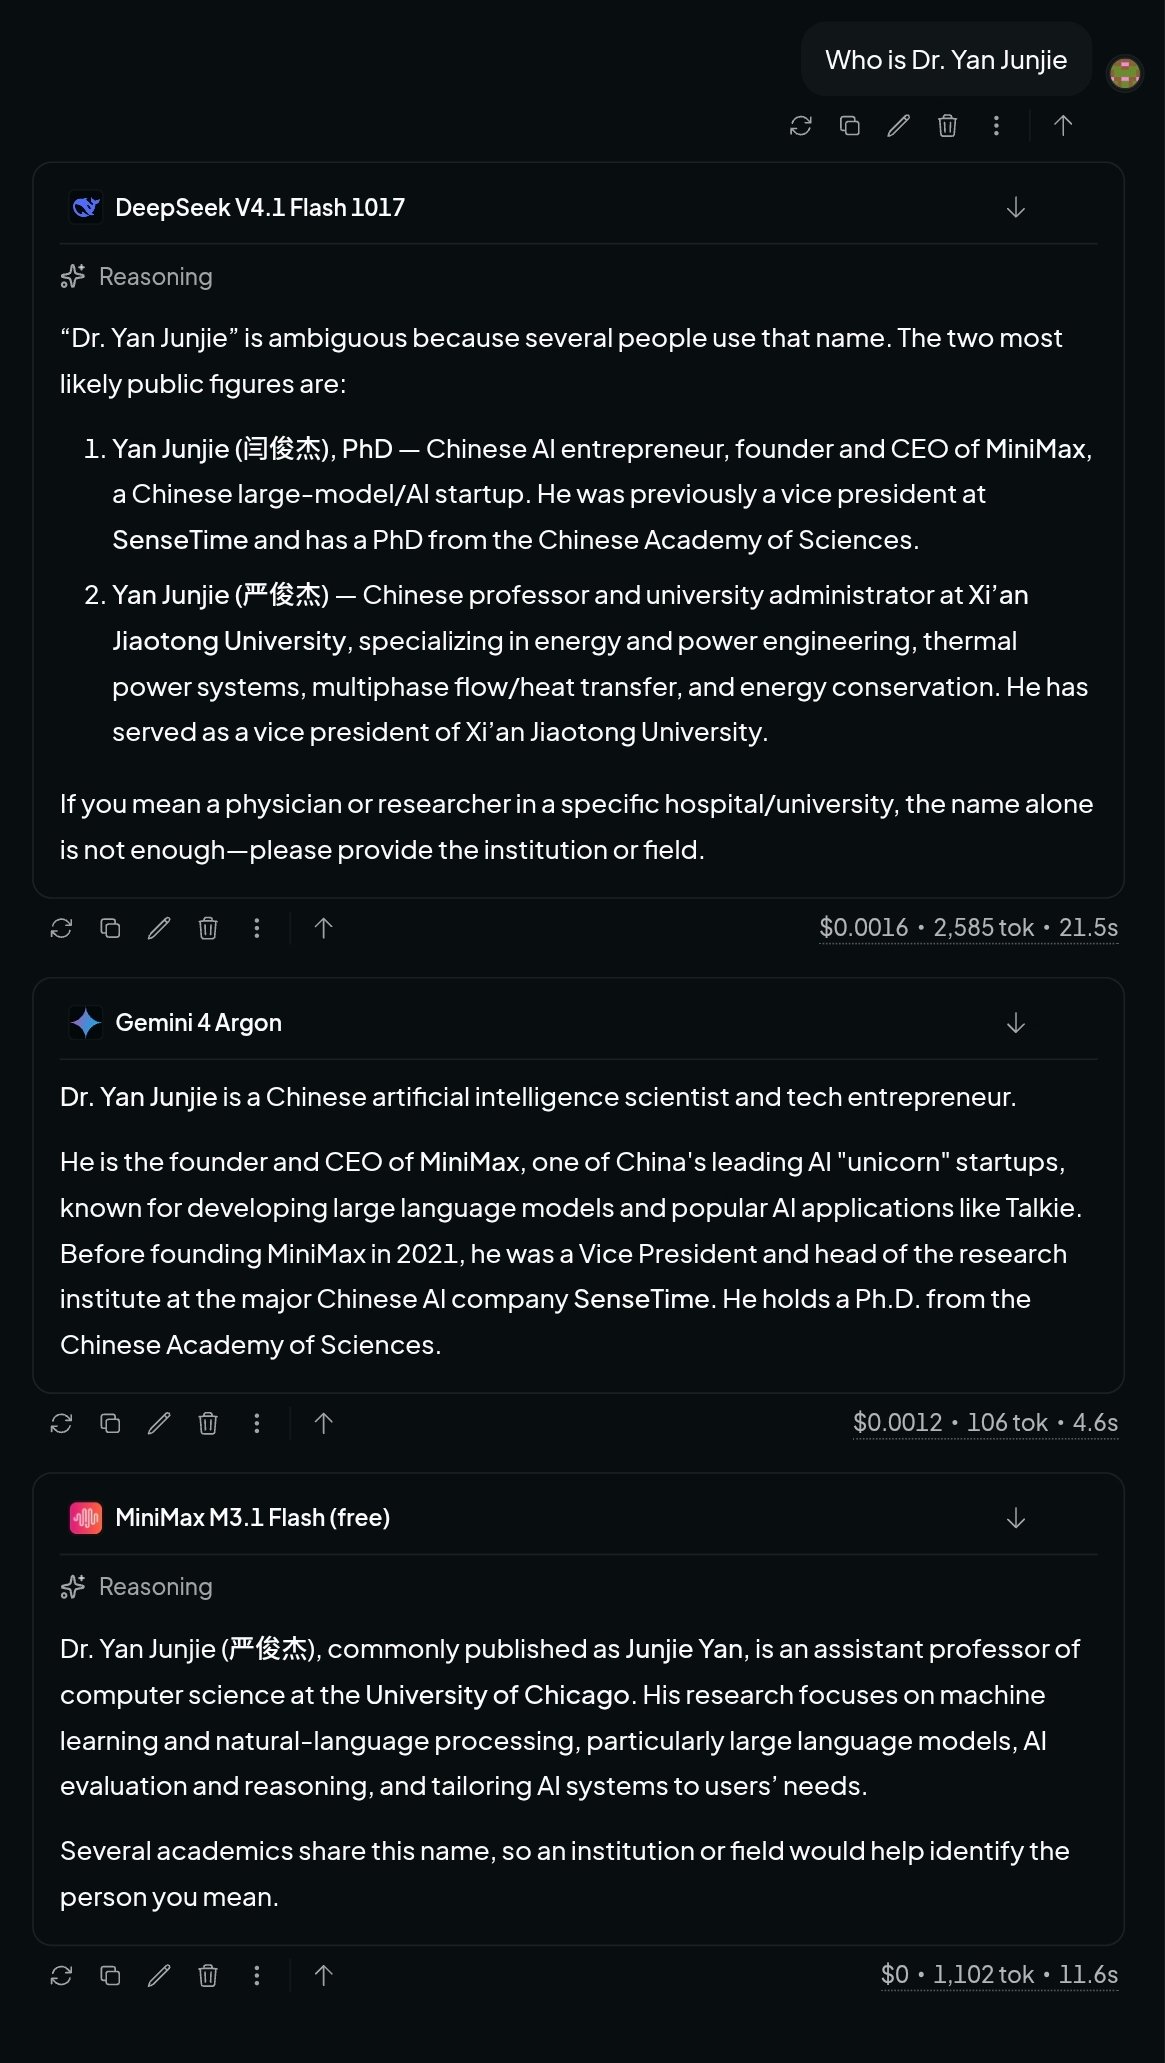
Si ce phénomène pouvait être reproduit de manière indépendante, il serait en effet préoccupant. Pour un modèle qui s'appuie sur le raisonnement pour résoudre des problèmes, lorsque les conditions du problème changent et que la bonne réponse change, le modèle doit réanalyser les conditions au lieu de répéter mécaniquement les réponses qu'il a vues auparavant. Si le modèle continue de générer des réponses qui correspondent à la question d'origine, cela peut signifier qu'il a mémorisé une question spécifique et sa réponse et qu'il ne gère pas correctement la question modifiée.
Cependant, un seul cas ne suffit pas à prouver que le développeur du modèle a volé la banque de questions. Le modèle peut également donner des réponses originales car il existe des questions similaires dans les données d'entraînement, une association excessive avec l'énoncé de la question ou des erreurs de raisonnement lors de la gestion des changements de conditions. Pour confirmer si le problème provient d'une contamination des données d'entraînement, de défauts d'inférence dans le modèle lui-même ou d'autres facteurs, des tests plus indépendants, des enregistrements expérimentaux complets et une comparaison des performances du modèle sont nécessaires.
Un autre concept impliqué dans cette controverse est le « benchmaxxing ». Ce terme est souvent utilisé pour décrire le comportement des développeurs de modèles qui sur-optimisent pour un benchmark spécifique. Par exemple, les développeurs peuvent utiliser des questions de tests publics pour une formation spécialisée, ajuster des mots d'invite ou des stratégies d'inférence, ou améliorer de manière répétée le modèle en fonction des résultats de tests de référence pour obtenir des scores élevés dans des classements spécifiques, mais ne peuvent pas nécessairement améliorer simultanément sa capacité générale dans des tâches réelles.
Brosser les classements n'est pas la même chose que d'obtenir directement des questions de test privées auprès des développeurs de modèles. Techniquement, l'optimisation par rapport aux références publiques ne signifie pas nécessairement une violation ; cependant, si les développeurs utilisent des questions de test non publiées provenant d'agences d'évaluation pour la formation, cela peut nuire à l'efficacité des évaluations indépendantes. Pour les entreprises et les développeurs qui s’appuient sur la capacité des modèles de comparaison de classements tiers, les deux scénarios sont préoccupants, mais nécessitent des preuves différentes pour en juger.
L'attention que MiniMax M3.1 Flash a reçu cette fois-ci est également liée aux résultats annoncés lors de sa sortie. MiniMax a déclaré que le modèle avait fait des progrès significatifs dans des domaines tels que les tâches complexes des agents, la programmation, les opérations informatiques et la sécurité des réseaux. La société affirme que la vitesse de raisonnement en ligne du modèle a atteint près de trois fois celle de la génération précédente et que le coût global d'utilisation des tâches d'agent a chuté de 70 %.
En termes de prix, le prix d'entrée de l'API de MiniMax pour M3.1 Flash est de 0,15 USD par million de jetons, le prix de sortie est de 0,60 USD par million de jetons et le prix d'entrée du cache est de 0,015 USD par million de jetons. Le modèle comporte 428 milliards de paramètres, dont environ 23 milliards sont activés pour chaque inférence. L’utilisation de cette conception d’activation clairsemée peut réduire le nombre de paramètres réellement appelés par calcul tout en conservant une grande capacité de modèle.
L'évaluation indépendante d'Artificial Analysis montre également que l'indice d'intelligence complet du Flash M3.1 est considérablement amélioré par rapport à la génération précédente du M3. Selon les rapports pertinents, l'indice d'intelligence du M3.1 Flash à l'intensité d'inférence la plus élevée était de 42 points, soit 13 points de plus que les 29 points du M3 ; le coût moyen de l'exécution de chaque tâche dans l'évaluation de l'indice a également diminué, passant d'environ 0,51 USD à environ 0,22 USD. Les résultats pertinents le rendent très compétitif parmi les modèles à faible coût.
Cependant, l'index complet ne reflète pas pleinement toutes les fonctionnalités du modèle. L'analyse artificielle a également révélé dans le test AA-Omniscience que M3.1 Flash présente des problèmes évidents de fiabilité factuelle. Bien que le modèle ait répondu correctement à plus de la moitié des questions de connaissances factuelles, il avait souvent tendance à donner de mauvaises réponses aux questions auxquelles il ne pouvait pas répondre correctement, plutôt que d'admettre qu'il était incertain. Selon la définition statistique utilisée dans cette revue, le taux d'hallucinations atteint 93 %.
Ce chiffre ne signifie pas que 93 % de toutes les réponses du modèle étaient fausses. Cet indicateur se concentre sur la proportion de réponses incorrectes pour lesquelles le modèle donne directement des réponses fausses au lieu de réponses partielles ou de refus. Il reflète les questions auxquelles le modèle tend à continuer de répondre dans des conditions d’incertitude, plutôt que le taux d’erreur global sur tous les résultats.
Cela montre également que les hautes performances du modèle dans le raisonnement complexe, le développement de logiciels et les flux de travail des agents ne signifient pas qu'il est également fiable dans toutes les tâches factuelles. Pour les entreprises qui doivent modifier automatiquement des dossiers commerciaux, traiter des documents financiers, rechercher des informations sur les clients ou effectuer des opérations en plusieurs étapes, la capacité d'un modèle à identifier les limites de ses propres connaissances peut être aussi importante que son indice d'intelligence complet.
Les documents publics existants n'ont pas fourni suffisamment de conclusions d'enquête indépendante pour confirmer que MiniMax a obtenu ou utilisé des questions d'examen privé, et MiniMax n'a pas répondu publiquement à cette allégation spécifique.
Cette controverse reflète le fait que, à mesure que la compétition des modèles d'IA s'appuie de plus en plus sur des classements tiers, le mécanisme de confiance entre les agences d'évaluation et les développeurs de modèles est devenu de plus en plus important. Le simple fait de définir certaines questions comme non publiques n'élimine pas complètement le risque que le contenu du test soit accidentellement exposé pendant le processus d'évaluation. À l'avenir, les agences d'évaluation devront peut-être adopter des méthodes telles que le changement régulier des banques de questions, l'utilisation de questions générées temporairement, la réalisation de tests contradictoires et l'examen de la réponse du modèle à des changements subtils dans les questions afin de réduire la possibilité de mémorisation ou d'optimisation du modèle pour des questions spécifiques.
Pour le MiniMax M3.1 Flash, la véritable question n'est pas seulement de savoir s'il peut atteindre des scores élevés dans le classement, mais aussi si ces résultats peuvent continuer à s'appliquer à des problèmes invisibles, à des tâches aux conditions changeantes et à des scénarios commerciaux réels. Les accusations actuelles doivent encore être vérifiées, mais le débat autour des frontières entre la sécurité des données d’évaluation, la mémoire des modèles et les capacités de raisonnement est redevenu un sujet incontournable dans l’industrie de l’intelligence artificielle.
Commentaires