Résumé :
DeepSeek a également rejoint le concours de paramètres. Selon The Information, DeepSeek entraîne actuellement un nouveau modèle avec environ 2 000 milliards de paramètres ; Liang Wenfeng a également déclaré lors d'une récente réunion d'investisseurs que la prochaine étape de l'entreprise serait de continuer à pousser le modèle jusqu'à 8 000 milliards de paramètres. Il y a un an, 8 000 milliards représentaient encore un chiffre inimaginable.
Mais maintenant, Kimi K3 a atteint 2,8 billions de paramètres ; Byte pré-entraîne un nouveau modèle pouvant atteindre jusqu'à 10 000 milliards de paramètres ; Alibaba a également déclaré publiquement que le modèle de nouvelle génération atteindrait 5 000 à 10 000 milliards de paramètres. Anthropic ne divulgue pas les paramètres du modèle, mais FT a précédemment cité des estimations de l'industrie selon lesquelles son dernier produit phare, Mythos 5, comporte environ 8 000 milliards de paramètres.
Le grand mannequin a tourné en rond et a recommencé à concourir pour voir qui était le plus grand.
Cette fois-ci, les paramètres déployés par tout le monde ne sont plus les mêmes que lors du cycle de mise à l'échelle précédent.
Lorsque DeepSeek a lancé V4-Pro en avril de cette année, l'échelle officiellement divulguée était de 1,6 billion de paramètres totaux et de 49 milliards de paramètres d'activation.
Le plan de suivi est de 8 000 milliards de RMB, ce qui équivaut à 5 fois celui de V4-Pro.
C'est en fait assez inhabituel lorsqu'il s'agit de DeepSeek. Après tout, DeepSeek a laissé l’année dernière l’impression la plus profonde sur l’ensemble du secteur de l’IA, pas en termes de paramètres.
Cela a un jour amené l'industrie de l'IA à rediscuter que les modèles de pointe n'avaient peut-être pas besoin de graver le GPU à l'infini.
Lorsque la V3 sortira fin 2024, DeepSeek met délibérément sur la table la facture de la formation : 671 milliards de paramètres au total, 37 milliards de paramètres activés par Token, et une formation complète consomme 2,788 millions d'heures GPU H800. Calculé à 2 USD par heure GPU, le coût officiel de la formation n’est que de 5,576 millions USD.
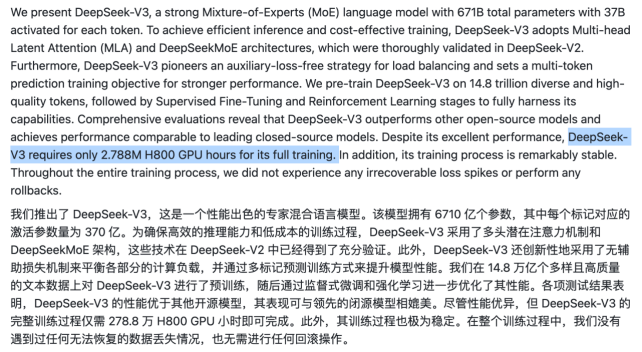
Ce numéro, et l'efficacité qui le sous-tend, est devenu plus tard l'un des labels les plus importants pour DeepSeek.
DeepSeek ne dispose pas d'une offre abondante de GPU avancés comme OpenAI et Anthropic ; l’entreprise s’appuie depuis longtemps sur Huanfang de Liang Wenfeng pour quantifier son auto-transfusion et n’accepte pas de financement externe. Ses conditions déterminent son itinéraire : puisque l’argent et la puissance de calcul sont limités, les performances doivent être maximisées grâce à l’architecture, à la formation et à l’efficacité de l’inférence.
Mais maintenant, les conditions ont changé.
DeepSeek vient de finaliser sa première ronde de financement externe depuis sa création en juin de cette année, levant environ 7,4 milliards de dollars. Actuellement, le deuxième cycle de financement d'environ 50 milliards de RMB (environ 7,5 milliards de dollars) est entré dans la phase de finalisation, correspondant à une valorisation d'environ 500 milliards de RMB. Si ce financement est réalisé avec succès, le financement externe cumulé de DeepSeek atteindra près de 15 milliards de dollars américains et environ 100 milliards de yuans d'ici quelques mois.
Dans le même temps, DeepSeek a embauché CITIC Securities pour préparer l'introduction en bourse du Conseil de l'innovation scientifique et technologique, et le nouveau capital sera clairement utilisé pour l'infrastructure informatique, le développement de modèles et l'investissement dans les talents ; Le 21 septembre, Yan Wentao, un ancien partenaire de Hillhouse Venture Partners, a officiellement rejoint DeepSeek et a occupé le poste de CFO, mettant ainsi fin au poste de CFO vacant au cours des trois années écoulées depuis la création de la société.
Dans le passé, DeepSeek utilisait des moyens financiers et une puissance de calcul limités pour rendre le modèle aussi performant que possible ; maintenant, le financement et la cotation sont accélérés. Avec plus d’argent en main, la puissance de calcul peut également être augmentée.
Une fois les conditions remplies, DeepSeek commence également à déployer les paramètres avec audace.
Cela n’entre pas en conflit avec la recherche de l’efficacité. Lorsque l’efficacité est élevée, l’échelle peut être étendue avec le même argent.
Au cours des deux derniers mois, l'échelle totale des paramètres des modèles de pointe a considérablement augmenté.
La face cachée de la Lune remet cette compétition sous le feu des projecteurs. En juillet de cette année, Kimi K3 a atteint 2,8 billions de paramètres totaux et 104 milliards de paramètres d'activation. Le K3 reste le modèle de poids ouvert doté de la plus grande échelle de paramètres officiellement publiée.
Ce n'est pas seulement grand. Dans l'évaluation officielle, le GPQA Diamond de K3 a atteint 93,5 et Terminal-Bench 2.1 a atteint 88,3, ce qui est très proche de GPT-5.6 Sol et Claude Fable 5 au cours de la même période. L'échelle a atteint des milliards et la performance a atteint le premier échelon.
En août, il a été révélé que Byte prévoyait de devenir plus grand.
Le 6 août, "LatePost" a révélé pour la première fois que Byte discutait de la formation d'un nouveau modèle avec plus de 5 000 milliards de paramètres, dirigé par Xiang Liang, directeur de la Seed Foundation. Selon les rapports, Byte semble croire en interne qu'au lieu de continuer à rattraper la taille existante, il est préférable de pousser l'échelle des paramètres plusieurs fois plus haut que celle de ses pairs à la fois.
Un jour plus tard, le 7 août, FT a rapporté, citant des personnes proches du dossier, que l'échelle du nouveau modèle pré-entraîné par Byte pourrait atteindre jusqu'à 10 000 milliards de paramètres ; Lorsque Reuters a effectué un suivi, il l'a également comparé au Mythe d'Anthropic, un ouvrage de pointe d'Anthropic - bien que ce dernier n'ait jamais divulgué l'échelle des paramètres, les estimations de l'industrie ont atteint environ 8 000 milliards. Si le nouveau modèle de Byte atteint 10T, il dépassera l'échelle actuellement diffusée par Mythos.
Maintenant, des quantités de paramètres extrêmement importantes, supérieures à 5 T, ont commencé à apparaître à plusieurs reprises dans les discussions sur les modèles de pointe.
Aujourd'hui, le PDG d'Alibaba, Wu Yongming, a annoncé publiquement que le modèle de nouvelle génération prévoit d'atteindre 5 000 à 10 000 milliards de paramètres ; DeepSeek forme un modèle 2T tout en fixant l'objectif de suivi à 8T. On peut comprendre que le laboratoire principal a une fois de plus considéré une échelle de paramètres totaux plus grande comme un moyen important d'influencer la limite supérieure des capacités.
Même les modèles américains de sources fermées qui ne divulguent pas de paramètres ne peuvent échapper à un examen extérieur. Le mythe d'Anthropic est estimé à 8T par des étrangers ; OpenAI n'a plus divulgué l'échelle du modèle depuis l'ère GPT-4, mais il y a une rumeur dans la communauté selon laquelle Astra a atteint un MoE de 10T.
Le nombre de paramètres n'a jamais perdu de son attrait, tout comme la valeur de la puissance de combat sur le panneau de jeu - les gens savent qu'il ne peut pas tout représenter, mais ce sera toujours le nombre le plus intuitif et le plus oppressant.
En fait, la grande industrie du modélisme n'aime plus beaucoup parler de paramètres depuis un certain temps.
Au cours des deux dernières années, la distillation, les petits modèles, le MoE, l'apprentissage par renforcement et les calculs de temps d'inférence se sont succédé. Plutôt que de montrer qu’ils disposent de centaines de milliards, voire de milliards de paramètres, les fabricants de modèles sont plus disposés à parler de performances, de coûts et d’efficacité. En agrandissant simplement le modèle, vous donnerez facilement l'impression que vous avez de l'argent mais pas d'endroit où le dépenser.
Aujourd'hui, les quantités de paramètres ont encore été augmentées et sont redevenues la « façade » des modèles de pointe.
Cependant, les 5T, 8T et 10T d'aujourd'hui ne sont plus la même chose que "plus de paramètres, plus le modèle est grand" lors du cycle de mise à l'échelle précédent.
La raison la plus directe pour laquelle les quantités de paramètres peuvent être remises sur la table est que l'architecture dominante des modèles ultra-larges a changé.
Dans le passé, le courant dominant des grands modèles était l'architecture Dense, où l'échelle des paramètres et la quantité de calcul étaient essentiellement liées. En termes simples, cela signifie combien de paramètres il y a dans le modèle, et ils doivent essentiellement être saisis ensemble dans chaque calcul. Plus il y a de paramètres, plus la limite supérieure des capacités tend à être élevée, mais le coût de la formation et de l’inférence augmente également.
De nos jours, de plus en plus de grands modèles utilisent MoE, Mixture of Experts et une architecture experte mixte.
Il s'agit plutôt d'une entreprise avec de nombreux experts. Le modèle peut compter des centaines ou des milliers d’experts, mais seule une petite partie d’entre eux est sélectionnée pour travailler sur chaque tâche. Par exemple, Kimi K3 a 2,8T de paramètres au total, mais chaque jeton n'active que 104B, soit environ 3,7% ; DeepSeek V4-Pro a 1,6T de paramètres au total et chaque jeton n'en active que 49B, soit environ 3%.
Ainsi, aujourd'hui, si un modèle a des paramètres 5T, 8T ou même 10T, cela ne signifie pas qu'il doit parcourir ces paramètres 10T à chaque fois qu'il génère un Token.
La quantité que le modèle peut contenir et la quantité qui doit être calculée à chaque fois sont devenues deux nombres différents.
Les paramètres peuvent être compris comme l'espace utilisé par le modèle pour transporter des connaissances, des modèles et des capacités. Plus le total des paramètres est grand, plus le modèle dispose théoriquement d'espace pour apprendre des distributions de plus en plus complexes ; Le MoE lui permet de n’en appeler que certains en cas de besoin.
En conséquence, le modèle peut continuer à augmenter la capacité totale des paramètres sans alourdir chaque calcul d'une année sur l'autre.
En prenant toujours K3 comme exemple, il a un paramètre total de 2,8T, soit environ trois fois l'échelle de K2.5, mais parmi 896 experts, seuls 16 de chaque jeton sont activés. Dark Side of the Moon a déclaré que grâce à un MoE plus clairsemé et à une série d'optimisations architecturales, l'efficacité globale de mise à l'échelle de K3 a été améliorée d'environ 2,5 fois par rapport à K2.
L'ère Agent vient de repousser cette « capacité » au centre de la compétition.
Dans le passé, les capacités d'un chatbot étaient souvent mesurées une par une. Les mathématiques examinent les mathématiques, le code examine le code et les questions et réponses examinent les connaissances. Si le modèle atteint des sommets plus élevés sur plusieurs benchmarks clés, cela suffit à prouver qu’il est très solide.
Mais l'agent regroupe ces fonctionnalités dans la même chaîne de tâches. Une tâche très longue peut commencer par rechercher des informations, puis lire des pages Web, regarder des images, écrire du code, appeler le terminal, puis rencontrer des erreurs, modifier le plan, appeler d'autres outils et même attribuer des sous-tâches à d'autres agents.
Lorsque OpenAI a publié l'API Agents en septembre de cette année, il a directement répertorié l'exécution à long terme, la gestion du contexte, l'utilisation des outils et la coordination des sous-agents comme l'infrastructure de base de l'agent, et a souligné que l'agent doit fonctionner de manière fiable pendant des heures, voire des jours.
Dans une séance de questions-réponses, si une certaine capacité échoue occasionnellement, une seule question peut être perdue ; dans une tâche Agent impliquant des dizaines ou des centaines d'étapes, tout maillon faible peut interrompre l'intégralité du lien. Plus la tâche est longue, plus les exigences en matière de couverture capacitaire et de stabilité sont élevées. En conséquence, la concurrence frontalière a commencé à avoir un « effet baril » évident.
METR utilise désormais directement la « durée de la tâche » pour mesurer les capacités de l'agent, car plus la tâche est longue, plus il est nécessaire que le modèle exécute en continu une série d'opérations différentes.
À l'ère des Chatbots, il est plus facile de voir le pic des capacités, tandis qu'à l'ère des Agents, la couverture des capacités est de plus en plus importante.
À l'heure actuelle, une plus grande capacité de paramètres a une nouvelle valeur. Plus la tâche est longue, moins le modèle doit être biaisé ; plus l'agent peut faire de choses, plus les capacités que la base doit couvrir sont larges.
Le MoE ouvre la voie à une expansion continue de la capacité, et l'Agent amplifie encore la valeur de la capacité. Par conséquent, les fabricants de modèles font de leur mieux pour améliorer l’efficacité tout en repoussant les paramètres à 5T, 8T et 10T.
La puissance de calcul économisée n'a pas fait disparaître Scaling, mais a plutôt créé un nouvel espace pour Scaling.
Commentaires