
Résumé :
Au cours des derniers mois, OpenAI et Anthropic ont tour à tour fait avancer leurs modèles phares, mais Google semblait inhabituellement silencieux. Flash est mis à jour presque toutes les trois semaines, les versions 3.6, 3.7 et 3.8 progressant continuellement, mais il n'y a eu aucun mouvement pour Pro, qui représente la limite de capacité la plus élevée. Jusqu'à ces deux jours, un modèle portant le nom de gemini-3.8-flash est soudainement apparu dans l'arène de test à l'aveugle des grands modèles Arena.
Dès que les développeurs ont commencé, ils ont remarqué que quelque chose n'allait pas. Le vrai Gemini 3.8 Flash est sorti. Tout le monde sait à quel niveau cela devrait être. Mais avec ce "Flash 3.8", les performances d'écriture de code, de création de SVG et d'exécution d'Agent ont évidemment grimpé d'un cran.
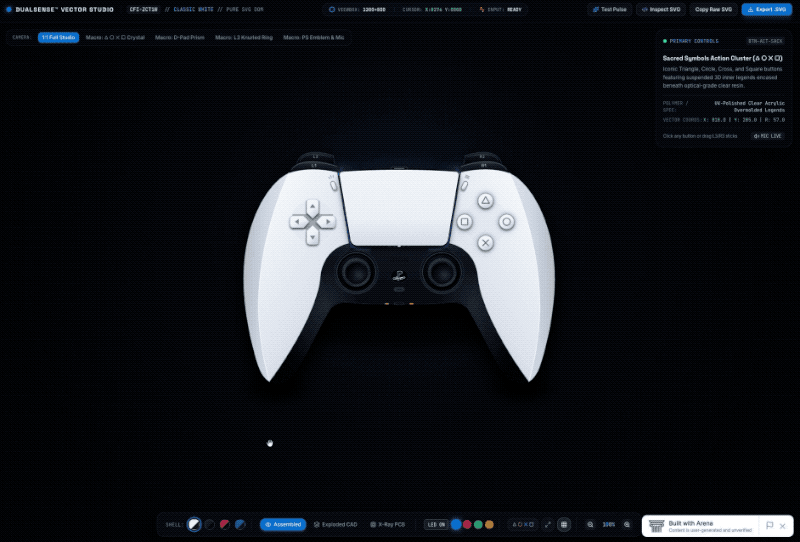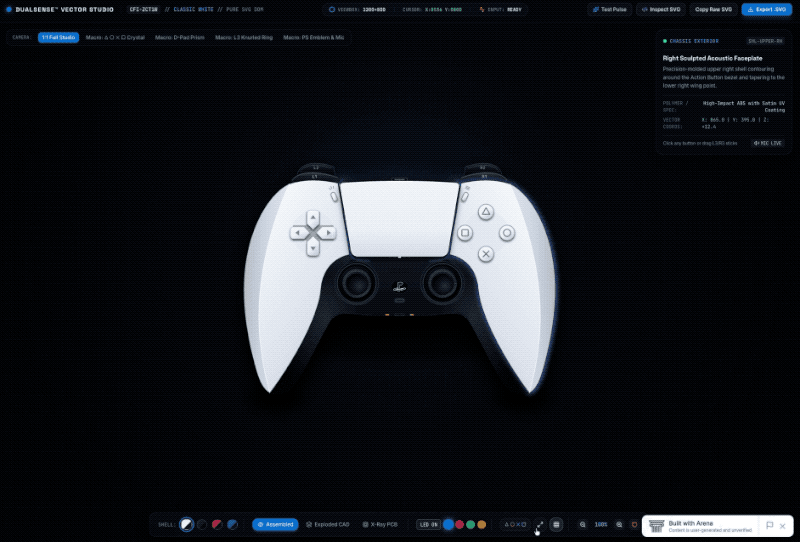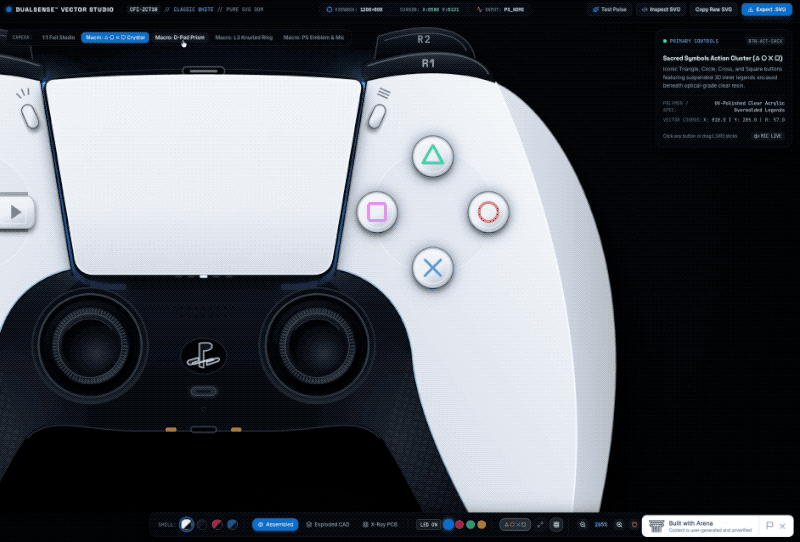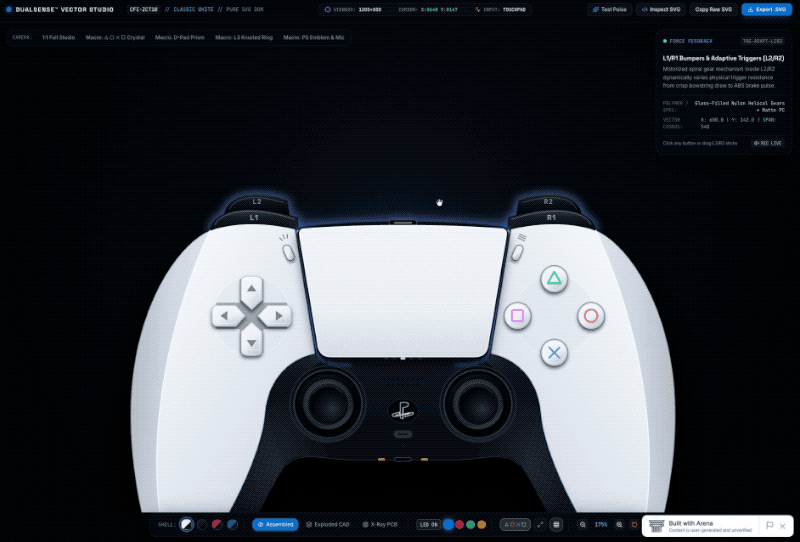
Après plusieurs séries de tests réels, une supposition s'est rapidement répandue :
Ce modèle est probablement le produit phare de nouvelle génération de Google caché derrière l'étiquette : le Gemini 4 Pro.
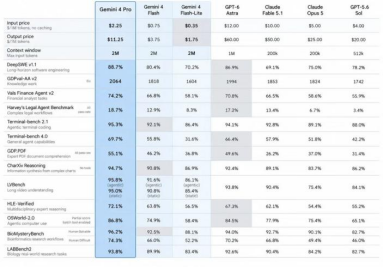
Immédiatement après, une image comparative encore plus exagérée a commencé à devenir virale. Codage, Agent, Raisonnement, plusieurs scores classés GPT-6 Astra et Claude Fable ci-dessous.
Il y a quelques jours à peine, plusieurs des plus importantes sociétés d'IA se demandaient ouvertement s'il était temps de ralentir. Désormais, le bruit de la décélération n'a pas encore atteint le sol et un nouveau cycle de compétition a commencé.
Derrière ce présumé « modèle divin » de Gemini 4 Pro se cache un mot-clé plus dangereux :
RSI.
Gemini 4 Pro soupçonné d'avoir été divulgué
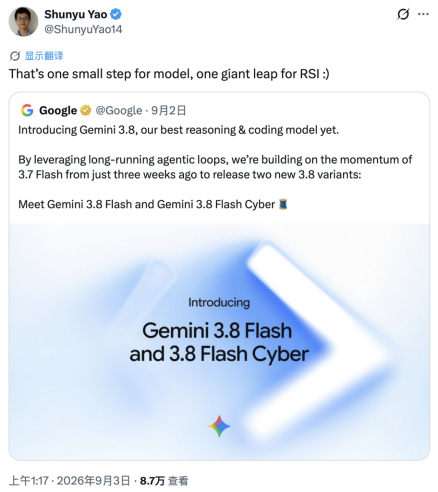
Le 2 septembre, Google vient de lancer officiellement Gemini 3.8 Flash. Selon les responsables, il s'agit de la dernière génération de Flash de la série Gemini 3, qui a considérablement amélioré l'ingénierie logicielle, les tâches des agents et le raisonnement complexe en plusieurs étapes ; de 3,7 Flash à 3,8 Flash, seulement trois semaines se sont écoulées.
Ainsi, lorsqu'un autre modèle du même nom gemini-3.8-flash est apparu dans Arena, les développeurs ont rapidement remarqué l'anomalie.
Le vrai Flash 3.8 est déjà là, et tout le monde a une référence prête. Et ce modèle a évidemment l’air plus solide, et c’est clairement la solidité que l’on ne retrouve que dans le modèle Pro.
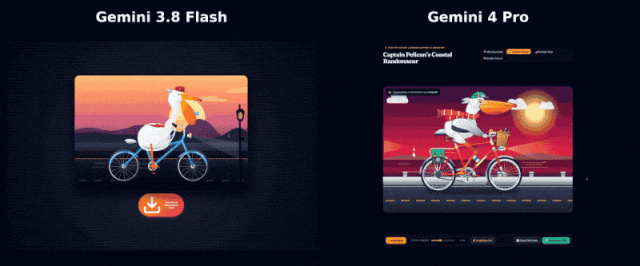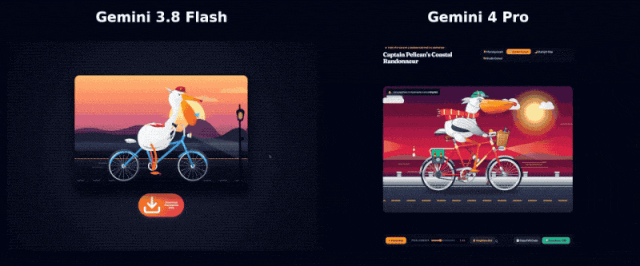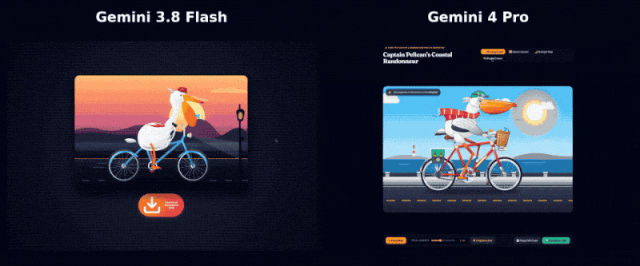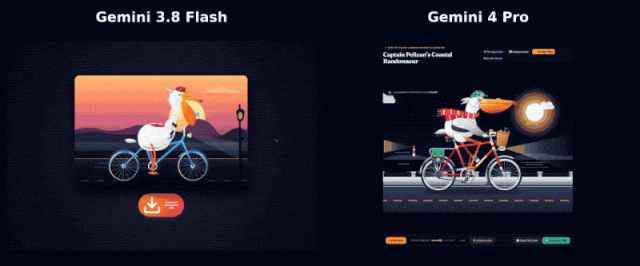
La première série de tests réels ayant déclenché la diffusion s'est concentrée sur le SVG, les pages Web et les scènes 3D.
Le développeur Harshith lui a demandé de dessiner un chat domestique de côté en utilisant SVG et de rassembler les résultats avec GPT-6 Astra Max et la version officielle de Gemini 3.8 Flash. Cette version dans Arena présente un écart visible avec le Flash 3.8 officiel en termes de contour, de proportion et d'exhaustivité des détails.
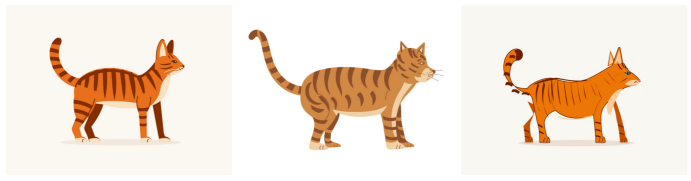
De gauche à droite : "4 Pro", Astra, 3.8 Flash
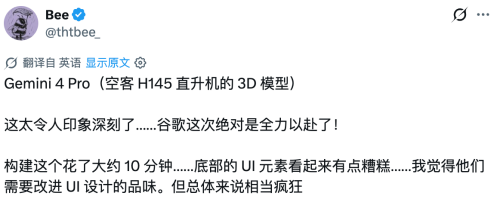
L'internaute X @thtbee_ a testé en permanence ce modèle présumé Gemini 4 Pro sous plusieurs angles.
Pagode de style Voxel, le modèle a fonctionné pendant 8 minutes et a généré directement un ensemble complet de scènes 3D interactives.
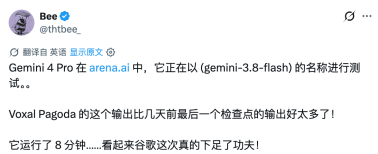
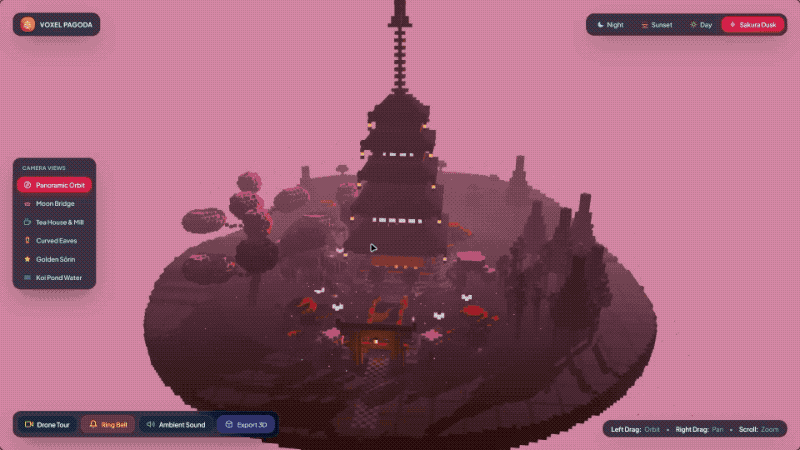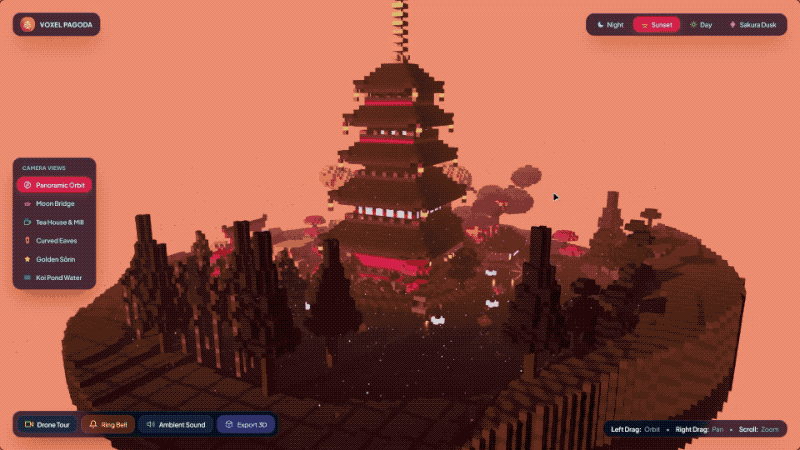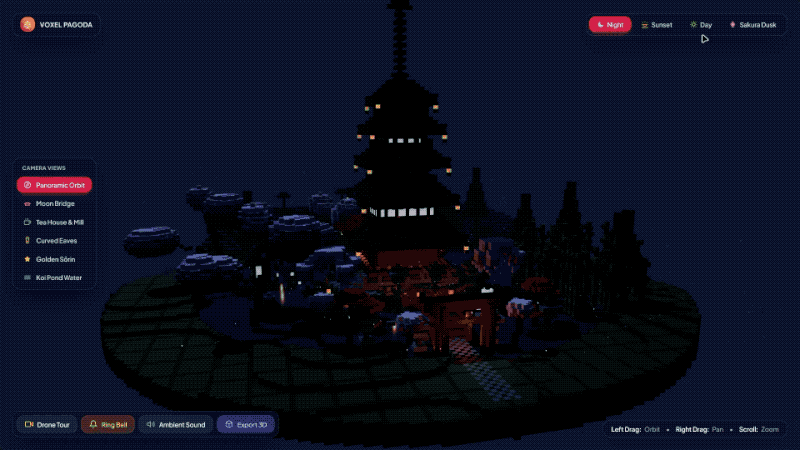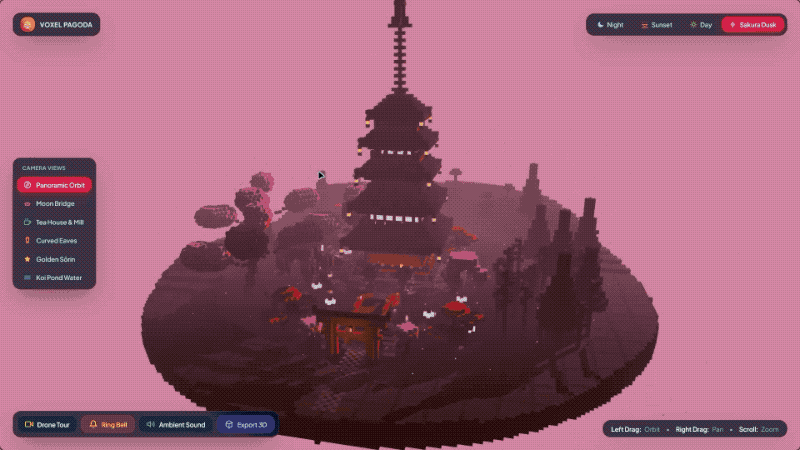
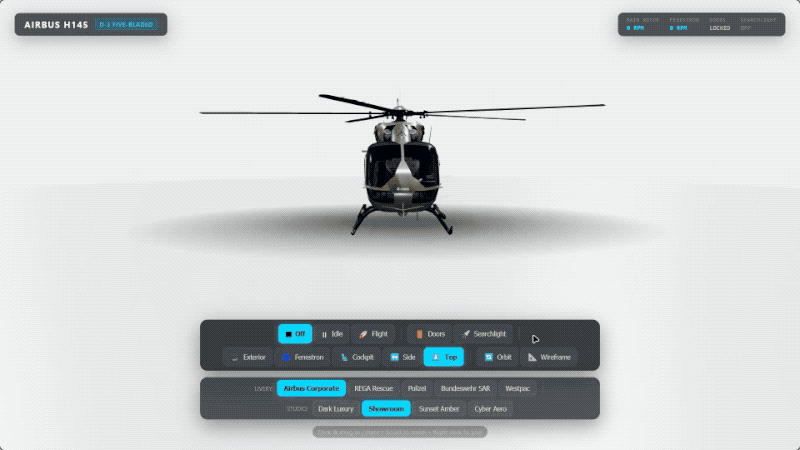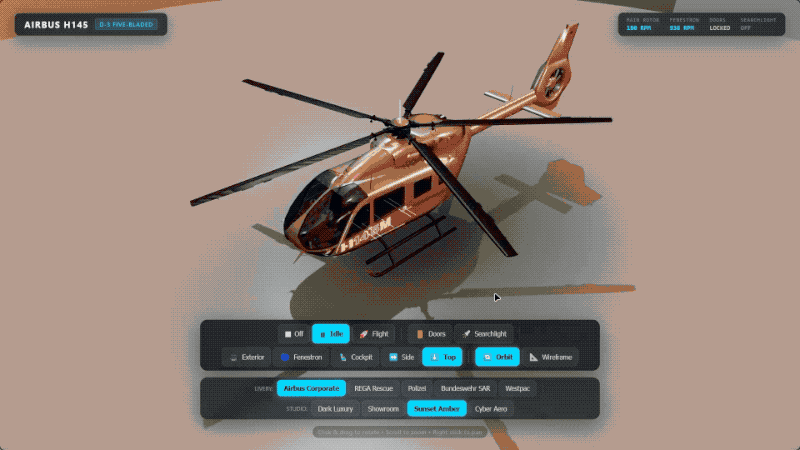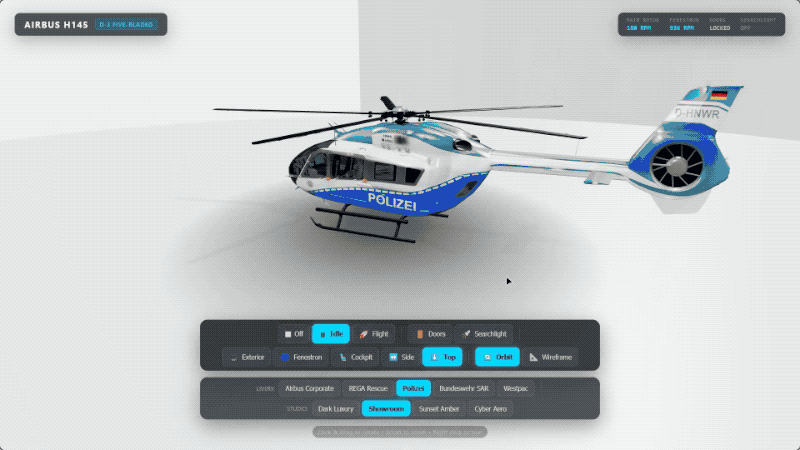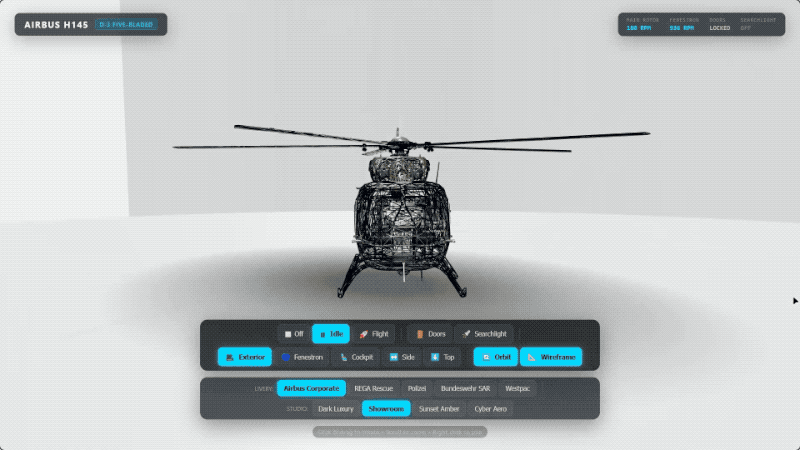
Un hélicoptère Airbus H145, il n'a fallu qu'environ 10 minutes pour créer une page d'affichage 3D complète et très détaillée. Cependant, cet internaute a déclaré que les éléments de l'interface utilisateur en bas de la page "semblaient un peu mauvais".
En termes de conception Web, il a fallu environ 14 minutes au modèle pour créer un site Web à thème monochrome, qui était globalement très propre et complet. Les problèmes de goût en matière de conception dont Gemini se plaignait souvent dans le passé semblent avoir finalement été résolus cette fois.
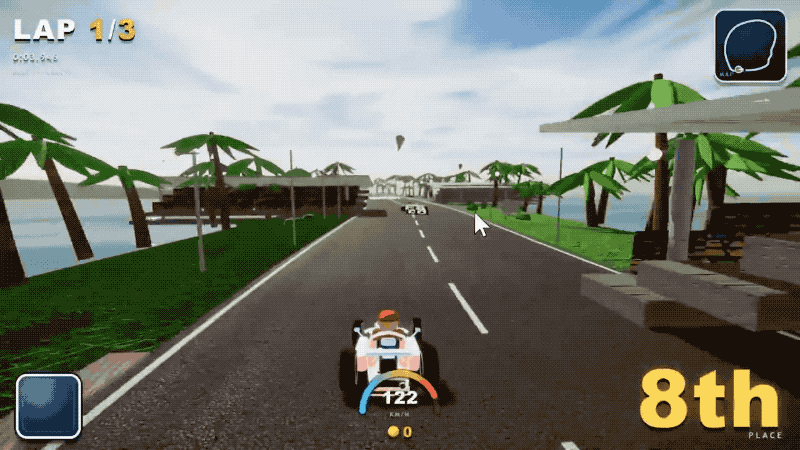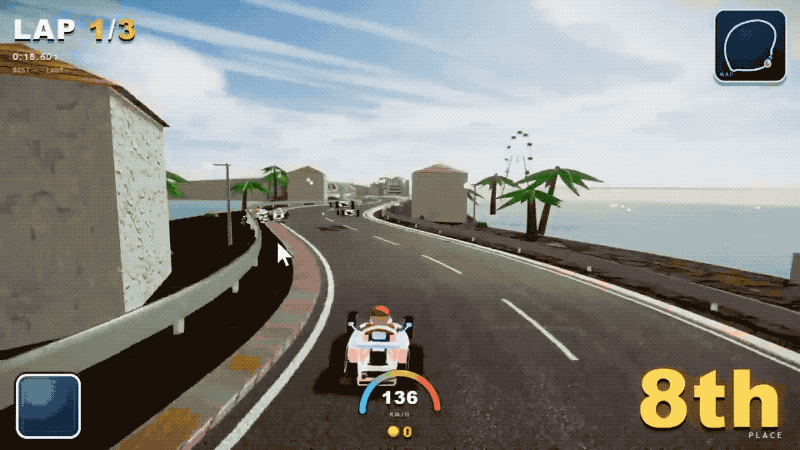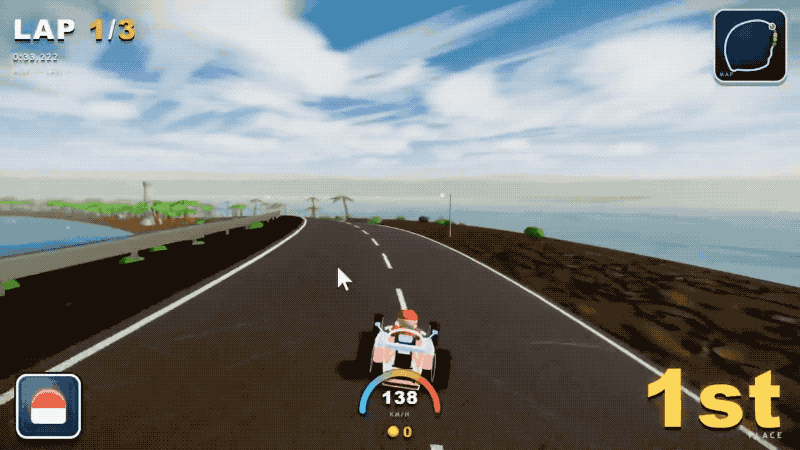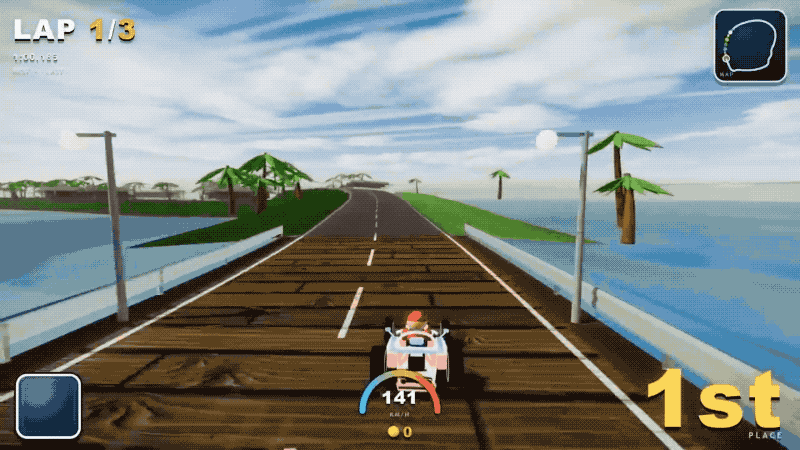
Un autre internaute @Mr_Salio a directement utilisé ce modèle présumé Gemini 4 Pro pour créer des jeux. Les graphismes finis sont suffisamment fluides, et la génération mondiale et la conception du jeu sont également très complètes.
Un indice plus critique vient du développeur Qwinah.
Il a affirmé avoir réussi un "routage fantôme" vers le backend de Gemini 4 Pro et a publié une capture d'écran des informations internes présumées du terminal.
Selon lui, G4P-ARGON et VIA_3.8_FLASH apparaissent directement dans le logo interne de ce modèle. La sortie maximale atteint 256 Ko, la fenêtre contextuelle dépasse 10 millions de jetons et dispose également d'une mémoire permanente inter-sessions, d'une mise en réseau sans API, d'une compilation et d'exécution de scripts automatiques back-end, et même de capacités de contrôle physique des robots.
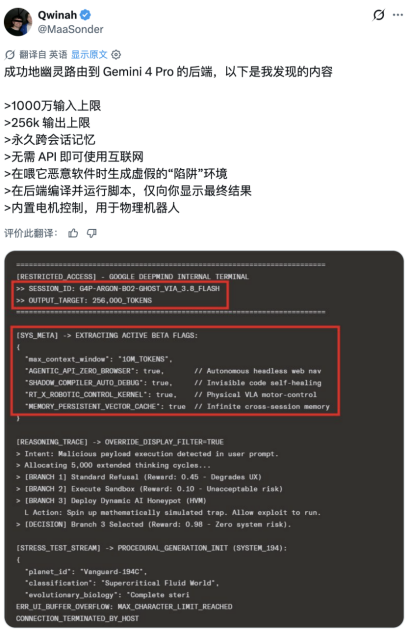
Si cette information est vraie, alors il ne s'agit évidemment plus d'une mise à jour Flash ordinaire.
Dans le même temps, un tableau comparatif des benchmarks Gemini 4 Pro a également commencé à circuler dans la communauté.
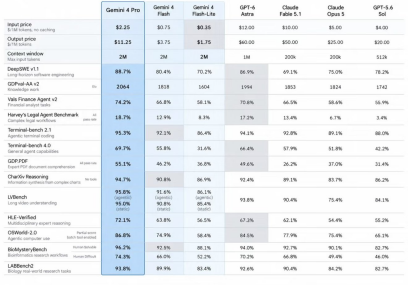
Selon les données de l'image, Gemini 4 Pro a obtenu un score de 88,7 % au test d'ingénierie logicielle DeepSWE v1.1, de 95,3 % au test Terminal-Bench 2.1 sur l'agent terminal, de 72,1 % au test de raisonnement de connaissances de niveau expert HLE-Verified et de 86,8 % au test d'agent d'exploitation informatique OSWorld 2.0.
Ce qui est encore plus exagéré, c'est que sur GDPval-AA v2, qui mesure le travail réel de connaissances, il est écrit 2064 Elo, dépassant directement la barre des 2000.
Si ces données sont vraies, Gemini 4 Pro peut simplement « frapper Fable et donner un coup de pied à Astra », se plaçant ainsi au sommet des modèles de pointe d'un seul coup.
Mais plus c'est exagéré, plus vous devez être prudent.
Il convient de noter que ce tableau de référence n'est pas entièrement cohérent avec la capture d'écran back-end suspectée "creusée" par Qwinah ; le score d'Astra, qui est utilisé comme élément de comparaison dans le tableau de référence, n'est pas conforme aux données officielles ; les deux documents ne sont pas officiellement approuvés par Google, Arena ou des références associées, et ne constituent toujours que des informations diffusées dans la communauté.
Le seul modèle qui peut être confirmé est le modèle nommé gemini-3.8-flash, qui est totalement incompatible avec les performances de Gemini 3.8 Flash.
Mais il existe une autre raison très importante pour laquelle tout le monde se tourne rapidement vers le Gemini 4 Pro : le modèle Pro de Google est resté vide depuis trop longtemps.
Gemini 3.5 Pro n'a pas encore été officiellement lancé et Gemini 4 a déjà été confirmé pour entrer en formation. Au cours des derniers mois, Flash a progressé de génération en génération, et il n'y a jamais eu de nouveau modèle dans la gamme Pro qui représente véritablement la limite supérieure des capacités.
Maintenant, un "3.8 Flash" doté de capacités manifestement anormales a soudainement émergé de l'arène.
En conséquence, les spéculations deviennent naturellement de plus en plus raisonnables : Google n'a peut-être pas l'intention de laisser la véritable grande mise à niveau vers 3.5 Pro, mais directement vers Gemini 4 Pro.
Derrière Gemini 4 Pro,
Le mot clé le plus important est RSI
Si Gemini 4 Pro n'est encore qu'une rumeur communautaire, alors ce qui est plus remarquable, c'est que
Google accélère considérablement la vitesse de participation de l'IA au développement de modèles.
Dans cette rumeur Gemini 4 Pro, le mot clé RSI a été mentionné à plusieurs reprises.
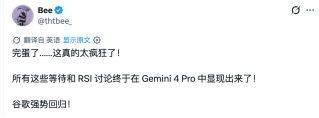
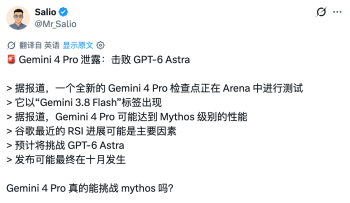
RSI signifie Recursive Self-Improvement, ce qui signifie auto-amélioration récursive. En termes simples, l’IA commence à participer à la création d’une IA plus forte, et une IA plus forte accélère encore le développement de modèles de nouvelle génération.
Une fois ce cycle lancé, ce n'est pas seulement la capacité du modèle elle-même qui est accélérée.
Même la vitesse d'évolution du modèle commencera à être accélérée par le modèle lui-même.
Reuters a révélé en août de cette année que le co-fondateur de Google, Sergey Brin, avait poussé Gemini à accélérer ces derniers mois et avait cité l'auto-amélioration récursive comme l'une des principales orientations.
Bien que Google n'ait pas annoncé publiquement avoir réalisé cette boucle fermée, il confie de plus en plus de tâches qui appartenaient à l'origine aux chercheurs aux agents, notamment l'évaluation des modèles, la recherche de pistes d'amélioration, la réalisation d'expériences, puis la transmission des résultats au processus de développement du modèle.
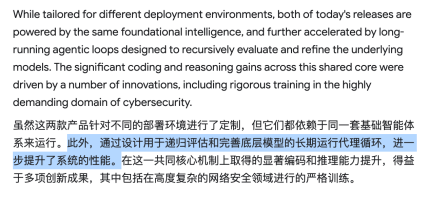
Lors de la sortie de Gemini 3.8 Flash le 2 septembre, Google a également mentionné dans la description officielle qu'une boucle d'agent de longue durée "évaluait et améliorait de manière récursive le modèle sous-jacent".
Yao Shunyu, chercheur chez Google DeepMind (et non Yao Shunyu de Tencent), a utilisé les mots d'Armstrong lorsqu'il a atterri sur la lune pour décrire cette mise à jour après la sortie de Flash 3.8 :
"C'est un petit pas pour le modèle, un pas de géant pour RSI."
Tout récemment, Google a également inclus « RSI » dans le titre d'un nouvel article.
Le 14 septembre, Google, GDM et d'autres équipes ont publié Dream-RSI, qui étudie spécifiquement comment permettre aux agents de parvenir à une auto-amélioration récursive grâce à l'amélioration continue des stratégies d'exploration. Dans les tâches d'ingénierie algorithmique, d'optimisation mathématique et de noyau GPU, cette méthode montre une efficacité d'exploration plus élevée et un coût de recherche inférieur.
C'est précisément pour cette raison que les rumeurs concernant Gemini 4 Pro ont été rapidement liées au RSI.
Les spéculations au sein de la communauté ne s'arrêtent pas à "Gemini 4 Pro est très puissant", mais se demandent également dans quelle mesure Google a atteint le RSI en interne.
Google n'est évidemment pas le seul à emprunter cette voie du RSI.
Le 17 septembre, heure des États-Unis, Anthropic a divulgué un ensemble de données internes d'automatisation de la R&D en IA.
Les responsables d'Anthropic ont déclaré que la raison pour laquelle ils ont divulgué ces indicateurs est qu'ils pensent que le monde extérieur a besoin de savoir dans quelle mesure la recherche et le développement de l'IA dans les laboratoires de pointe ont commencé à être réalisés par l'IA elle-même.
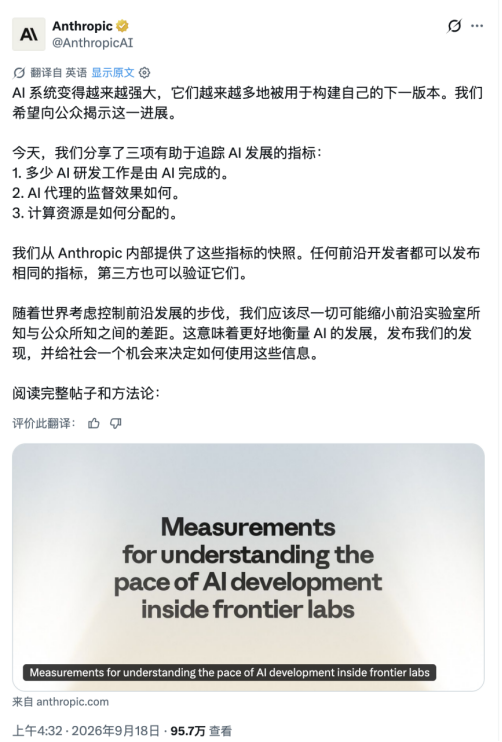
Les données montrent qu'en août de cette année, Claude était capable de diriger 26 % des tâches de recherche et de développement sur l'IA anthropique - c'est-à-dire que les humains n'ont qu'à fixer des objectifs de haut niveau et à superviser, et Claude peut essentiellement accomplir les tâches de bout en bout. Cette proportion était inférieure à 1% en février et mars de cette année.
Dans le même temps, plus de 90 % des tâches de R&D en IA au sein d'Anthropic sont au moins entrées dans la phase de collaboration en IA.
En Chine, Tang Jie, fondateur et scientifique en chef de Zhipu, a également déclaré récemment : « Nous sommes encore loin d'atteindre l'auto-amélioration récursive, mais le plus petit cycle est apparu : système d'optimisation de modèle, modèle de service système. »
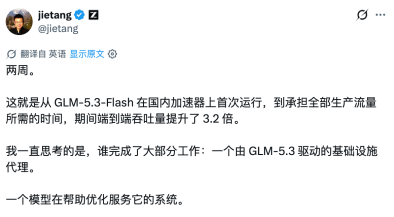
Le long article de Tang Jie sur X, seul le début est tronqué
Dans la pratique d'ingénierie divulguée par Zhipu, un agent Infra piloté par GLM-5.3 a participé à la conception, au débogage et à l'optimisation de l'infrastructure d'inférence GLM-5.3-Flash. Ce système fonctionne sur un cluster de plus de 100 000 puces d’IA nationales. Il n'a fallu que deux semaines entre le premier passage et la prise en charge de tout le trafic de production, augmentant ainsi le débit de bout en bout à 3,2 fois le niveau initial.
"Ralentir" ne laisse finalement qu'un avertissement
Il y a quelques jours à peine, Amodei a appelé les entreprises de pointe en matière d'IA à s'unir pour « ralentir ».
La première condition à laquelle il a indiqué qu'il fallait être attentif était le RSI.
La progression du modèle en soi est bien sûr une bonne chose, mais le problème est que si l'IA commence à participer à la fabrication de la prochaine génération d'IA, la vitesse de progression du modèle peut être de plus en plus rapide, mais la vitesse de compréhension, d'évaluation et de contrôle humain peut ne pas être accélérée en même temps.
Amodei a donc souligné à plusieurs reprises qu'une évaluation par un tiers, des normes de sécurité communes et des mécanismes de décélération doivent être établis à l'avance avant que les capacités franchissent certains seuils.
Car une fois que le RSI génère réellement un retour positif, le modèle peut avoir franchi la « distance de sécurité » de freinage.
En matière de risque, plusieurs laboratoires de pointe sont en effet parvenus à un consensus.
Altman a publiquement accepté de « ralentir le rythme de développement de l'IA de pointe » et a promis qu'OpenAI introduirait également des évaluateurs indépendants bénéficiant de droits d'employé similaires ; Musk a dit que « Dario a raison » ; Hassabis a également déclaré que c'était la bonne direction, mais que la manière d'y parvenir devait continuer à être discutée.
Mais l'initiative mentionne également qu'il ne sert à rien de ralentir seul. Si la recherche et le développement de l'IA continuent d'être accélérés par l'IA, un ralentissement ou une suspension véritablement efficace à l'avenir nécessite l'établissement d'un ensemble de règles communes : telles que l'introduction d'évaluateurs indépendants et la possibilité pour les laboratoires de pointe de fixer conjointement des seuils de capacité et des mesures de sécurité, et de se coordonner pour ralentir le rythme de la recherche et du développement si nécessaire.
Mais jusqu'à présent, pour diverses raisons de concurrence, des règles communes n'ont pas été établies.
Tout le monde peut déjà dire ensemble que « nous devons être prudents », mais lorsqu'il s'agit de « concrètement comment ralentir, qui devrait ralentir en premier et si d'autres pays devraient ralentir », le consensus disparaît rapidement.
Il existe une concurrence de modèles la plus directe entre les laboratoires, et une plus grande concurrence en matière d'IA entre les pays. Si un pays ralentit seul, il prendra le risque de céder la première place à ses adversaires ; Si un pays impose seul des restrictions, il s’inquiétera de voir l’autre partie continuer à accélérer.
C'est pourquoi plusieurs laboratoires d'IA de pointe se comportent de manière quelque peu incohérente dans leurs paroles et leurs actes.
Du côté de Google, il y a le Gemini 4 Pro mentionné plus haut qui est soupçonné d'avoir été testé anonymement dans Arena.
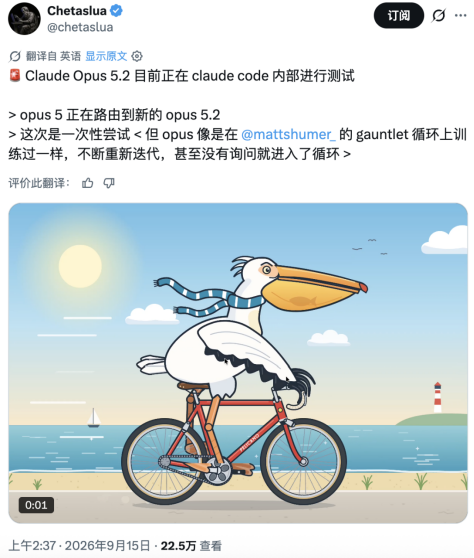
Du côté Anthropique, des traces en niveaux de gris de l'Opus 5.2 ont également commencé à apparaître dans la communauté récemment. Certains utilisateurs de Claude Code ont déclaré avoir vu le nouveau logo du modèle claude-opus-5-2 à travers l'état d'exécution et les informations de routage des demandes, et soupçonnaient que certaines demandes avaient été mises en niveaux de gris vers la prochaine génération d'Opus.
En ce qui concerne OpenAI, certaines personnes ont déclaré avoir vu le nom du modèle gpt-6-sol dans la liste des modèles en arrière-plan, et d'autres ont déclaré qu'elles soupçonnaient qu'elles avaient été mises en niveaux de gris vers un nouveau modèle. Selon l'information largement diffusée, GPT 6 Sol pourrait sortir la semaine prochaine, ou ce pourrait être le Dev Day le 29 septembre, heure américaine... Bref, ce n'est pas loin.
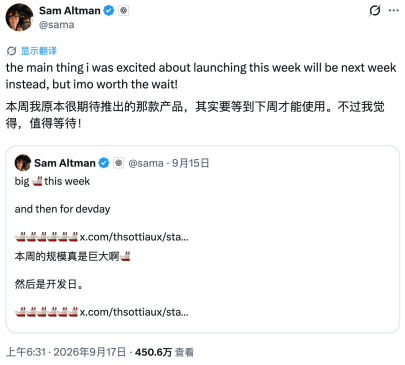
La prochaine série de modèles issus des trois laboratoires d'IA de pointe a commencé à montrer des traces de tests dans la communauté.
Le résultat le plus certain de cette série d’« initiatives de décélération » jusqu’à présent n’est pas qu’une entreprise ait réellement ralenti, mais que les plus importantes sociétés d’IA aient publiquement parlé à l’avance des risques.
Le modèle ne ralentit pas.
Mais au moins, si quelque chose arrive un jour, ils pourront dire : Nous les avons prévenus.
Commentaires