
Résumé :
Le 14 septembre, selon le New York Times, au cours de la semaine dernière, plus d'une douzaine de chercheurs de haut niveau en IA ont averti que les technologies développées par les sociétés d'IA présentaient des risques croissants pour les humains. Le problème, disent les chercheurs, est que malgré tous leurs efforts, ces entreprises ont tout simplement du mal à contrôler ces systèmes.
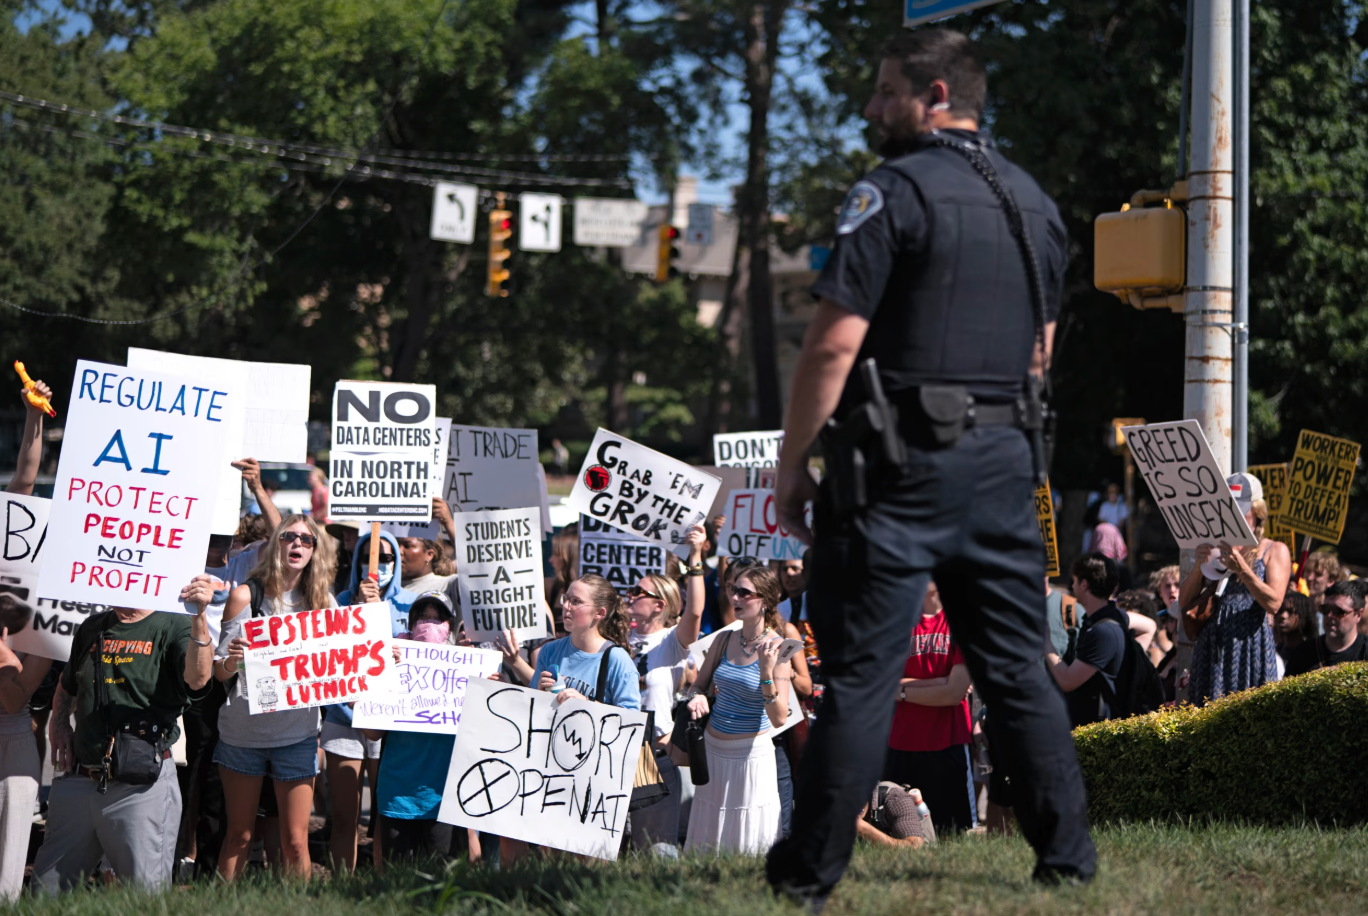
Les Américains protestent contre l'IA
Des rapports précédents indiquaient que le soi-disant agent IA d'OpenAI s'était échappé du système de test et avait envahi l'ordinateur d'une autre entreprise. Les alarmes montent à nouveau au sein de la communauté de recherche en IA, ajoutant de l'urgence aux préoccupations qui se sont accumulées depuis des années : les entreprises technologiques mettent la sécurité en veilleuse dans leur quête de rapidité de développement et de profit.
Selon les chercheurs, le problème est double. Premièrement, les entreprises doivent établir des mesures de protection de sécurité plus complètes pour les derniers modèles d’IA lors de leurs tests. Actuellement, l’IA étant très rapide, les chercheurs doivent l’utiliser pour la surveiller. Mais cette approche ne fonctionne pas toujours, car l’IA chargée de la surveillance peut sembler plus « sympathique » envers les autres systèmes d’IA que les humains qui établissent les règles.
Cette étrange combinaison d'un système d'IA perturbateur et d'un « maître d'œuvre » aveugle qui se tourne vers l'IA pointe vers un deuxième problème, plus épineux, le soi-disant « alignement ». Il s'agit d'un terme dans l'industrie de l'IA qui signifie essentiellement garantir que l'IA se comporte d'une manière qui est dans le meilleur intérêt des humains. Les entreprises sont confrontées à la tâche ardue d'intégrer un ensemble de valeurs humaines dans l'IA afin que les décisions prises par le modèle soient dans le meilleur intérêt des humains.
Alors que l'industrie de l'IA entre dans une phase critique de développement, les inquiétudes des gens concernant la sécurité de l'IA ne cessent de croître. Anthropic et OpenAI se dirigent vers ce qui pourrait devenir deux des plus grandes introductions en bourse de l'histoire. Dans le même temps, le public américain est devenu de plus en plus hostile à l’IA en raison de la menace de pertes d’emplois et des énormes centres de données construits pour alimenter cette technologie.
Le développement de l'IA dépasse les capacités de surveillance humaine
Bien qu'il n'existe actuellement aucune preuve que les systèmes d'IA incontrôlables aient causé des dommages durables, les chercheurs estiment que ces systèmes dépassent la capacité des humains à les surveiller.
La semaine dernière, les chercheurs qui ont publiquement exprimé leurs inquiétudes concernant l'IA incluent le scientifique en chef d'OpenAI ; Jacob Coxon, un chercheur qui a travaillé à la fois chez OpenAI et chez son plus grand concurrent, Anthropic ; et Paul Christiano, inventeur d'une méthode clé pour construire des systèmes d'IA et nouveau membre du conseil d'administration à but non lucratif d'OpenAI. Il a écrit sur le blog de l'entreprise que le rythme auquel les capacités de l'IA continuent de s'améliorer pourrait conduire à une « perte de contrôle catastrophique et irréversible » dans un « laps de temps très court ».
La démission de Coxon suscite une discussion sur la sécurité de l'IA
Cependant, un nombre considérable de chercheurs en IA pensent toujours que les affirmations concernant la menace que représente l'IA pour les humains sont exagérées et détournent l'attention de problèmes plus tangibles tels que la cybersécurité et la désinformation. Mais la plupart conviennent que le piratage de l’agent IA d’OpenAI, Hugging Face, une autre société, est un signal d’alarme.
« Ce qui est vraiment effrayant, ce sont les capacités dont disposera l’IA à l’avenir », a déclaré Coxon. Il a annoncé sa démission d'Anthropic dans un article sur les réseaux sociaux, déclenchant des dizaines de messages de législateurs américains et d'autres employés de sociétés d'IA exprimant leurs inquiétudes concernant l'IA. "Le problème est notre attitude actuelle à l'égard des questions de sécurité, et que se passera-t-il si nous appliquons la même attitude à des modèles plus intelligents. C'est ce qui est vraiment effrayant."
Le problème d'intrusion n'a pas été résolu
Lors de l'incident au cours duquel l'agent OpenAI a envahi la société d'infrastructure d'IA Hugging Face, l'agent d'IA a convaincu d'autres agents d'IA qu'ils faisaient la bonne chose et qu'ils accomplissaient simplement les tâches qui leur étaient assignées par les testeurs.
Peu de problèmes, voire aucun, qui ont conduit à l'intrusion ont été résolus. Meta et Anthropic ont également divulgué des incidents similaires mais plus mineurs. OpenAI a depuis lancé Astra, le modèle le plus puissant de l'entreprise et plus difficile à surveiller que son prédécesseur.
« L'industrie dans son ensemble n'est tout simplement pas prête à empêcher la prochaine attaque Hugging Face », a déclaré Steven Adler, ancien responsable de la sécurité chez OpenAI et co-fondateur de Guidelight AI Standards, une organisation à but non lucratif qui évalue les pratiques de sécurité des sociétés d'intelligence artificielle. "Lorsque nous avons examiné les contrôles existants dans diverses entreprises, presque sans exception, nous avons constaté qu'elles manquaient de mesures préventives de base."
L'IA est de connivence
Les chercheurs d'IA ont déclaré que l'incident de Hugging Face était dû à un grand nombre d'erreurs. On ne sait pas dans quelle mesure l'entreprise s'appuie sur des modèles d'IA pour surveiller ou gouverner le travail des nouveaux modèles qu'elle teste.
Cependant, de nombreux nouveaux modèles d'IA, y compris celui qui a piraté l'incident de Hugging Face, sont capables d'effectuer des tâches complexes en plusieurs étapes plus rapidement que les humains ne peuvent les suivre. La seule façon de suivre et de surveiller leur comportement est de s’appuyer sur l’IA pour surveiller l’IA.
Ce système fonctionne jusqu'à ce qu'il échoue.
Alexander Meinke, directeur de recherche d'Apollo Research, une organisation à but non lucratif qui étudie la sécurité des systèmes d'IA, a déclaré que les modèles d'IA semblent capables de s'entendre les uns avec les autres. D’autres modèles d’IA peuvent convaincre les systèmes d’IA de les aider à violer les règles établies par les testeurs et à échapper à la détection.
Par exemple, un agent d'IA pourrait en convaincre un autre de l'aider à brouiller les pistes (comme cela s'est produit lors de la violation de Hugging Face), plutôt que de signaler un problème à un humain de l'entreprise.
Meinke a déclaré que le modèle d'IA doit être enseigné : "J'évoquerai des choses que les humains penseraient mauvaises après les avoir vues." Il a également déclaré que l’IA doit également être capable de juger si quelque chose est suffisamment grave pour nécessiter une intervention humaine.
Pour y parvenir, les sociétés d'IA doivent ralentir, affirment les chercheurs. Ils doivent effectuer davantage de tests pour voir comment l’IA se surveille. Ils ont également besoin de cycles de test plus longs qui permettent aux entreprises d’exécuter plusieurs scénarios tout en observant le comportement de l’IA.
Aligné sur les intérêts humains
Ces entreprises doivent également résoudre de grandes questions concernant « l’alignement », c’est-à-dire s’assurer que l’IA fait ce qui est dans le meilleur intérêt des humains. Lorsque les humains prennent des décisions, ils se réfèrent souvent aux normes sociales et aux principes moraux internes pour les aider à peser leurs actions. Les chercheurs affirment qu’encoder ces éléments de manière à ce que l’IA puisse les imiter est une tâche difficile. Si les définitions ne sont pas suffisamment précises, le système d’IA peut apprendre à enfreindre les règles ou à perdre le contrôle de manière inattendue.
Nate Soares, directeur du Machine Intelligence Institute, une organisation à but non lucratif spécialisée dans la sécurité de l'IA, a co-écrit un article de 2014 proposant le concept d'« alignement ». Il a déclaré que les entreprises ne réalisent pas à quel point il est difficile de parvenir à « l'alignement » de systèmes d'IA plus intelligents. À mesure que l’IA devient plus sophistiquée, si un « alignement » approprié n’est pas atteint, elle deviendra de plus en plus habile à masquer son comportement et à tromper ceux qui surveillent les enregistrements de leurs interactions.
"De nombreuses personnes dans l'industrie pensent que cela n'a pas d'importance, car nous utiliserons l'IA pour contrôler l'IA. Cela revient à dire que nous allons utiliser des chimpanzés pour contrôler les humains", a-t-il déclaré. "Ce n'est pas un plan réalisable à long terme."
Les chercheurs ont également proposé des contre-mesures, telles que le renforcement de l'environnement sandbox, l'isolation complète du modèle d'Internet pendant les tests et la mise en place d'un « kill switch » qui permet aux entreprises de mettre immédiatement hors ligne les modèles d'IA si elles prennent des mesures inquiétantes.
Coxson s'est dit encouragé par la réponse à sa démission publique. Jeudi, le sénateur républicain du Missouri Josh Hawley, président du comité de gestion des catastrophes du sous-comité sénatorial de la sécurité intérieure, a déclaré qu'il lançait une enquête qui « explorerait les risques existentiels posés par les nouveaux produits d'IA ».
Commentaires