
Résumé :
L'équipe de recherche d'Apple révèle des progrès dans la recherche sur le « cerveau » des robots. Le 4 novembre, heure locale, l'équipe de recherche d'Apple a soumis l'article « Perceptive Humanoid Motion from Simulation » sur la plateforme de préimpression arXiv, révélant le système de contrôle autonome du robot humanoïde HALO. L'équipe de recherche a déployé le système sur le robot humanoïde G1 de Yushu Technology à des fins de vérification, permettant au robot d'effectuer les actions apprises dans l'environnement de simulation et de les exécuter dans une pièce réelle inconnue.
L'équipe de recherche a également divulgué la génération de données, la formation du modèle et le code de déploiement, couvrant la génération d'actions, le suivi des actions, l'orchestration des tâches, la simulation et le fonctionnement réel du robot.
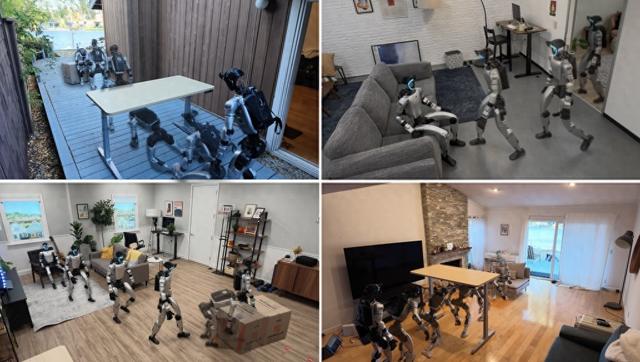
Le robot Yushu G1 équipé du Le système HALO présente des tâches telles que ramper sous la table, s'asseoir sur le canapé et pousser des boîtes dans différents environnements réels. Source de l'image : équipe de recherche HALO
La page du projet montre le robot suivant des instructions pour pousser des cartons, suivre des personnes, s'asseoir sur des chaises, passer de côté une porte entrouverte, se pencher ou ramper sous une table, etc. Ces tâches nécessitent que le robot comprenne son environnement et ajuste sa posture corporelle en fonction des conditions spatiales.
Lors de l'exécution de tâches, HALO est contrôlé de manière collaborative par trois niveaux. La couche supérieure est le module d'orchestration des tâches basé sur le modèle de langage visuel (VLM). Il utilise Qianwen Qwen3.6-35B-A3B par défaut. Il fonctionne localement sur le Mac mini équipé sur le robot. Il partage le moteur de service de modèle avec le générateur d'actions et peut fonctionner sans avoir besoin d'une connexion Internet. Le système peut également choisir d'appeler le modèle cloud via l'API pour obtenir des capacités de raisonnement et de planification plus solides.
Cette couche doit traiter les informations floues contenues dans les instructions et organiser les actions en fonction de l'environnement. Par exemple, « s'asseoir » n'a pas d'objectif clairement spécifié et nécessite que le robot détermine où s'asseoir à partir de la scène devant lui ; « s'asseoir sur une chaise » peut être exécuté directement lorsque le chemin est libre, mais s'il y a une table qui bloque le passage, il doit être divisé en sous-tâches continues telles que se pencher, s'approcher de la chaise et s'asseoir. Le module d'orchestration des tâches observe en permanence l'environnement à travers la vidéo du point de vue du robot, détermine si l'action en cours est réussie et avance le plan ou réessaye en conséquence, en confiant à chaque fois une sous-tâche claire au générateur d'action.
La couche de génération d'action au milieu utilise un autre modèle Qianwen, Qwen3.5-2B. L'équipe de recherche l'utilise comme encodeur de gel des paramètres et coopère avec le décodeur DiT chargé de générer des actions pour planifier les mouvements du corps entier pendant environ 5 secondes dans le futur, sur la base des images vues par le robot et de la sous-tâche en cours. Cette couche est replanifiée environ trois fois par seconde, ce qui permet au plan d'action d'être continuellement mis à jour à mesure que l'environnement évolue.
La couche inférieure est un outil de suivi des actions formé par l'apprentissage par renforcement, la distillation des politiques et d'autres étapes. Il fonctionne à une fréquence de 50 fois par seconde, combine les images de profondeur et l'état du robot et convertit les plans d'action en instructions de contrôle conjointes.
Les trois niveaux sont respectivement responsables de l'organisation des tâches, de la planification des actions et du contrôle du corps, et complètent en collaboration le processus depuis la compréhension des instructions jusqu'à l'exécution des actions.
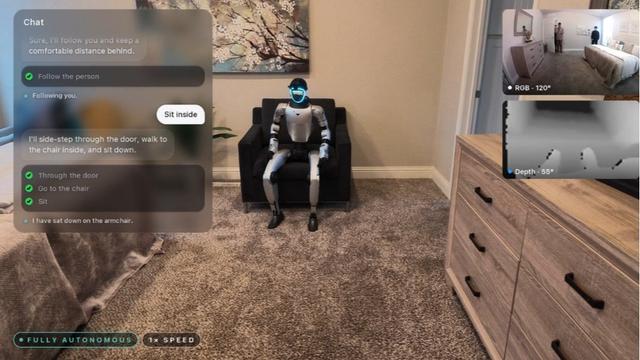
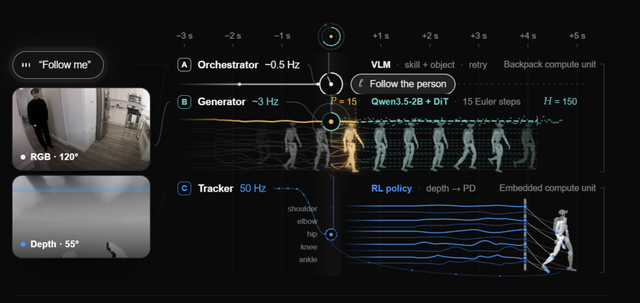
L'architecture de contrôle à trois niveaux de HALO : le modèle de langage visuel est responsable de l'orchestration des tâches, le module de génération planifie l'ensemble des mouvements du corps et le tracker d'action entraîné par l'apprentissage par renforcement effectue un contrôle conjoint. Source de l'image : Mosaïque de captures d'écran de la page du projet HALO
Selon l'article, l'équipe de recherche a effectué 360 tests de tâche unique dans 6 environnements réels sans analyse préalable ni cartographie, avec un taux de réussite moyen de 91 %. Dans un autre environnement réel, 10 tests ont été réalisés sur trois tâches combinées, et le taux de réussite moyen était de 70 %. Parmi eux, le taux de réussite de la combinaison « se pencher sur l'obstacle - marcher vers la cible - pousser la boîte » est de 50 %.
Cette recherche se concentre sur la façon dont les robots obtiennent les données nécessaires pour accomplir ces tâches. L'équipe de recherche a synthétisé environ 300 heures de données d'entraînement primaires dans 1 000 environnements domestiques simulés générés par un programme pour correspondre à « ce que le robot a vu », « quelles instructions il a reçues » et « comment se déplacer ».
Plus précisément, le système génère d'abord des actions, puis les place dans la salle virtuelle et enfin génère des images du point de vue du robot. La page du projet prend comme exemple « S'asseoir sur un fauteuil », en le divisant en segments tels que marcher en avant, se retourner et s'asseoir. Le modèle de génération d'actions génère des séquences d'actions basées sur des invites textuelles, des points de passage et des postures clés. Les actions sont ensuite contrôlées par des contrôles géométriques afin de réduire les problèmes tels que le glissement des pieds et la pénétration du corps dans le sol.
Ensuite, le système organise les actions dans la pièce générée par le programme, vérifie la relation de position entre le robot et le meuble, recherche un plan de placement sans collision, puis utilise des outils de simulation pour restituer ce que le robot voit lorsqu'il exécute l'action. Pendant la formation, les conditions telles que l’éclairage, la tonalité des couleurs et le flou de l’image seront également modifiées pour rendre l’entrée visuelle plus diversifiée. De cette manière, le même processus peut générer des données complémentaires, notamment des instructions, des images visuelles et des mouvements de l’ensemble du corps.
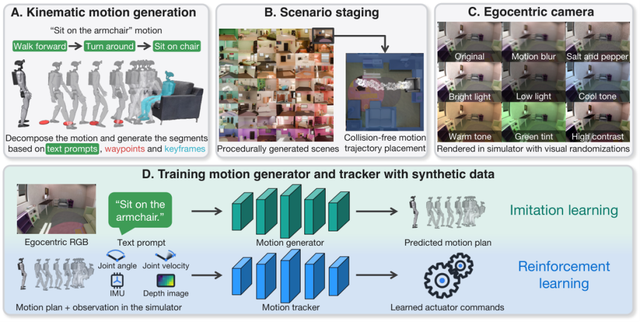
Processus de génération de données synthétiques et de formation de HALO : générez d'abord une trajectoire d'action, placez-la dans la scène virtuelle, puis restituez l'image du point de vue du robot pour former des données de formation de support pour la formation du générateur d'action et du suivi d'action. Source de l'image : papier HALO
Selon les rapports, l'équipe de recherche a utilisé 250 GPU NVIDIA H100 et a mis environ 48 heures pour synthétiser les principales données d'entraînement. Le générateur d'action est entraîné par apprentissage par imitation, à l'aide de 64 B200 ; le tracker d'action est formé par l'apprentissage par renforcement, la distillation des politiques et d'autres étapes, à l'aide de 4 H100.
Il convient de souligner que les données générées par la simulation ne suppriment pas complètement la participation humaine. L'équipe a déclaré que les nouvelles tâches physiques nécessitent toujours l'écriture manuelle de mots d'invite et la conception d'images clés d'action, et que certaines actions utilisent également du matériel de vidéo humaine ou de capture de mouvement.
L'équipe de recherche a également souligné qu'actuellement les robots s'appuient principalement sur la perception visuelle et qu'il est difficile de percevoir directement les situations de contact ; lorsque des objets quittent le champ de vision de la caméra ou sont obstrués, l'exécution de tâches impliquant davantage de contacts diminue. L'ajout de la perception tactile est l'une des directions d'améliorations ultérieures.
Commentaires