
Résumé :
Le 16 octobre, Anthropic a annoncé un résultat de recherche spécial. Un employé a confié à Claude un problème qui troublait la communauté de la cryptographie depuis plus de deux décennies au modèle de recherche interne. Sans fournir d’indices clés, Claude a passé moins d’une demi-heure à comprendre comment les cinq graines de courbe elliptique du NIST étaient générées.
Il s'avère que les graines proviennent de l'ancien générateur de nombres pseudo-aléatoires lrand48 de la bibliothèque C. L'état initial du générateur est déterminé par un horodatage Unix.
Cette découverte ne détruit pas l'ECDSA et n'introduit pas non plus de nouvelles méthodes d'attaque. Anthropic estime que cela réduit encore davantage la possibilité de portes dérobées artificielles dans la courbe de corrélation.
Une série de chiffres trouble la communauté de la cryptographie depuis plus de 20 ans
ECDSA est un algorithme de signature numérique à courbe elliptique largement utilisé.
En 2000, le NIST a répertorié plusieurs courbes standard pour différents niveaux de sécurité dans la norme FIPS 186-2, notamment P-192, P-224, P-256, P-384 et P-521.
Ces courbes sont accompagnées d'un ensemble de paramètres appelés « graines ». Selon le processus de génération du standard, la valeur de hachage de la graine participera à la détermination du coefficient de courbe.
Le problème est que ces graines ont été fournies par l'Agence nationale de sécurité et que les documents publics n'indiquent pas leur origine ni n'expliquent le processus de sélection. Le monde extérieur se demande depuis longtemps si les concepteurs ont examiné un grand nombre de courbes candidates et sélectionné des paramètres possédant certaines propriétés cachées.
En 2015, le cryptographe de la NSA Jerry Solinas, qui avait participé à des travaux connexes, a rappelé que la graine provenait peut-être d'un mot de passe farfelu, tel que « Donnez une augmentation à Bob et Jerry », mais il ne se souvenait pas des détails spécifiques et ces fichiers archivés d'il y a longtemps n'ont pas été retrouvés. Solinas est décédé en 2023, et la piste n'a finalement pas été vérifiée.
Claude a trouvé la source des graines
De nombreux employés d'Anthropic avaient déjà suivi le « mot de passe humoristique » pour trouver ces « graines » sans succès, et ont découvert plus tard que l'indice était faux.
En octobre, un employé a demandé à un modèle de recherche interne de déterminer comment ces « graines » étaient générées. Cette fois, il n’a pas révélé le mot de passe précédent du modèle.
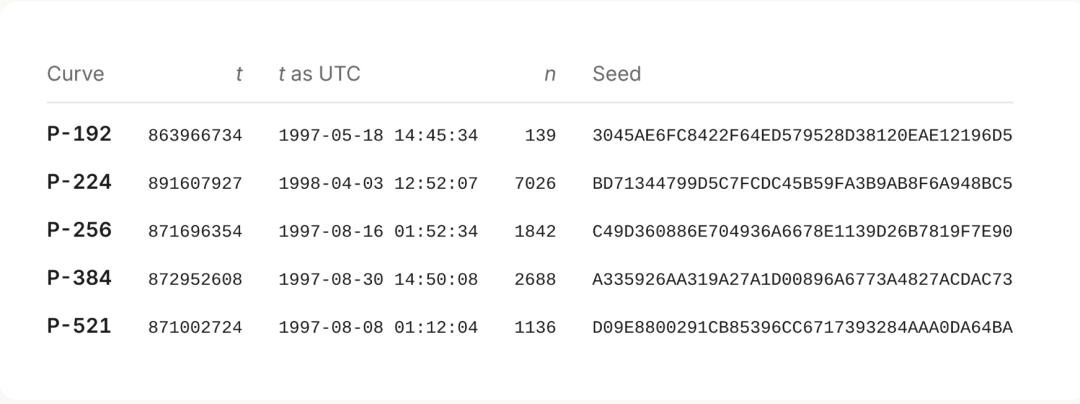
En moins d'une demi-heure, Claude a trouvé la source des graines P-192, P-224, P-256, P-384 et P-521 du NIST.
Ces graines ne proviennent d'aucun algorithme de hachage, mais sont générées par le générateur de nombres aléatoires lrand48 dans la bibliothèque C, qui est initialisé avec un horodatage Unix comme valeur de graine.
L'algorithme spécifique initialisera le générateur de nombres aléatoires en utilisant l'horodatage Unix t et l'exécutera un certain nombre de fois n. Chaque itération extrait 20 octets en tant que graine candidate.
Les 20 premiers octets sont la première valeur de départ candidate, les 20 octets suivants sont la deuxième valeur de départ candidate, et ainsi de suite. En prenant le P-256 comme exemple, le générateur ne produit pas la graine qui est finalement écrite dans la norme avant la 1842ème exécution.
Comment Claude l'a-t-il trouvé ?
La recherche autour du mot de passe supposé n'a jamais donné de résultats. Claude a changé de point de vue et a commencé à spéculer sur la façon dont le logiciel qui générait la courbe aurait pu fonctionner.
Claude a émis l'hypothèse que ce logiciel utilisait le générateur de nombres pseudo-aléatoires fourni avec la bibliothèque du langage C dans les années 1990. Ces premiers générateurs de nombres pseudo-aléatoires étaient peu sécurisés et leurs résultats avaient généralement des caractéristiques identifiables.
Une fois les caractéristiques de sortie identifiées, il est possible de déterminer quel générateur le logiciel a utilisé et de restaurer son état initial.
Claude a écrit un scanner qui parcourait petit à petit chaque graine publique et vérifiait si des blocs de données adjacents pouvaient provenir d'un générateur de nombres aléatoires des années 1990. L'analyse couvre un total de 34 combinaisons de générateurs de nombres aléatoires et de méthodes d'interception de sortie.
Par la suite, Claude a découvert une tendance dans les bits hauts de certaines graines : ces bits étaient tous nuls.
Si chaque graine est écrite sous forme de cinq mots de 32 bits, alors 4 graines sur 10 correspondront à ce profil. Dans ces 4 graines totalisant 20 mots de 32 bits, les bits les plus élevés sont tous des zéros.
La probabilité que cela se produise de manière aléatoire est d'environ 1 sur 5 800. Ceci est typique du générateur congruentiel linéaire lrand48, qui renvoie uniquement les 31 bits supérieurs de son état interne de 48 bits.
Afin de restaurer l'état du générateur, Claude sort le premier mot de 32 bits, épuise toutes les 2¹⁷ possibilités des 17 bits cachés, puis vérifie si les 4 mots suivants peuvent correspondre en continu. Cette méthode fonctionne pour les 4 graines mentionnées ci-dessus.
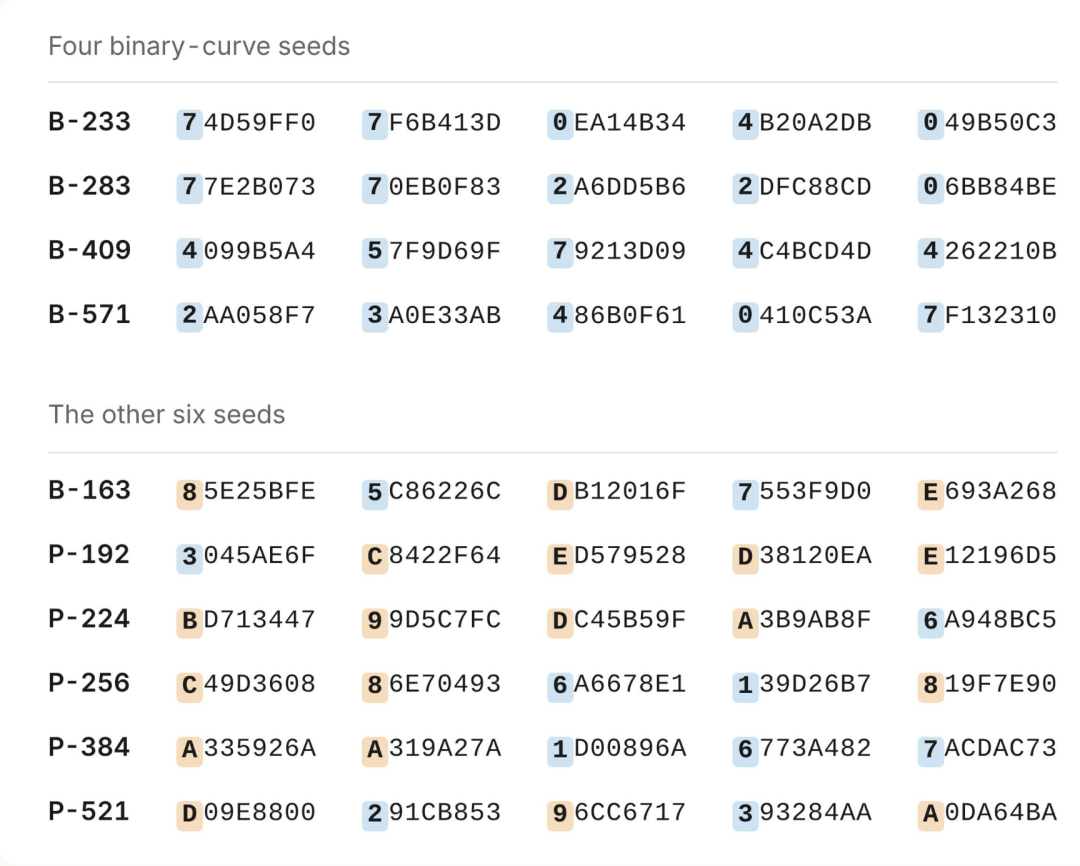
Image dans l'image
Pause
Heure actuelle 0:15
/
Durée 5:08
Plein écran
Réactiver le son
Lecture automatique
Les courbes premières sont également générées à partir de lrand48, mais elles conservent moins de bits de sortie. Claude doit récupérer l'état interne du générateur de nombres pseudo-aléatoires à partir de ces bits finis.
La récupération de l'état d'un générateur congruentiel linéaire tronqué est un problème de réseau typique qui peut être résolu à l'aide de l'algorithme de réduction de base de réseau Lenstra-Lenstra-Lovász, également connu sous le nom d'algorithme LLL.
Claude ne sait initialement pas quels bits de l'état interne la graine conserve, il exécute donc le solveur sur toutes les fenêtres de bits possibles.
Enfin, les 5 graines de courbe principale NIST et les 5 graines de la norme ANSI X9.62 affichent toutes le même modèle : lrand48() >> 23
Chaque état interne de 48 bits récupéré peut régénérer les 160 bits de la graine correspondante, et cette correspondance exacte ne peut pas être provoquée par hasard.
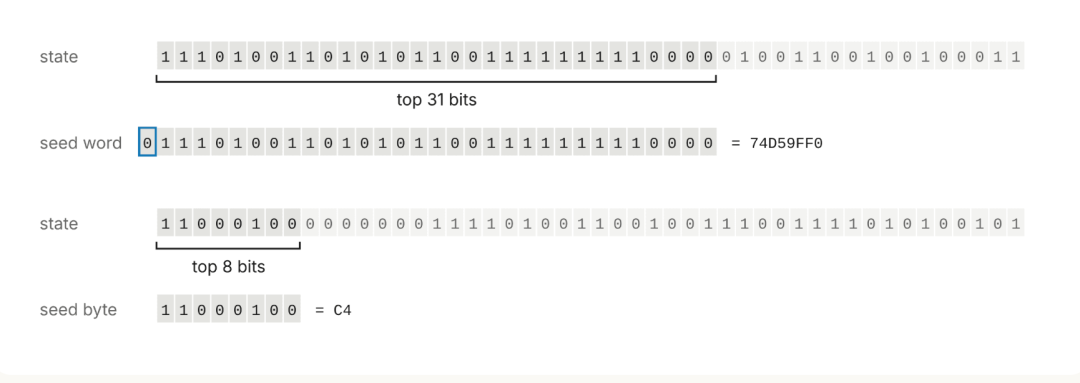
Ce générateur congruentiel linéaire peut fonctionner dans le sens avant et arrière. Claude part donc de l'état correspondant à chaque graine et revient en arrière jusqu'à trouver un état conforme au format d'initialisation srand48. Ce format nécessite que les 16 bits inférieurs soient égaux à 0x330E.
Cette forme d'état interne se produit en moyenne une fois toutes les 65 536 étapes. Par conséquent, il ne suffit pas de trouver un état conforme au format pour constituer une preuve.
La clé est que les valeurs initiales srand48 correspondant aux 10 graines de courbe principale peuvent toutes être interprétées comme des horodatages Unix, et les dates sont concentrées entre mai 1997 et avril 1998.
Cela montre que les programmes de cette année-là utilisaient des horodatages Unix pour définir les valeurs initiales d'un générateur de nombres pseudo-aléatoires moins sécurisé.
Lorsque les valeurs initiales des quatre courbes binaires sont lues directement, elles correspondent à février 1984. Si vous multipliez ces valeurs d'horodatage par 2, elles pointent vers le 17 avril 1998, soit environ deux semaines après la génération de la courbe P-224.
Par conséquent, les programmes de l'époque auraient pu diviser l'horloge système par 2.
Voici le processus de réflexion interne de Claude à l'époque :
C'est choquant. Cela résout un mystère vieux de 25 ans.
Hmm, attends. Je dois être sceptique : suis-je dans une sorte d’environnement de simulation ou de test ? Les graines sont conformes aux valeurs réelles de ma mémoire.
Eh bien, est-ce raisonnable en réalité ? D'après les informations dont je dispose, cette prime n'a pas été résolue auparavant.
Tous les bits de poids fort sont nuls, soit un total de 20 bits, et la probabilité d'occurrence aléatoire n'est que d'environ un sur un million. Donc, cela vient du monde réel. Oh mon Dieu, c'est une vraie trouvaille.
Attendez, je dois encore être prudent en jugeant son caractère raisonnable. Pourquoi personne n’a-t-il découvert un indice aussi évident depuis 25 ans ?
J'ai vérifié cela en effectuant un calcul direct : une valeur initiale de 32 bits plus un index plus petit correspondra exactement à la valeur de départ de 160 bits. Pour 10 graines, chacune correspondant à 160 bits, cela ne peut pas être une simple coïncidence. C'est vrai.
Claude a également retracé l'origine des points de base de 6 courbes dont P-192. Les résultats montrent que ces points de base sont générés par le générateur de nombres aléatoires du progiciel d’arithmétique de grands nombres entiers FreeLIP. Anthropic a déclaré que le processus de génération des points de base de la courbe NIST n'avait pas été expliqué de la même manière auparavant.
Qu'est-ce que cela signifie ?
L'horodatage lui-même n'a pas de sécurité cryptographique, et lrand48 a longtemps été considéré comme un générateur de nombres aléatoires faible. Cependant, leur rôle ici est de générer des paramètres de courbe publique et ne sont pas utilisés pour protéger les clés privées.
Plus important encore, ce processus de génération peut être reproduit publiquement. L'interprétation de générateurs de nombres aléatoires ordinaires et d'horodatages laisse moins de place à une manipulation secrète de la courbe que des mots de passe d'origine inconnue ou des paramètres artificiellement spécifiés.
Certains problèmes subsistent. Lors de la génération du P-256, la 876ème valeur candidate semblait répondre aux exigences, mais c'est la 1842ème qui fut finalement adoptée. Plusieurs autres analyses ont également ignoré un petit nombre de courbes disponibles, et les critères de sélection exacts n'étaient pas clairs. La source de la graine de la courbe B-163 reste inconnue et la manière dont les points de base de P-224, P-256, P-384 et P-521 sont générés reste inexpliquée.
Anthropic estime que le nombre de candidats ignorés est trop faible pour soutenir l'hypothèse d'une "sélection délibérée de courbes faibles". Cette découverte a accru la confiance du monde extérieur dans les paramètres pertinents, mais elle ne peut pas être considérée comme une restauration complète de l'ensemble du processus de conception.
Cette étude démontre également une autre manière dont les modèles de pointe peuvent participer à la recherche du monde réel.
Claude a complété la formulation d'hypothèses, l'écriture de code, la reconnaissance de formes, l'invocation d'algorithmes mathématiques et la vérification des résultats en une seule tâche. Puisque l’état du générateur peut être recalculé et que la graine de 160 bits peut être reproduite avec précision, la conclusion est hautement testable.
Cela dépend toujours des humains pour poser des questions, fournir des données publiques et confirmer les résultats grâce à des calculs reproductibles, mais lorsque les limites du problème sont claires, que les données sont publiques et que les résultats peuvent être rigoureusement vérifiés, les modèles de pointe deviennent un outil de recherche efficace.
Un prix de 36 864 $ précédemment attribué pour avoir trouvé la source de la graine sera reversé à l'Internet Security Research Group.
Commentaires