
Résumé :
Une expérience réalisée par un développeur montre que la connexion de l'iPhone 17 Pro Max à un MacBook Pro équipé d'une puce M4 Pro via un logiciel personnalisé peut améliorer considérablement l'efficacité opérationnelle du modèle local à grand langage. Lors de l'exécution du modèle Qwen3.8-27B, les performances de pré-remplissage du système sont améliorées jusqu'à 44 %.
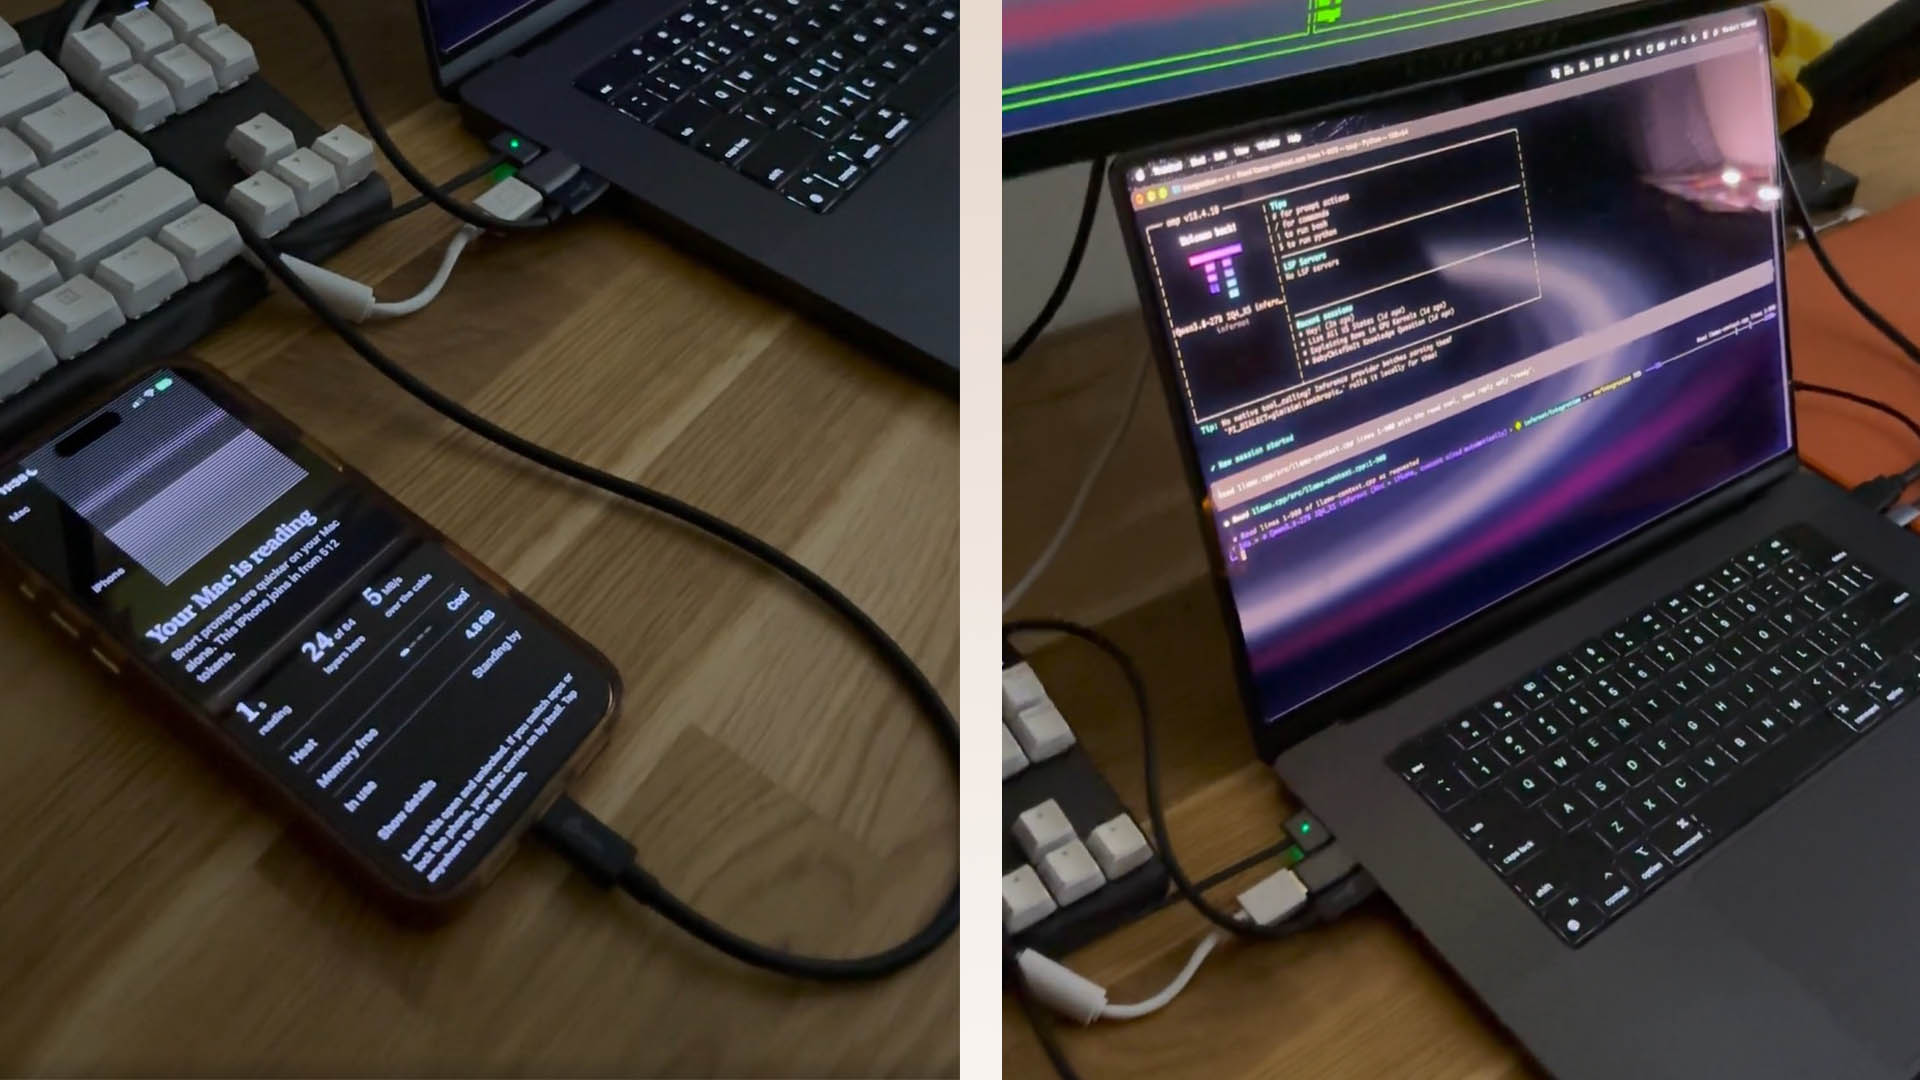
Le contexte de cette expérience est que les grands modèles de langage ont des exigences extrêmement élevées en matière de mémoire vidéo et de capacité de mémoire système. Bien que le MacBook Pro équipé de la puce M4 Pro dispose de 24 Go de mémoire unifiée, il reste limité par la capacité de mémoire et la taille de la fenêtre contextuelle lors de l'exécution d'un grand modèle avec 27 milliards de niveaux de paramètres. Les développeurs ont donc essayé d'utiliser l'iPhone 17 Pro Max comme nœud informatique supplémentaire pour exécuter des modèles en conjonction avec le MacBook Pro via l'interface USB-C.
Selon le plan annoncé par le développeur, le MacBook Pro est responsable du traitement des tâches informatiques de la couche 1 à la couche 40 dans chaque lot de 256 jetons et transmet les données d'activation intermédiaires à l'iPhone en temps réel. Par la suite, l'iPhone 17 Pro Max utilise le GPU de la puce A19 Pro pour continuer à effectuer les opérations de la couche 41 à la couche 64, tandis que le Mac commence à traiter simultanément le prochain lot de données. Grâce à cette division du travail en pipeline, deux appareils peuvent participer simultanément au processus d’inférence du modèle.
Les résultats expérimentaux montrent que par rapport à l'exécution du modèle uniquement sur MacBook Pro, la vitesse de pré-remplissage est considérablement améliorée après l'introduction de l'iPhone. Sous la fenêtre contextuelle 8K, la vitesse de traitement passe de 132 jetons par seconde à 177 jetons, soit une augmentation de 35 % ; sous la fenêtre contextuelle 16K, les performances passent de 109 jetons par seconde à 157 jetons, soit une augmentation de 44 % ; dans le scénario de fenêtre contextuelle de 32 000, la vitesse de traitement passe de 101 jetons par seconde à 130 jetons, soit une augmentation d'environ 29 %.
En plus du calcul collaboratif GPU, le moteur de réseau neuronal de la puce A19 Pro participe également à certaines tâches. Les développeurs ont déclaré que chaque contexte historique de 16 000 sera converti en un modèle de réseau neuronal dédié pour le traitement. À l'échelle de contexte de 140 000 jetons, le temps d'écriture d'un seul jeton est réduit de 279 millisecondes en s'appuyant uniquement sur le GPU à 176 millisecondes, améliorant encore l'efficacité opérationnelle dans les scénarios de contexte long.
Cependant, cette solution n'est pas sans limites. Les développeurs ont souligné que l'iPhone contribue principalement à améliorer les performances de l'étape de pré-remplissage, tandis que dans les tâches de génération de texte inférieures à 64 Ko, la majeure partie du travail de raisonnement réel est encore principalement effectuée par le Mac. De plus, cette solution nécessite un support logiciel spécialement développé et n'est actuellement pas adaptée à un déploiement direct par des utilisateurs ordinaires.
Néanmoins, cette expérience démontre le potentiel des appareils Apple grand public pour l'informatique IA locale. À mesure que les performances des puces mobiles continuent de s'améliorer, un système informatique collaboratif plus flexible pourrait être formé à l'avenir entre les smartphones, les tablettes et les ordinateurs personnels, réduisant ainsi le recours à une configuration matérielle unique pour exécuter de grands modèles d'intelligence artificielle.
Commentaires