
Résumé :
Le développeur Linux Osama Arif a soumis deux correctifs à la liste de diffusion du noyau visant à réduire les conflits de requêtes lorsque zswap charge les pages d'échange. Zswap est le mécanisme de cache de compression de Linux. Il compresse les pages à échanger et les stocke temporairement dans la mémoire. Si les pages peuvent être lues à partir du cache de compression, l'accès au périphérique d'échange peut être réduit, ce qui est particulièrement utile pour alléger la pression des E/S sur le disque lorsque la mémoire est limitée.
Le problème est que le code existant fait en sorte que les écritures et les lectures compressées partagent des requêtes de compression asynchrones par CPU et des verrous mutex. Si une tâche d'écriture de faible priorité est anticipée pendant la période de verrouillage, une tâche de lecture de haute priorité peut également être forcée d'attendre. Le premier correctif définit respectivement les requêtes, les objets d'attente et les verrous mutex pour la compression et la décompression, de sorte que la lecture ne soit plus bloquée par les tâches d'écriture ; le deuxième correctif permet à l'algorithme de compression logicielle synchrone d'utiliser des requêtes sur la pile pour contourner davantage le verrou zswap. Les algorithmes qui nécessitent un traitement asynchrone ou un contexte de requête supplémentaire utilisent toujours des requêtes par CPU et des verrous mutex.
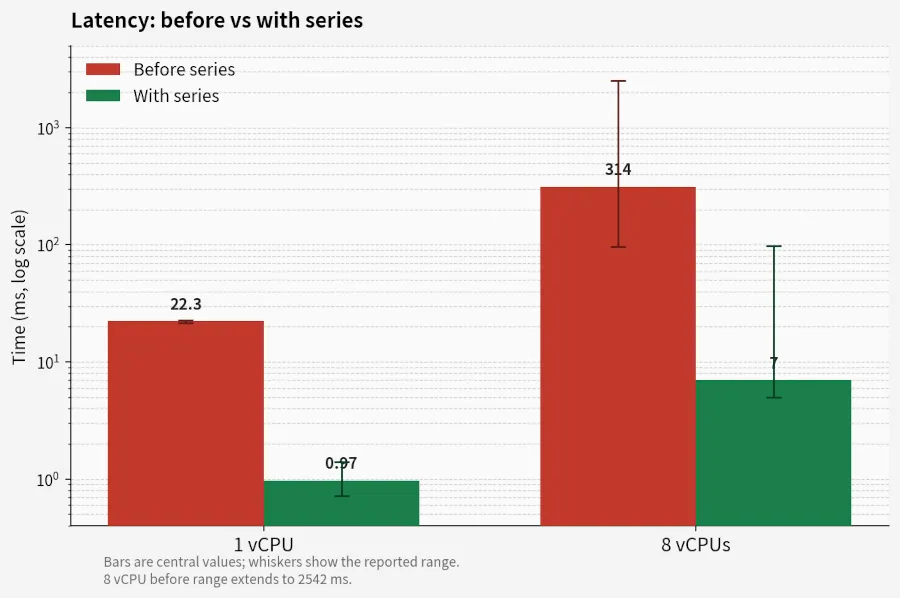
Les tests de référence publiés par l'auteur du correctif montrent que dans un environnement de processeur virtuel unique, la latence médiane de lecture la plus lente par tour est passée de 22,3 millisecondes à 0,97 milliseconde ; dans un environnement à 8 processeurs virtuels, il est passé de 314 millisecondes à 7 millisecondes. Chaque test a été exécuté pendant 5 tours, en utilisant le compresseur zstd, la machine virtuelle et le disque mémoire comme périphériques de commutation, et en créant une charge via différentes tâches prioritaires ; le nombre de lectures dépassant 10 millisecondes a également été réduit de 26 à 35 fois par tour dans un seul cœur à zéro, et dans un environnement multicœur, il a été réduit de 3 à 18 fois par tour jusqu'à un maximum d'une fois. Les auteurs affirment que les benchmarks et les programmes de test sont écrits à l’aide de grands modèles de langage.
Ces chiffres reflètent les améliorations de la latence de lecture lors de tests de stress spécifiques et ne signifient pas que tous les appareils Linux ou charges de travail quotidiennes connaîtront la même accélération globale.
Le correctif est encore en phase de révision de la liste de diffusion du noyau et n'a pas encore été fusionné dans le noyau principal :
https://lore.kernel.org/lkml/
[email protégé]
/
Commentaires