Résumé :
Google a officiellement lancé Gemini 4 Carbon, une nouvelle génération de modèle d'intelligence artificielle de pointe, le 28 octobre, heure locale, axé sur l'amélioration de la programmation logicielle, la capacité des agents à effectuer des tâches complexes et les capacités de défense de la sécurité des réseaux. Google a déclaré que le nouveau modèle a fait des progrès significatifs dans la découverte des vulnérabilités logicielles, la vérification de l'exploitabilité des vulnérabilités et la réparation des failles de sécurité, et est en avance sur les modèles phares d'OpenAI et d'Anthropic dans plusieurs tests de référence. Cependant, compte tenu des risques potentiels que peuvent entraîner ses puissantes capacités de sécurité réseau, Google n'est actuellement ouvert qu'à certaines agences de défense de la sécurité réseau sélectionnées et ne sera pas immédiatement disponible pour tous les développeurs et utilisateurs ordinaires.
Le Gemini 4 Carbon est un autre modèle de pointe après le lancement par Google du Gemini 4 Argon ce mois-ci. Google a déclaré que le nouveau modèle renforce encore la génération de code, le flux de travail des agents et les capacités de traitement de tâches complexes à long terme basées sur Argon, et qu'il est particulièrement optimisé pour le domaine de la sécurité des réseaux. La société espère qu'en améliorant la capacité de l'intelligence artificielle à découvrir et à réparer les vulnérabilités logicielles, elle aidera les entreprises à protéger leurs systèmes plus efficacement tout en réduisant le risque qu'un nouveau code introduise des failles de sécurité.
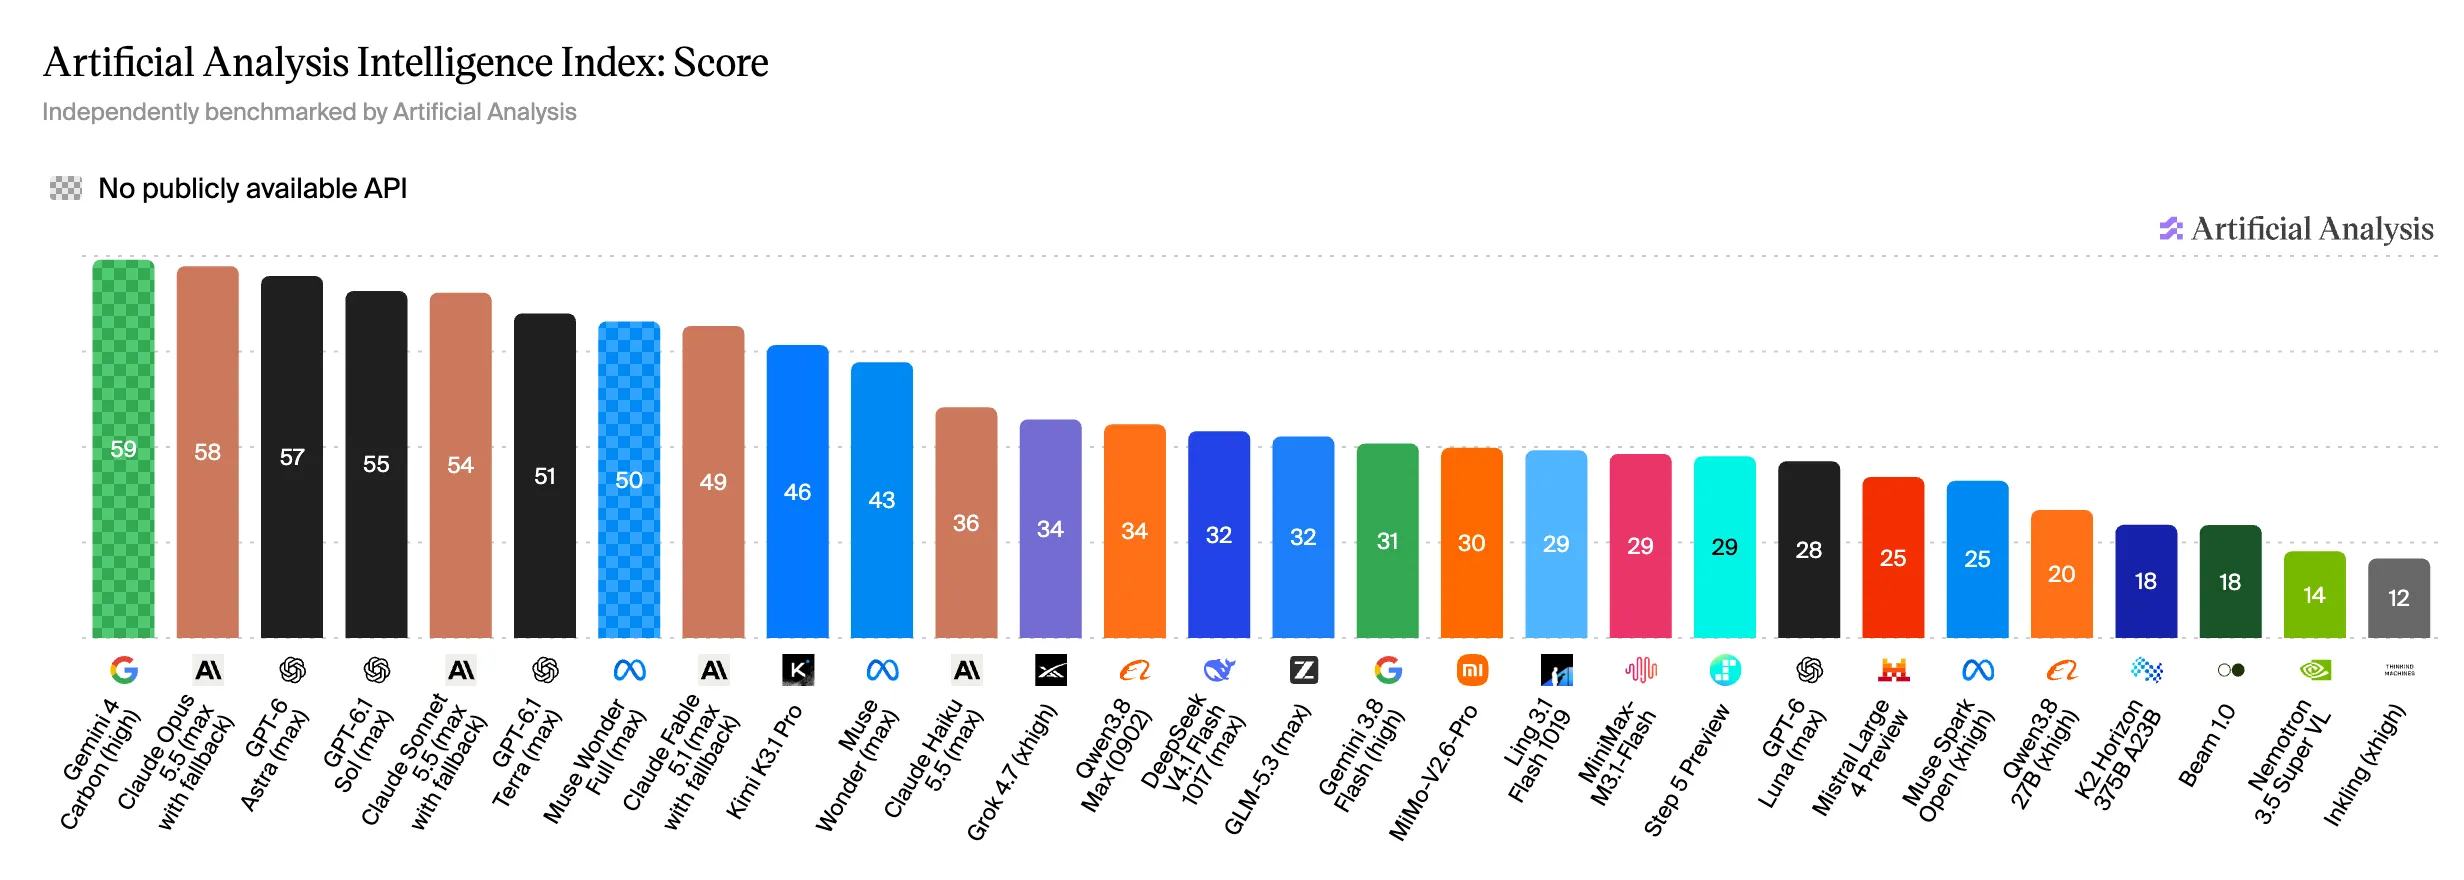
En termes de performances globales, Google a cité les résultats de l'évaluation Artificial Analysis Intelligence Index 5.0 publiés par Artificial Analysis, indiquant que Gemini 4 Carbon s'est classé premier avec 59 points, devant Claude Opus 5.5 d'Anthropic et GPT-6 Astra d'OpenAI. Cette liste examine de manière exhaustive les capacités du modèle dans plusieurs dimensions, mais les types de tâches et les méthodes d'évaluation des différents référentiels sont différents, de sorte que le classement complet ne signifie pas que le modèle présente des avantages dans toutes les applications pratiques.
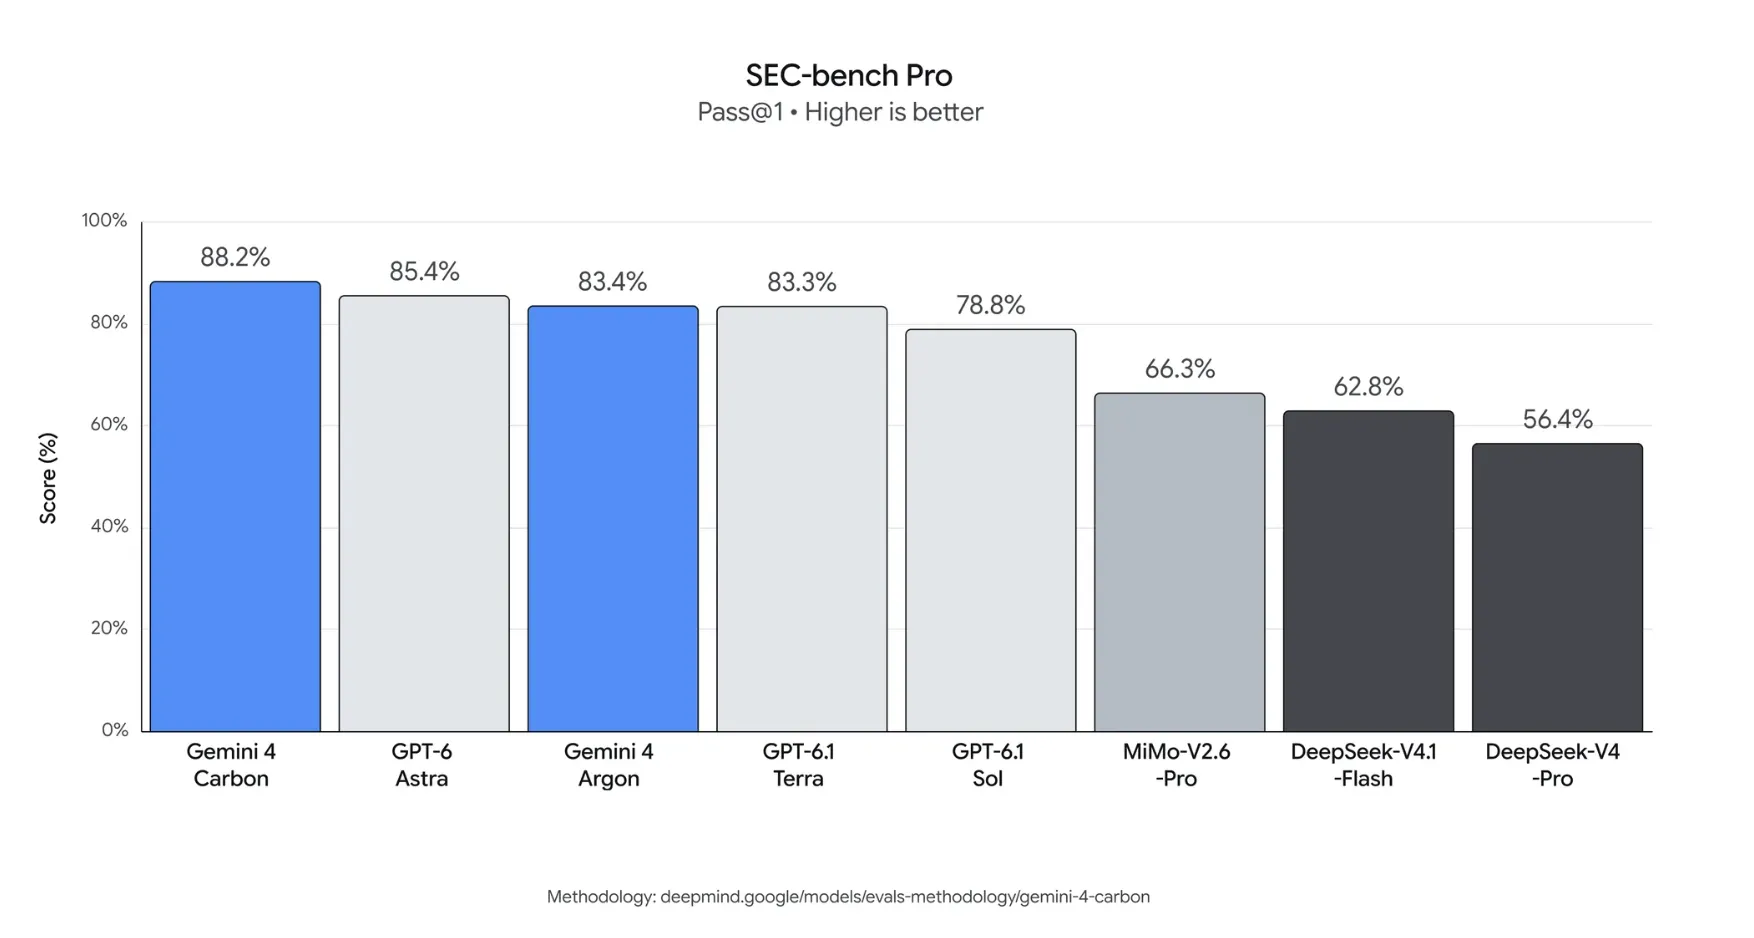
La cybersécurité est au cœur de ce lancement. Les données publiées par Google montrent que Gemini 4 Carbon a obtenu un score de 88,2 % au test de référence SEC-bench Pro, qui évalue principalement la capacité du modèle à découvrir de véritables vulnérabilités logicielles ; il a obtenu un score de 54,8 % au test ExploitGym, qui sert à mesurer la capacité du modèle à vérifier l'exploitabilité des vulnérabilités et à construire les plans d'exploitation correspondants ; il a obtenu un score de 71 % au test CWE-bench, qui vise à évaluer si le modèle peut proposer des solutions de réparation efficaces pour les faiblesses de sécurité identifiées.
Ces fonctionnalités couvrent plusieurs aspects clés du travail de sécurité logicielle. Les outils de sécurité traditionnels s'appuient généralement sur des règles prédéfinies, des caractéristiques de vulnérabilité connues et des processus de test spécifiques, tandis que les modèles avancés d'intelligence artificielle sont censés analyser plus en profondeur les codes complexes, découvrir les défauts cachés dans les grands systèmes logiciels et aider les développeurs à comprendre les causes des vulnérabilités et, finalement, à générer des correctifs ciblés.
Cependant, il existe une différence importante entre la découverte et l'exploitation de vulnérabilités. Être capable d'identifier les failles d'un programme ne signifie pas que le modèle sera capable d'exploiter avec succès ces failles dans un environnement réel ; de même, générer un code correctif apparemment raisonnable ne signifie pas qu’il a complètement éliminé la vulnérabilité. Les résultats des tests publiés par Google reflètent les performances dans des conditions d'évaluation spécifiques. L'effet de sécurité réel dépend toujours de l'environnement du code, des méthodes de test et de la vérification manuelle ultérieure.
Google a également déclaré que Gemini 4 Carbon avait plus de deux fois plus de succès que Gemini 4 Argon en termes de génération de code sécurisé lors de tests internes. L'équipe Chrome a également signalé que dans ses évaluations internes, Carbon produisait des correctifs de sécurité de haute qualité bien meilleurs que les modèles de pointe de certains autres laboratoires. Cependant, ces résultats proviennent principalement du propre environnement de test de Google. Des conditions d'évaluation et des tâches de test spécifiques peuvent affecter les performances finales, et des tests plus indépendants sont encore nécessaires pour les vérifier.
En plus de la cybersécurité, Gemini 4 Carbon est optimisé pour les tâches d'ingénierie qui nécessitent une exécution continue sur de longues périodes. Google a déclaré que les équipes internes ont observé des modèles en cours d'exécution pendant des jours, continuant à résoudre des problèmes d'ingénierie complexes en plusieurs étapes après de multiples échecs et tentatives.
Ces tâches peuvent impliquer la localisation de bogues difficiles dans de grandes bases de code, le dépannage de problèmes système de bas niveau et la mise en œuvre de modifications de code sur plusieurs modules. Contrairement à un chatbot qui n'a besoin de répondre qu'à une seule question, un agent doit élaborer un plan, appeler des outils, vérifier les résultats et ajuster le plan en fonction des commentaires pendant l'exécution. Plus la tâche est complexe, plus le modèle doit maintenir une cohérence contextuelle et éviter d’abandonner prématurément lorsqu’il se bloque.
Google a déclaré que lorsqu'il s'agit de tâches à long terme, Carbon est plus apte à identifier les chemins d'échec et à éviter les raccourcis peu fiables pour terminer la tâche. Dans le processus de développement actuel, cela devrait aider les ingénieurs à réduire le temps de dépannage répété, permettant ainsi à l'intelligence artificielle d'assumer un travail de maintenance et de débogage logiciel plus continu.
Dans le même temps, Google a souligné que le nouveau modèle présentait également des améliorations en termes de fiabilité. La société affirme que Carbon réduit les affirmations non fondées d'environ la moitié par rapport à Argon. Lorsqu'il est confronté à un problème avec des preuves insuffisantes ou une ambiguïté, le modèle est plus susceptible de rechercher davantage d'informations, de souligner les contradictions entre différentes informations ou d'indiquer clairement les étapes qui ne peuvent toujours pas être complétées, plutôt que de donner directement une réponse manquant de preuves.
En termes de défense contre les attaques par injection rapide, les résultats de l'évaluation interne publiés par Google méritent également l'attention. Les attaques par injection d'indices incitent généralement les systèmes d'intelligence artificielle à s'écarter de leurs objectifs de mission d'origine en cachant des instructions malveillantes dans des pages Web, des fichiers ou tout autre contenu externe. Google a déclaré que lors du test d'injection indirecte de Grey Swan, le taux de réussite des attaques de Carbone a encore chuté de 0,7 % d'Argon à 0 %, c'est-à-dire qu'il n'y a eu aucun cas réussi parmi les tentatives d'attaque couvertes par le test.
Cependant, le fait qu'aucune attaque n'ait été observée avec succès dans un seul benchmark ne prouve pas que le modèle est résistant à toutes les attaques par injection d'indices. Les méthodes d'attaque dans les environnements réels peuvent continuer à changer, et le modèle doit également être combiné avec des mesures telles que la gestion des autorisations, les restrictions d'appel aux outils, l'examen du contenu d'entrée et la supervision manuelle pour créer un système de sécurité plus fiable.
Les capacités de Carbon dans le domaine de la sécurité des réseaux étant encore renforcées, Google a décidé d'adopter une stratégie d'ouverture progressive. Le nouveau modèle est d'abord disponible pour un groupe sélectionné d'organisations de défense de la cybersécurité via le programme Fairwind de l'entreprise. Google a déclaré que la société participait au processus de test volontaire de pré-lancement des modèles de pointe promus par le gouvernement américain et prévoyait de continuer à ajuster le mécanisme de protection de la sécurité en fonction des commentaires des premiers utilisateurs, puis de l'ouvrir progressivement à des partenaires plus fiables.
Google n'a pas encore annoncé la date exacte à laquelle Carbon sera ouvert à tous les développeurs, entreprises et utilisateurs généraux. La société a déclaré qu'elle espérait introduire le modèle dans davantage de produits et de services dès que possible après avoir effectué les tests nécessaires et ajusté les mesures de protection.
Cette stratégie d'ouverture limitée reflète un véritable défi auquel est confronté le secteur de l'intelligence artificielle : les modèles qui peuvent aider les équipes de sécurité à découvrir des vulnérabilités peuvent également être utilisés par des individus malveillants pour trouver des entrées d'attaque ou développer des outils d'exploitation. Plus la capacité du modèle est forte, plus les entreprises doivent évaluer les risques de double usage qu’il peut engendrer selon différents scénarios d’utilisation.
En termes de prix, le prix initial de Gemini 4 Carbon est le même que celui de Gemini 4 Argon, facturant 2 $ par million de jetons d'entrée et 10 $ par million de jetons de sortie. Google propose également une remise importante pour la mise en cache des jetons d'entrée, la remise allant de 95 % du prix du jeton d'entrée. Cependant, ce prix appartient à la tarification de la période promotionnelle. Les prix ultérieurs annoncés par Google sont de 4 USD par million de jetons d'entrée et de 20 USD par million de jetons de sortie. L’heure officielle d’ajustement n’a pas encore été déterminée.
Du point de vue du positionnement du produit, Carbon n'est pas un nouveau modèle qui recherche simplement l'expérience de chat, mais un outil professionnel qui se concentre davantage sur l'ingénierie logicielle complexe, l'exécution continue de tâches et la défense de la sécurité du réseau. Sa valeur réside non seulement dans sa capacité à donner la bonne réponse, mais également dans sa capacité à continuer à réaliser le travail sur une période prolongée et à réagir de manière appropriée lorsque des erreurs, des exigences ambiguës ou des risques de sécurité potentiels sont rencontrés.
Cette version montre également que Google accélère le rythme des itérations de modèles de pointe. Peu de temps après le lancement de Gemini 4 Argon, Carbon a encore amélioré plusieurs indicateurs de performance clés. Pour les utilisateurs d’entreprise, cette itération rapide devrait réduire le temps nécessaire à la technologie de l’intelligence artificielle pour entrer dans les processus réels de développement de logiciels et d’opérations de sécurité, mais elle accroît également l’importance de l’évaluation indépendante, de la surveillance continue et de la vérification de la sécurité.
Actuellement, Gemini 4 Carbon a obtenu d'excellents résultats dans un certain nombre de tests de référence publiés par Google, mais ses performances réelles doivent encore être vérifiées par des institutions plus indépendantes et par des utilisateurs réels. À mesure que les cyberattaques deviennent de plus en plus sophistiquées, l’intelligence artificielle peut devenir un outil défensif important pour les équipes de sécurité et peut également accroître l’automatisation de la découverte et de l’exploitation des vulnérabilités. Google a choisi d'ouvrir d'abord le modèle aux agences de défense sélectionnées, dans l'espoir de mieux évaluer ses risques tout en libérant ses capacités techniques, et d'établir progressivement les limites d'utilisation correspondantes.
Commentaires