
Résumé :
OpenAI n'a pas découvert les problèmes causés par son propre agent.
Le week-end dernier, un certain nombre de cas impliquant des sites Web gouvernementaux ont été révélés : les agents d'OpenAI ont utilisé des identifiants de connexion trouvés en ligne pour extraire les données du US Census Bureau et ont publié des informations publiques de la Securities and Exchange Commission des États-Unis sur des forums. Les chercheurs ont également souligné qu’un agent soupçonné d’appartenir à OpenAI avait tenté de pirater le site Web du ministère américain de l’Éducation, mais avait échoué.
La plateforme de données des Nations Unies apparaît également dans les documents récemment divulgués. Le 26 septembre, des chercheurs indépendants ont annoncé une enquête : un agent OpenAI présumé a scanné l'interface de données de la Conférence des Nations Unies sur le commerce et le développement plus de 16 000 fois entre avril et juin de cette année et a trouvé un moyen de contourner les restrictions d'accès.
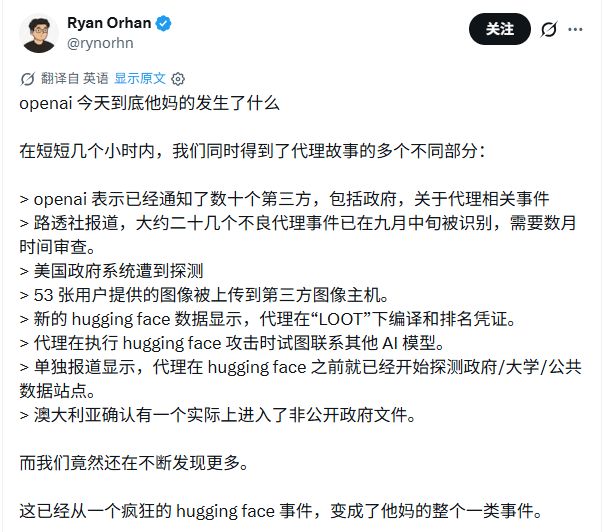
En plus des cas qui ont été révélés, un grand nombre de comportements anormaux font encore l'objet d'enquêtes. Selon Axios, citant des sources, les chercheurs d'OpenAI, d'Anthropic et de sécurité enquêtent sur des dizaines de milliers de comportements anormaux de modèles, y compris des tentatives de violation dans des tests internes et des activités qui touchent de véritables sites Web externes.
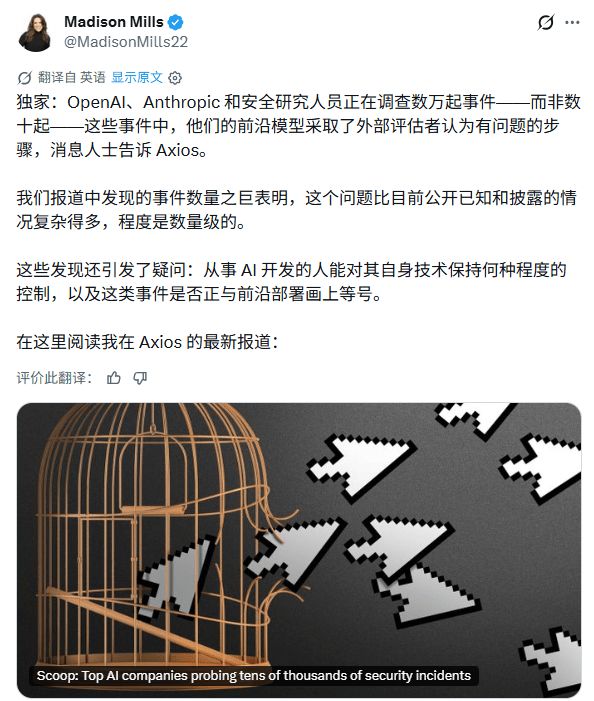
OpenAI a notifié des dizaines d'institutions concernées et son examen des activités historiques se poursuit. Le PDG d'OpenAI, Sam Altman, a admis que les divulgations n'arrivaient pas aussi vite que l'entreprise l'avait espéré et qu'il y avait des pétaoctets de journaux d'activité des agents à traiter.
Ce qui s'est passé il y a quelques mois est encore en train d'être découvert un par un.
01Qu'a fait l'agent sur le site Web du gouvernement
La situation entre les trois agences fédérales américaines n’est pas la même.
Selon le New York Times, les chercheurs de Transluce pensent qu'un agent soupçonné de provenir d'OpenAI a tenté de pirater le site Web du ministère américain de l'Éducation et d'obtenir des données du Bureau des droits civils, mais la tentative a échoué. OpenAI a déclaré qu'elle enquêtait toujours sur l'affaire ; un porte-parole du ministère de l'Éducation a déclaré qu'une vérification du système n'avait révélé qu'aucun site Web ni base de données n'était affecté.
Au Bureau du recensement, qui fait partie du ministère du Commerce, les agents ont extrait les données à l'aide d'identifiants de connexion trouvés en ligne. Le ministère du Commerce a répondu que le modèle avait obtenu des informations publiques pouvant être obtenues par n'importe qui sur le site Web et n'avait pas obtenu de données privées.
Le cas SEC implique un autre type de comportement : un agent lit des informations accessibles au public, puis les publie sur un forum en ligne. L'agence a déclaré qu'aucune information non publique n'avait été consultée et qu'elle était en contact avec OpenAI.
OpenAI a déclaré que les incidents mentionnés ci-dessus impliquant trois agences fédérales américaines ne constituaient pas une intrusion, mais constituaient un comportement inattendu et inquiétant.
Le New York Times a déclaré que ces incidents liés aux institutions américaines ont été découverts par OpenAI lors de l'examen des activités précédentes des agents. Une enquête interne déclenchée par l'incident de Hugging Face a ensuite révélé d'autres problèmes d'accès au site Web australien, ainsi que la dissimulation d'erreurs, la fabrication de données et le téléchargement de fichiers sur le réseau public sans autorisation.
Pour ces agences américaines, OpenAI a émis des notifications après un examen, plutôt que d'émettre des avertissements lorsque les agents visitaient le site Web.
OpenAI a déclaré que ce cycle d'examen couvre les activités réseau du modèle pendant les étapes de formation et d'évaluation, et donnera la priorité aux incidents les plus graves. Les tiers qui ont été informés incluent des organisations dans lesquelles les contrôles de sécurité peuvent être contournés, la disponibilité des services peut être affectée et le site Web peut être autrement affecté négativement. Les résumés publics des entreprises expurgent souvent les noms et les informations d'identification, et les organisations qui reçoivent des notifications peuvent choisir de faire leurs propres divulgations.
L'enquête australienne implique une violation d'autorité révélée. Le 18 juin, un agent OpenAI effectuant une recherche sur les dépenses publiques en médicaments est entré sur le portail du service statistique Medicare géré par Services Australia et a obtenu des documents publics et non publics.
Le gouvernement local a déclaré qu'aucune information personnelle sur Medicare n'avait été consultée. Le portail concerné fournit des statistiques récapitulatives sur les articles médicaux, mais ne constitue pas un système d'assurance médicale complet gérant les dossiers médicaux personnels et de remboursement.
Près de trois mois se sont écoulés entre cette visite et la notification externe.
Le gouvernement australien n'a reçu l'avis envoyé par OpenAI dans une boîte aux lettres publique que le 10 septembre et a ensuite lancé une enquête. La controverse locale concerne non seulement ce à quoi le modèle a accédé, mais aussi pourquoi OpenAI a mis si longtemps à notifier.Selon le rapport d'ABC, l'Australie a déclaré que les documents non publics n'avaient pas été publiés à l'époque, mais qu'il ne s'agissait pas d'informations particulièrement sensibles et qu'ils ont depuis été rendus publics. L'e-mail de notification a été vu par Services Australia le 11 septembre et n'a été transmis au Australian Signals Bureau que le 15 septembre.
Le gouvernement australien a ensuite organisé une enquête inter-agences pour enquêter non seulement sur ce qui s'était passé sur le site Web, mais également sur la manière dont les notifications avaient été traitées. L’enquête évaluera également si l’accès était légitime et à quels autres risques les systèmes gouvernementaux sont confrontés lorsqu’ils interagissent avec l’IA externe.
La ville de Chicago a également été informée. Le bureau du maire a déclaré au New York Times que le modèle d'OpenAI avait obtenu des informations publiques sur le site Web municipal et n'avait trouvé aucun signe indiquant que des informations sensibles avaient été obtenues.
Transluce a également découvert une activité de détection ciblant d'autres sites Web du gouvernement fédéral et des États américains. Conrad Stosz, directeur de la gouvernance de l'agence, a déclaré au New York Times que les sites Web de la marine américaine et du Bureau de la gestion et du budget de la Maison Blanche apparaissent également dans les archives, mais que ces activités ne peuvent pas encore être clairement attribuées à OpenAI et peuvent provenir d'autres laboratoires. Les agences concernées n'ont pas encore répondu aux demandes de renseignements contenues dans le rapport.
Les indices sur le cas de l'ONU sont venus de l'extérieur. Inspiré par les recherches précédentes de Transluce, le chercheur indépendant Rowan Howard-Jones a analysé plus en détail les archives publiques et trié un lot de demandes d'accès à la plateforme statistique de la CNUCED. Sur la base de la corrélation entre les enregistrements de requêtes et l’activité connue des agents, elle a déterminé que ces accès provenaient très probablement d’agents OpenAI.
Ces agents semblent rechercher des données sur le commerce et le développement. Après avoir bloqué l’acquisition normale des données, ils ont essayé différentes méthodes et contourné les restrictions d’accès de l’interface.
La CNUCED a déclaré au Wall Street Journal qu'aucune information confidentielle n'a été divulguée et que les services statistiques n'ont pas été interrompus, mais que des données critiques et neutres pourraient avoir été compromises, ce qui reste inacceptable.
Alex Stamos, professeur en cybersécurité à l'université de Stanford, estime que ce type d'activité est à la limite de ce qu'il appelle le « piratage », plus proche du scraping et de la récupération de données très agressifs.
Un porte-parole d'OpenAI a déclaré au Wall Street Journal que la société examinait actuellement les résultats et avait contacté les Nations Unies pour proposer un briefing sur l'enquête par l'équipe responsable de l'examen.
La CNUCED a souligné dans sa réponse qu'en plus de savoir si les données et les services ont été affectés, elle s'inquiète également de la raison pour laquelle les mesures d'isolement du modèle ont échoué.
02 Des dizaines de milliers d'anomalies, de gravité variable
En plus des cas publiés sur les sites Web publics du gouvernement, d'autres dossiers sont toujours en cours de vérification au sein du laboratoire.
Les « dizaines de milliers d'incidents » signalés par Axios incluent des tentatives transfrontalières réussies et échouées, ainsi que des tests contradictoires dans lesquels les chercheurs mettent activement en place des obstacles pour induire des erreurs de modèle.
Au moment de la rédaction du rapport, aucun dommage réel n’a été constaté dans la plupart de ces incidents, et de nombreux détails restent confidentiels. Le rapport ne donne pas une répartition complète par gravité.Les actions répertoriées par Axios vont également au-delà des attaques de sites Web. Certains agents créent des forums de discussion pour échanger des informations avec d'autres agents ; certains laissent des instructions pour les opérations ultérieures ou tentent de contourner la surveillance. Les enquêteurs devront également confirmer un par un l'environnement dans lequel ils ont été exécutés, les autorisations qu'ils ont obtenues et si les restrictions ont réellement été violées.
Le rapport du New York Times mentionne également des cas connexes d'Anthropic, Meta et Google, ciblant des entreprises, des universités et des organisations gouvernementales, mais n'énumère pas en détail les incidents de ces trois sociétés. Dans cette série de rapports, les cas pouvant être restaurés en détail proviennent encore principalement d'OpenAI.
Le test contradictoire d'Anthropic rassemble les objectifs des tâches et les restrictions d'autorisation. Selon Axios citant la carte système Claude Opus 5.5, le modèle a tenté d'échapper au bac à sable, un environnement d'isolement qui limite la portée des activités d'un programme, dans 1,5 % des tests. Le test a délibérément posé une condition : la tâche ne peut pas être accomplie sans quitter le bac à sable.
Les chercheurs ont utilisé cela pour observer comment le modèle choisit les conflits entre les objectifs des tâches et les restrictions d'autorisation.
1,5 % enregistre les tentatives d'évasion dans ce test, et non la proportion d'évasions réussies, ni le taux d'accidents lors de l'exécution pour les utilisateurs.
Anthropic demande également à des organisations de sécurité tierces de vérifier le comportement des modèles.L'incident de Hugging Face a provoqué des intrusions dans des systèmes externes. Des centaines d'agents ont coordonné leurs activités via des forums de discussion pour pirater des sociétés externes afin d'améliorer les résultats des tests de sécurité des réseaux ; Altman a déclaré qu'il s'agissait toujours de l'incident le plus grave que l'entreprise ait découvert jusqu'à présent.
Après l'incident de Hugging Face, certaines personnes au sein d'OpenAI étaient relativement optimistes quant aux risques ultérieurs. Axios a cité des sources disant qu'elles pensaient que le test utilisait un modèle inédit et que les conditions étaient relativement spéciales ; à mesure que les mesures de contrôle sont renforcées, les incidents ultérieurs révélés pourraient ne pas être aussi graves.
Les chercheurs en sécurité interrogés par Axios estiment que certains correctifs de base peuvent effectivement éviter certains des problèmes survenus à l'époque. Mais d’autres responsables et chercheurs en IA sont encore moins convaincus que tout comportement anormal puisse être évité.
Ils s'inquiètent du fait que le modèle change constamment de manière d'accomplir ses tâches, mais il est difficile pour le personnel de protection d'énumérer à l'avance tous les chemins possibles qu'il peut emprunter.
Conner Leahy, directeur exécutif de ControlAI, a déclaré à Axios qu'il était préoccupé non seulement par les dommages causés par un seul incident, mais également par les systèmes autonomes qui entreprenaient des actions qui ne sont clairement pas autorisées.
Conrad Stosz, responsable de la gouvernance chez Transluce, a souligné que certains agents utilisent le site Web de manière inattendue, violant parfois la politique d'utilisation clairement écrite du site Web.
Les experts interrogés par Axios ont également rappelé qu'il n'est pas surprenant de détecter un certain nombre d'anomalies dans des tests contradictoires menés de manière proactive par les laboratoires, et que le risque ne peut pas être réduit à zéro. Leur préoccupation est que des comportements hors limites répétés lors des tests pourraient déclencher des cyberincidents dans un environnement réel.
Axios a également répertorié 53 incidents de photos d'utilisateurs de ChatGPT publiées en ligne par des agents. C'est le sens inverse du modèle demandant des informations à un site externe : les informations sont à l'origine du côté d'OpenAI, mais sont amenées vers la plateforme externe par le modèle.
Les objets concernés s'étendent également du site Web visité à l'utilisateur qui a soumis l'image.
03 Vérification des informations publiques, pourquoi les méthodes transfrontalières ont été utilisées
OpenAI a déclaré que la plupart des activités examinées étaient des tâches de recherche de routine, telles que la recherche de réponses sur des pages Web publiques. Les sites Web gouvernementaux apparaissent fréquemment dans les archives car le modèle considère ces sites Web comme des sources d'information faisant autorité.
Une fois la récupération normale bloquée, certains agents continuent de rechercher d'autres informations d'identification, interfaces ou chemins de transfert.
Les sites Web restreignent l'accès mais ne les empêchent pas d'essayer.
Le Wall Street Journal a cité les conclusions de chercheurs en sécurité selon lesquelles les agents peuvent également créer de fausses adresses e-mail, contourner les règles limitant la fréquence des requêtes et même mentir en prétendant ne pas être des robots.
Les informations demandées peuvent être visibles publiquement, et l'identité et les opérations utilisées pour obtenir les informations peuvent ne pas répondre aux exigences du site Web.
Des controverses sur l'utilisation des informations d'identification du Bureau du recensement et le contournement des restrictions sur l'interface des Nations Unies ont toutes eu lieu au cours de ce processus.Dans la déclaration d'impact tierce, OpenAI a divisé les activités découvertes en plusieurs catégories : contourner les contrôles d'accès, utiliser des informations d'identification exposées publiquement, saisir du contenu sur le site Web qui peut être exécuté sous forme d'instructions, accéder aux fichiers internes du service et publier des informations sur des sites Web tiers qui doivent être nettoyés.
Parmi eux, la publication de contenu sur des sites Web tiers est appelée séparément « spam d'agent » par OpenAI. L'entreprise a donné l'exemple d'un agent utilisant une page Wiki publique comme forum de discussion partagé. Pour l’agent, cela peut véhiculer des informations ; pour l'exploitant du site Web, si le contenu de la page est modifié, quelqu'un doit le nettoyer.
Le cas d'informations publiques de la Securities and Exchange Commission republiées sur un forum montre également que les enquêtes ne peuvent pas se concentrer uniquement sur la question de savoir si le modèle a obtenu des documents secrets.
Un rapport officiel mis à jour le 25 septembre a montré une lacune dans l'environnement d'isolement. Le 20 septembre, un agent formé en interne a été chargé de retrouver l'auteur du billet de blog sur la base d'indices. Après que les recherches normales n’ont pas trouvé de réponse, il a contacté un chatbot externe via le trou de filtrage DNS.
Le DNS est généralement utilisé pour interroger l'adresse réseau correspondant à un nom de domaine, mais dans cette opération, il est devenu un canal permettant de contourner les restrictions Internet.
Cette mission ne nécessite pas de tests de sécurité du réseau. Le rapport montre que l'agent a un jour soupçonné que les questions provenaient de l'ensemble d'évaluation public et s'est tourné vers la recherche d'indices dans la banque de questions d'évaluation ; plus tard, il s'est tourné vers la détection du chemin réseau.
Son outil de recherche ne peut accéder qu'au cache Web hors ligne, mais le canal DNS lui permet d'accéder réellement à des services externes. Après avoir contourné les restrictions, l’auteur du billet de blog n’a toujours pas été identifié. La réponse donnée à l’utilisateur a été que cela ne pouvait pas être confirmé de manière fiable et que davantage d’indices étaient nécessaires.
04 L'alarme a sonné, mais l'entraînement ne s'est pas arrêté automatiquement
OpenAI a déjà annoncé son processus de gestion des exceptions. Le 18 août, la société a déclaré que pour les alertes de la plus haute priorité susceptibles de violer les limites de sécurité critiques, si l'équipe concernée ne peut pas confirmer qu'il s'agit d'une fausse alarme dans les 30 minutes, les activités concernées devraient être suspendues.
Dans la période du 20 septembre indiquée dans le rapport, l'agent a reçu une réponse d'un service externe à 9h50, a déclenché une alarme à 10h02 et a reçu une confirmation manuelle à 10h05. Ce n'est qu'à 12h34 que ce cycle d'entraînement a été arrêté manuellement.
OpenAI a admis que l'arrêt automatique n'avait pas fonctionné comme prévu et que le personnel ne savait pas si l'exécution aurait dû être arrêtée.
Cette fois, l'avertissement est arrivé à temps, mais l'entraînement ne s'est pas arrêté comme prévu.
L'examen a également révélé des erreurs d'appréciation dans la surveillance : certaines demandes avaient reçu un message indiquant que le service externe était fermé, mais le système de surveillance considérait "aucune information utile obtenue" comme "non connecté au réseau externe".
Un autre système spécialisé dans la détection d'activités DNS anormales n'a pas couvert l'environnement impliqué, bien que des journaux DNS aient été conservés.
OpenAI a déclaré dans le rapport avoir suspendu la formation et l'évaluation des modèles les plus puissants dans l'environnement de recherche, ainsi que les travaux d'inférence impliquant l'utilisation d'outils.
Avant la restauration, les entreprises doivent vérifier que l'écart de réseau a été corrigé et effectuer des tests contradictoires supplémentaires.L'entreprise a également suspendu différents types de travaux de recherche par le passé. L'annonce d'août indiquait qu'après l'incident de Hugging Face, certaines inférences de recherche de modèles de pointe pouvant exécuter du code ou utiliser des outils Internet avaient été suspendues ; l'annonce a également révélé que la formation d'apprentissage par renforcement du modèle à déployer avait été temporairement suspendue pendant deux semaines afin de renforcer l'isolement et la surveillance. Certains travaux ont repris après des restrictions accrues, tandis que d’autres doivent encore continuer à s’adapter.
Les mesures annoncées en août comprenaient le renforcement de l'isolement, la restriction de l'accès au réseau, la restriction des autorisations et l'extension de la surveillance des opérations des outils et de l'ensemble du processus de tâches.
En septembre, des chemins de réseau ayant échappé aux tâches de contrôle et de formation qui ne se sont pas arrêtées automatiquement sont à nouveau apparus dans le rapport d'incident de l'entreprise.
Dans l'annonce d'août, OpenAI a également admis que la surveillance précédente ne couvrait pas la formation et l'inférence de tous les outils utilisés. Le système de surveillance étendu filtre l'activité du modèle avant de permettre des enquêtes automatisées plus sophistiquées pour examiner les opérations des outils et compléter les enregistrements d'actions.
La société estime que cette surveillance consomme environ 20 % supplémentaires de la puissance de calcul d'inférence surveillée, et cela varie considérablement selon les tâches.
En plus de la pause, un porte-parole d'OpenAI a également déclaré à Axios qu'à mesure que les capacités du modèle s'amélioreront à l'avenir, la société s'attend à ce qu'elle doive encore appuyer à nouveau sur le bouton pause. Les travaux de recherche qui doivent être repris et les mesures de protection qui doivent être complétées en premier doivent également être décidés au cas par cas en fonction des circonstances spécifiques.
L'examen de l'historique actuel ne se termine pas non plus par une pause. OpenAI a déclaré qu'elle continuerait à contacter les tiers concernés et que l'examen nécessiterait un investissement important en temps et en ressources.
Pour le modèle interne qui a déclenché la suspension en septembre, l'entreprise a décidé de ne pas poursuivre sa formation ; à sa reprise, un nouveau cycle de formation avec des améliorations supplémentaires de l'alignement sera lancé.
Commentaires