
Résumé :
Pour les utilisateurs Windows qui souhaitent exécuter des modèles d'intelligence artificielle sur leur propre ordinateur, il existe toujours un certain seuil pour l'installation et la configuration des outils d'IA locaux. Les utilisateurs doivent non seulement trouver les fichiers de modèle appropriés, mais également prendre en compte des problèmes tels que le format du modèle, la compatibilité matérielle, l'installation du moteur d'inférence et les paramètres de démarrage. Aujourd'hui, l'application open source Llama pour Windows, lancée par des développeurs liés aux équipes Hugging Face et llama.cpp, tente de simplifier ce processus en quelques opérations simples, permettant aux utilisateurs de télécharger et d'exécuter de grands modèles de langage locaux sur des ordinateurs Windows sans utiliser la ligne de commande.
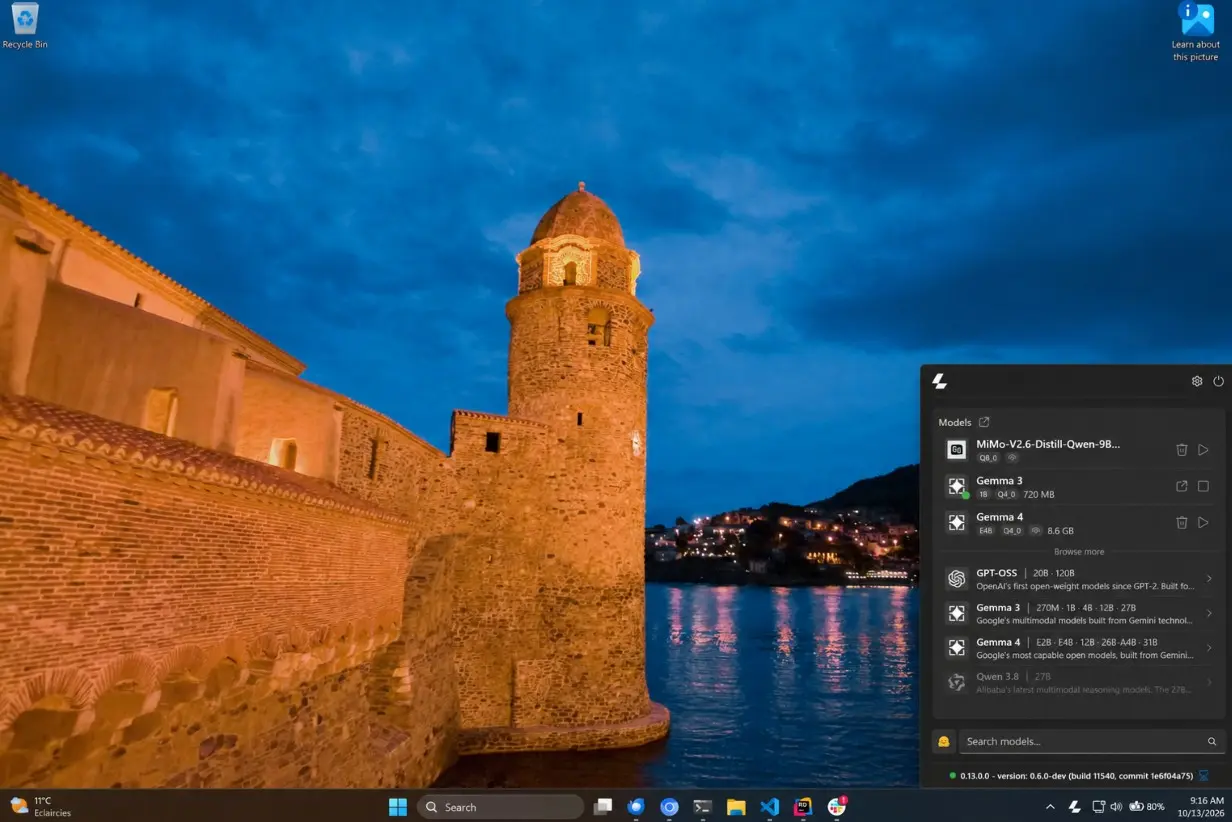
Llama pour Windows sera lancé en octobre 2026 et est le pendant Windows de la version macOS de l'application Llama. Il s'agit d'une application Windows 11 gratuite et open source construite sur la technologie WinUI 3 de Microsoft et qui s'exécute principalement dans la zone de notification du système. Une fois que les utilisateurs l'ont installé, ils peuvent ouvrir le panneau de configuration via l'icône de l'application dans la zone de notification de la barre des tâches, sans avoir à conserver une fenêtre indépendante comme les logiciels traditionnels.
La caractéristique la plus importante de cette application est sa capacité à se connecter directement à l'entrepôt de modèles Hugging Face. Hugging Face est actuellement une importante plateforme d'hébergement de modèles d'intelligence artificielle open source, regroupant un grand nombre de modèles et leurs versions dérivées provenant de différentes équipes de développement. Dans le passé, les utilisateurs devaient généralement trouver eux-mêmes un fichier de modèle approprié, déterminer si le format de fichier était correct, puis télécharger la version correspondante et la démarrer via le moteur d'inférence. Pour l’utilisateur moyen qui n’est pas familier avec la technologie de l’intelligence artificielle, ce processus peut être assez fastidieux.
Llama pour Windows fournit une liste de modèles recommandés dans l'application. Les utilisateurs peuvent vérifier la taille des paramètres du modèle, l'espace disque et s'il prend en charge des fonctions visuelles telles que la compréhension des images, puis sélectionner un modèle adapté à leur ordinateur à télécharger. Après avoir sélectionné le modèle, cliquez simplement sur l'option correspondante et l'application commencera automatiquement le téléchargement et affichera la progression du téléchargement.
Cet outil utilise principalement des modèles de quantification au format GGUF. GGUF est piloté par l'écosystème llama.cpp et est devenu l'un des formats de fichiers modèles les plus utilisés pour exécuter localement de grands modèles de langage open source. La technologie de quantification peut réduire l'espace de stockage et la mémoire d'exécution requis par le modèle en réduisant la précision numérique des paramètres du modèle, donnant ainsi aux modèles qui nécessitent à l'origine des configurations matérielles plus élevées la possibilité de s'exécuter sur des ordinateurs personnels ordinaires. Cependant, la quantification entraîne généralement également un certain degré de perte de précision, et l'impact spécifique dépend du modèle, de la méthode de quantification et du scénario d'utilisation.
En termes de gestion des modèles, Llama pour Windows répertoriera les modèles qui ont été téléchargés sur l'ordinateur. Les utilisateurs peuvent directement charger ou décharger les modèles et parler aux modèles via l'interface Web intégrée. L'application affiche également l'état d'exécution actuel du modèle, permettant aux utilisateurs de savoir si le modèle a été démarré sans avoir à vérifier manuellement le processus en arrière-plan.
Le moteur d'inférence sous-jacent peut également être géré automatiquement par l'application. Llama pour Windows utilise llama.cpp comme composant d'exécution principal. S'il existe déjà un service lama.cpp utilisable dans le système, l'application peut se connecter au service existant ; s'il n'est pas installé, il peut être installé via le programme d'installation officiel. L'ensemble du processus ne nécessite pas de droits d'administrateur et les utilisateurs n'ont pas besoin de compiler eux-mêmes le code source ni de configurer manuellement des paramètres de démarrage complexes.
Cette conception abaisse la barrière d'entrée pour l'IA locale, mais cela ne signifie pas que tous les modèles peuvent fonctionner correctement sur n'importe quel ordinateur. Les performances réelles du modèle dépendent toujours du processeur, de la mémoire, de la carte graphique, de la capacité de la mémoire vidéo et de la taille du modèle lui-même. Les modèles avec des tailles de paramètres plus petites sont généralement plus faciles à exécuter sur un ordinateur ordinaire, tandis que les modèles plus grands peuvent nécessiter beaucoup de mémoire ou même un poste de travail doté d'une carte graphique hautes performances pour obtenir de bons temps de réponse.
Llama pour Windows fournit également une interface de discussion similaire à un lanceur rapide au niveau du système. Les utilisateurs peuvent appuyer sur la touche de raccourci Alt+Espace dans d'autres applications pour afficher la fenêtre de discussion flottante et interagir directement avec le modèle actuellement chargé. La fenêtre adopte un design léger, et la conversation ne sera pas fermée immédiatement après avoir été masquée, et elle pourra continuer à être utilisée lorsqu'elle sera rappelée. Cela signifie que les utilisateurs n’ont pas besoin de passer à plusieurs reprises à des applications d’IA autonomes lorsqu’ils rédigent des documents, naviguent sur le Web ou écrivent du code.
En plus de la fonction de chat destinée aux utilisateurs ordinaires, le logiciel prend également en compte les besoins des développeurs. L'application peut démarrer un serveur local basé sur llama.cpp sur la machine locale et fournir des services de modèle via une API compatible avec l'interface OpenAI. L'adresse du service par défaut est
http://localhost:9931. Les développeurs peuvent demander à leurs scripts, applications ou agents IA d'appeler des modèles locaux sans avoir à envoyer toutes les requêtes aux services cloud distants.
Étant donné que l'interface est compatible avec l'API OpenAI, certains outils développés à l'origine pour l'interface OpenAI peuvent avoir la possibilité d'accéder à des modèles exécutés localement en ajustant simplement l'adresse du service et les configurations associées. Toutefois, la compatibilité des interfaces ne signifie pas que toutes les fonctions sont totalement cohérentes. Sa possibilité d'utilisation dépend toujours des capacités API requises par le client et de la prise en charge par le modèle chargé des fonctions correspondantes.
Cela fait également de Llama pour Windows non seulement un outil de chat local, mais également une plate-forme d'exécution d'IA sur des ordinateurs personnels. Le même fichier de modèle peut être partagé par plusieurs applications et les développeurs n'ont pas besoin de télécharger un modèle distinct pour chaque programme, réduisant ainsi l'occupation répétée de l'espace disque. Cette architecture présente une certaine valeur pratique pour les utilisateurs qui souhaitent créer localement des assistants de programmation, des outils d'analyse de documents ou d'autres applications d'IA.
En termes de confidentialité, le principal avantage de l'exécution de modèles localement est que le processus d'inférence ne doit pas nécessairement s'appuyer sur des services d'IA distants. Selon la description du projet, les mots d'invite saisis par l'utilisateur et l'inférence de modèle sont effectués de manière native, et l'application ne collecte pas de télémétrie, n'analyse pas les événements et ne génère pas d'identifiants d'installation spécialisés. Toutefois, les utilisateurs doivent toujours se connecter à Internet pour télécharger les fichiers de modèles et obtenir les mises à jour logicielles. La description du projet mentionne également que ces demandes de mise en réseau porteront une identification standard d'agent utilisateur contenant des informations telles que la version du logiciel, la version de Windows et l'architecture du processeur. Par conséquent, ce qu'on appelle l'opération locale ne signifie pas que l'ensemble du processus d'installation et de maintenance ne nécessite aucun réseau, mais cela signifie que l'inférence de modèle et le traitement de texte rapide peuvent rester localement.
La compatibilité matérielle est également au centre de cette application. Llama pour Windows prend en charge les plates-formes x64 et ARM64 de Windows 11 et fournit une prise en charge native des appareils Windows sur Arm. Ceci est particulièrement important pour les ordinateurs portables Windows équipés de processeurs Arm, car certains outils d'IA locaux ont été principalement développés pour les ordinateurs x86 traditionnels dans le passé et peuvent devoir s'appuyer sur une simulation exécutée sur des appareils Arm, ou manquer de composants précompilés correspondants.
Le projet mentionne également la prise en charge de la plate-forme NVIDIA RTX Spark. La plate-forme est orientée vers les applications informatiques d'IA locales et peut fournir une autre option matérielle aux utilisateurs qui souhaitent exécuter des modèles plus grands dans un environnement de bureau. Cependant, le fait que les logiciels prennent en charge une certaine plate-forme ne signifie pas que tous les modèles peuvent atteindre des performances idéales. Les résultats d'exploitation spécifiques dépendent toujours de la taille du modèle, de la capacité de mémoire et de la configuration d'inférence.
Llama pour Windows peut être obtenu via le site officiel de Llama, ou vous pouvez télécharger le package d'installation correspondant à partir de la page de version GitHub du projet. Une fois installée, les utilisateurs peuvent ouvrir l'application, sélectionner un modèle, attendre la fin du téléchargement, puis commencer à l'utiliser via une fenêtre de discussion flottante ou une interface Web. Il convient de noter que l'application est actuellement pour Windows 11 et ne répertorie pas Windows 10 comme plate-forme prise en charge.
En général, Llama pour Windows ne réinvente pas la technologie d'exécution des grands modèles de langage locaux, mais intègre les étapes initialement dispersées dans les entrepôts de modèles, les moteurs d'inférence et les outils de ligne de commande dans une interface légère. Sa plus grande valeur réside dans l'abaissement du seuil d'utilisation tout en conservant les capacités d'évolutivité telles que les API locales et les flux de travail des développeurs.
À mesure que le modèle open source continue de se développer, l'exécution locale de l'IA se transforme progressivement d'un projet lancé qui nécessite une certaine expérience technique à un scénario d'application que les utilisateurs d'ordinateurs ordinaires peuvent essayer. La capacité de Llama pour Windows de devenir un outil grand public dépend de sa stabilité, de la gamme de modèles pris en charge et de son expérience d'exécution réelle, mais cela facilite au moins la tâche des utilisateurs de Windows : ils peuvent commencer à explorer l'exécution de modèles d'IA sur leurs propres ordinateurs sans avoir à apprendre au préalable des opérations complexes en ligne de commande.
Adresse de téléchargement :
https://llama.app/download/windows
https://github.com/ggml-org/Llama-Windows
Commentaires