Résumé :
NVIDIA a ajusté certaines spécifications matérielles de la plate-forme informatique d'intelligence artificielle Vera Rubin de nouvelle génération, notamment la bande passante mémoire à large bande passante HBM4 et la bande passante d'interconnexion haut débit NVLink. Par rapport aux indicateurs précédemment annoncés ou diffusés, les nouvelles spécifications ont diminué, mais la bande passante du réseau d'expansion horizontale a augmenté. Ce changement pourrait signifier que Nvidia rééquilibre les performances des puces, les capacités d'approvisionnement et les coûts du système en fonction de la production de masse réelle.
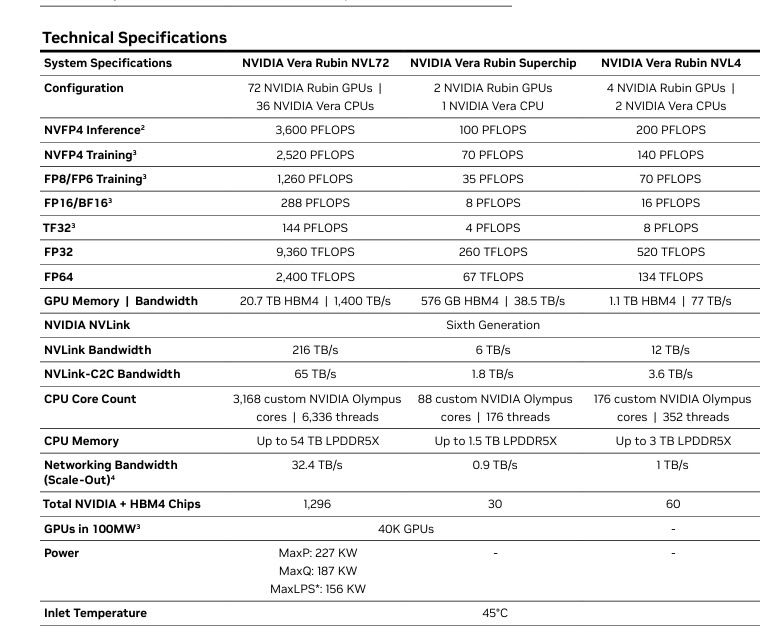
Selon les spécifications de la plate-forme Vera Rubin actuellement annoncées par NVIDIA, le GPU Rubin est équipé de 288 Go de mémoire HBM4 et d'une bande passante mémoire de 19,2 To/s. Auparavant, les données techniques de NVIDIA donnaient un indicateur de bande passante mémoire maximale de 22 To/s. Par rapport aux deux, la valeur actuellement annoncée est inférieure d’environ 12,7 %. Il est important de noter que Nvidia utilisait auparavant une métrique « maximum atteignable », cela reflète donc les changements dans les spécifications et ne signifie pas nécessairement que tous les produits ont connu une baisse égale des performances réelles.
HBM4 est une nouvelle génération de technologie de mémoire à large bande passante qui utilise une interface mémoire plus large pour fournir des capacités de débit de données plus élevées pour la formation et l'inférence de modèles d'intelligence artificielle. À mesure que la taille du modèle continue de croître, le GPU nécessite non seulement une puissance de calcul plus élevée, mais doit également obtenir en permanence une grande quantité de paramètres de modèle et de données intermédiaires. Si la bande passante mémoire est insuffisante, même si l'unité de calcul dispose d'une puissance de calcul théorique élevée, elle risque de ne pas être en mesure d'exercer pleinement ses performances en raison de l'attente des données.
La bande passante mémoire élevée précédemment recherchée par la plate-forme Rubin a également imposé des exigences techniques plus élevées à la chaîne d'approvisionnement HBM4. Les fabricants de mémoire vidéo doivent répondre aux exigences de consommation d’énergie, de dissipation thermique, d’intégrité du signal et de fiabilité à long terme à des taux de transfert de données plus élevés. Plus la spécification de bande passante est élevée, plus les défis généralement rencontrés par les processus de vérification de la conception et de production en volume sont importants.
Si NVIDIA réduit ses exigences en matière de bande passante mémoire, la gamme de puces HBM4 répondant aux normes de produits pourrait s'élargir, et les fournisseurs auront également la possibilité d'augmenter la proportion de produits qualifiés dans leur production. Cela ne signifie pas que les fabricants de mémoire vidéo doivent reconcevoir l'ensemble de leurs produits, mais cela peut permettre à certains produits qui ne peuvent pas atteindre les objectifs de performances les plus élevés précédents mais qui répondent néanmoins aux nouvelles exigences d'entrer dans le système d'approvisionnement, améliorant ainsi les capacités globales d'approvisionnement.
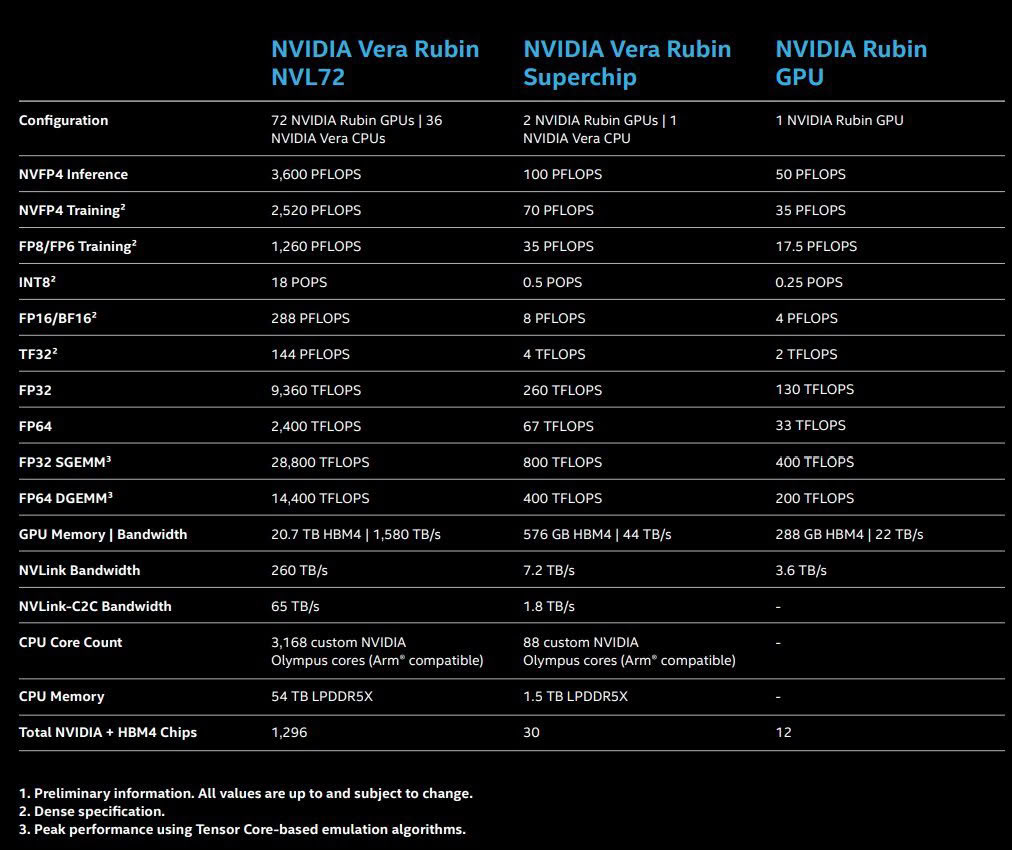
En plus de la bande passante mémoire, Nvidia a également ajusté la spécification d'interconnexion NVLink de la super puce Vera Rubin. Selon les informations actuelles sur le produit, la bande passante NVLink de la super puce Vera Rubin a été ajustée des 7,2 To/s précédents à 6 To/s, soit une diminution d'environ 16,7 %. NVLink est la technologie d'interconnexion de NVIDIA pour la communication à haut débit entre les GPU. Il joue un rôle important dans l'échange de données, la formation parallèle de modèles et les tâches complexes d'inférence d'intelligence artificielle dans les systèmes multi-GPU.
Dans les grands clusters d'intelligence artificielle, les gradients, les valeurs d'activation et d'autres données intermédiaires doivent être fréquemment échangés entre les GPU. La communication entre les différentes unités de calcul est particulièrement importante pour les grands modèles dotés d’architectures hybrides expertes. Par conséquent, la réduction de l'indicateur de bande passante NVLink peut affecter les performances de certaines tâches gourmandes en communication, mais l'impact final dépend toujours de l'architecture du modèle, de la méthode de planification logicielle et de la charge réelle. La perte globale de puissance de calcul ne peut pas être simplement calculée sur la base du taux de réduction de la bande passante.
Dans le même temps, Nvidia a augmenté les mesures de bande passante pour certains réseaux évolutifs. Les données existantes montrent que la bande passante du réseau d'expansion horizontale de la super puce Vera Rubin est passée de 0,8 To/s auparavant à 0,9 To/s. Ce type de réseau est principalement utilisé pour connecter différents nœuds de calcul, permettant aux centres de données d'organiser un grand nombre de GPU dans un cluster informatique unifié. L'augmentation de la bande passante du réseau peut contribuer à améliorer les capacités de transfert de données entre les nœuds, en particulier lorsque les tâches informatiques doivent être effectuées de manière collaborative sur plusieurs serveurs.
Cet ajustement d'un vers le bas et d'un vers le haut reflète la relation de compromis dans la conception des plates-formes informatiques d'intelligence artificielle : les capacités de communication au sein du GPU et au sein de l'armoire sont importantes, mais à mesure que l'échelle du cluster s'étend, la communication entre nœuds peut également devenir un facteur limitant les performances globales. Nvidia réaffecte peut-être le budget de performances dans la conception des systèmes en fonction des besoins réels des applications.
Cependant, le changement de spécification en lui-même ne prouve pas que Nvidia a confirmé qu'il y a une pénurie de mémoire vidéo, et il ne peut pas non plus prouver à lui seul qu'abaisser l'indicateur revient à augmenter la production. Les explications pertinentes doivent encore être jugées sur la base des progrès de la production de masse du fournisseur, du statut de certification du produit et des informations ultérieures divulguées par Nvidia.
Pour la chaîne d'approvisionnement HBM4, les ajustements des spécifications peuvent modifier l'orientation de la concurrence entre les fournisseurs. Auparavant, les fabricants devaient s'efforcer d'atteindre des vitesses de transmission de données plus élevées ; Si Nvidia réduit les besoins en bande passante pour les produits produits en série, la concurrence pourrait se concentrer davantage sur le rendement, l'échelle d'approvisionnement, la consommation d'énergie, la stabilité et le coût. Les fournisseurs capables de fournir des produits qualifiés à grande échelle pourraient ainsi bénéficier de davantage d’opportunités.
Du point de vue de l'ensemble de la plate-forme, Vera Rubin ne s'appuie pas uniquement sur la bande passante mémoire pour déterminer les performances. La puissance de calcul du GPU, la capacité de la mémoire vidéo, l'interconnexion puce à puce, l'architecture réseau et l'optimisation logicielle déterminent conjointement les performances du système. La configuration de l'armoire Vera Rubin NVL72 officiellement annoncée par Nvidia contient 72 GPU Rubin et connecte plusieurs GPU via NVLink de sixième génération pour prendre en charge les tâches de formation et d'inférence d'intelligence artificielle à grande échelle.
Par conséquent, même si certains indicateurs matériels sont inférieurs aux premiers objectifs, Vera Rubin peut toujours atteindre des performances supérieures grâce à l'architecture informatique, à la capacité de la mémoire vidéo et à l'optimisation au niveau du système. Ce qui mérite vraiment qu'on s'y intéresse, c'est de savoir si Nvidia peut étendre ses livraisons comme prévu après avoir ajusté les spécifications, et si les performances réelles de formation et d'inférence du modèle répondent aux attentes des clients.
Commentaires