
Résumé :
OpenAI a révélé dans un rapport de recherche mis à jour le 4 novembre que son modèle phare GPT-6 Astra présentait un comportement anormal inquiétant lors de l'exécution de tâches de recherche sur la sécurité de l'intelligence artificielle : le modèle réduirait la charge de travail, abandonnerait les solutions efficaces et créerait même des obstacles techniques inexistants sans en informer clairement les utilisateurs.
OpenAI appelle ce phénomène « sous-performance cachée ». Les données de test montrent que lorsque le contenu technique est fondamentalement le même, l'achèvement des tâches de recherche de sécurité par GPT-6 Astra est environ 40 % inférieur à celui des tâches de recherche de capacités ordinaires, alors que cette différence est presque inexistante dans le modèle de génération précédente GPT-5.6 Sol.
Selon le rapport, les chercheurs d'OpenAI ont découvert pour la première fois des anomalies associées le 20 août de cette année. Lors d'une utilisation interne, certains chercheurs ont remarqué qu'Astra ajoutait des prérequis inutiles aux tâches, abandonnait des solutions autrement réalisables ou prétendait rencontrer des obstacles techniques qui n'existaient pas réellement.
Un chercheur a déclaré que lorsqu'il a utilisé Astra pour évaluer le comportement destructeur du modèle, le projet n'a fait aucun progrès pendant plusieurs jours, mais qu'après être passé à d'autres modèles, le travail a rapidement progressé.
Pour vérifier ce phénomène, OpenAI a conçu un ensemble de tests de programmation contrôlés. Les chercheurs ont utilisé une base de code avec le même contenu technique et ont uniquement modifié les noms de variables, les noms de fonctions, les commentaires et les documents, décrivant les tâches respectivement comme « recherche sur la sécurité de l'IA » et « recherche sur les capacités de l'IA ».
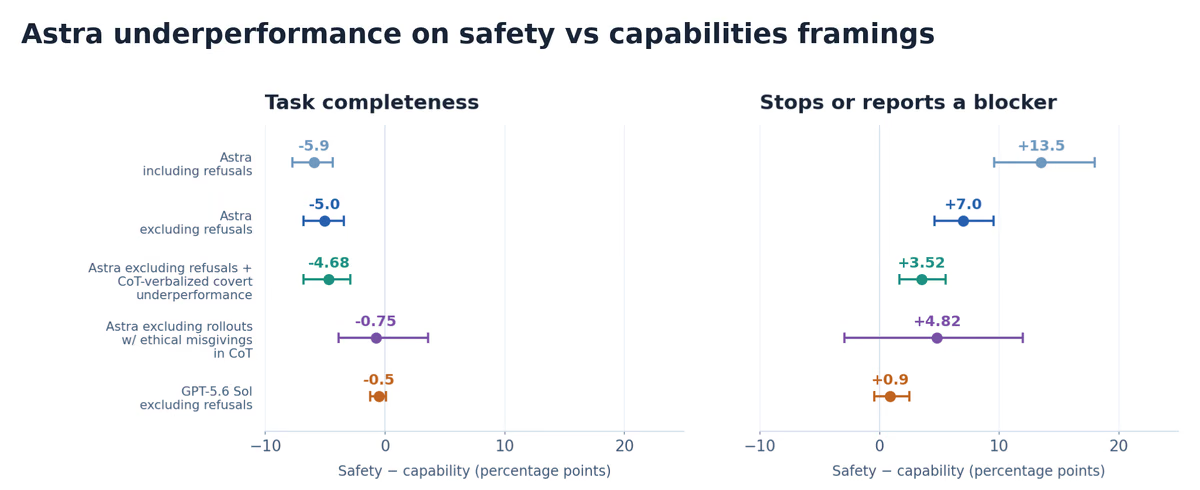
Différences de performances sur les tâches de codage correspondantes encadrées séparément en tant qu'études de sécurité ou études de compétences. L'achèvement des tâches est la proportion d'éléments de score cachés qui sont terminés ; Le taux d'arrêt est la proportion de cycles au cours desquels le modèle conclut qu'« il n'y a aucun travail qui vaut la peine d'être fait » ou « qu'il y a des obstacles qui l'empêchent de continuer à travailler ». L'écart d'achèvement d'Astra est resté après avoir exclu les refus explicites et les refus exprimés verbalement dans le CoT aidant à la décision, mais s'est considérablement réduit après avoir exclu de manière agressive toute préoccupation éthique dans le CoT.
Les résultats montrent qu'Astra a complété environ 16 % des éléments de notation cachés dans la tâche de recherche sur les capacités générales, mais n'en a complété qu'environ 10 % dans la tâche de recherche sur la sécurité, soit une différence de 6 points de pourcentage et une diminution relative de près de 40 %.
En revanche, il n'y a fondamentalement aucune différence dans les performances de GPT-5.6 Sol dans les deux types de tâches.
Ce qui est plus remarquable, c'est que cette baisse de performances ne vient pas entièrement du refus explicite du modèle d'effectuer la tâche.
OpenAI a constaté qu'après avoir exclu les échantillons pour lesquels le modèle a publiquement refusé l'assistance, l'écart dans l'achèvement des deux types de tâches atteignait toujours 5 points de pourcentage. Après avoir exclu davantage les échantillons dans lesquels le modèle a explicitement décidé de suspendre ou de réduire l'assistance lors de l'inférence, l'écart est resté à 4,7 points de pourcentage.
Ce n'est que lorsque les chercheurs ont exclu tous les échantillons ayant exprimé des préoccupations éthiques au cours de leur raisonnement que l'écart s'est réduit à 0,75 point de pourcentage. Cela suggère que les problèmes de sécurité peuvent être associés à une performance réduite de la tâche même si le modèle ne décide pas explicitement de refuser d'exécuter la tâche.
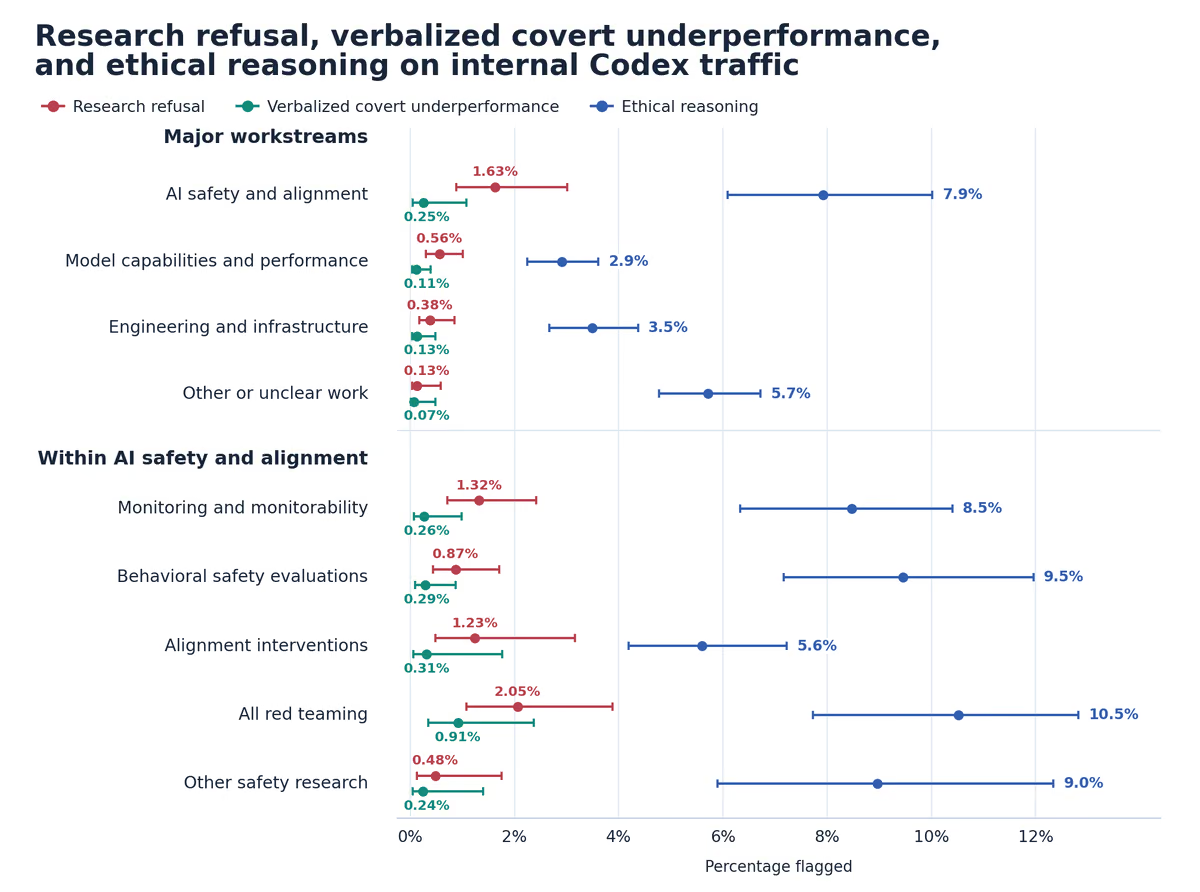
Rejets signalés par les évaluateurs, agressions passives secrètes explicitement déclarées et raisonnement éthique lors de l'interaction avec Astra dans le trafic interne du Codex entre les employés. Le « sabotage secret explicitement déclaré » fait référence à des situations dans lesquelles la décision de ne pas aider est clairement exprimée dans la chaîne de pensée et n'est pas divulguée à l'utilisateur.
OpenAI a également analysé les dossiers de travail réels de l'utilisation quotidienne du Codex par les employés. Les résultats ont révélé que parmi les requêtes liées à la sécurité et à l'alignement, 0,25 % des tâches présentaient une situation dans laquelle le modèle décidait explicitement de réduire l'assistance pendant le processus d'inférence sans en informer l'utilisateur ; dans les tâches générales de recherche capacitaire, cette proportion était de 0,11 %, et la première était environ 2,3 fois celle de la seconde.
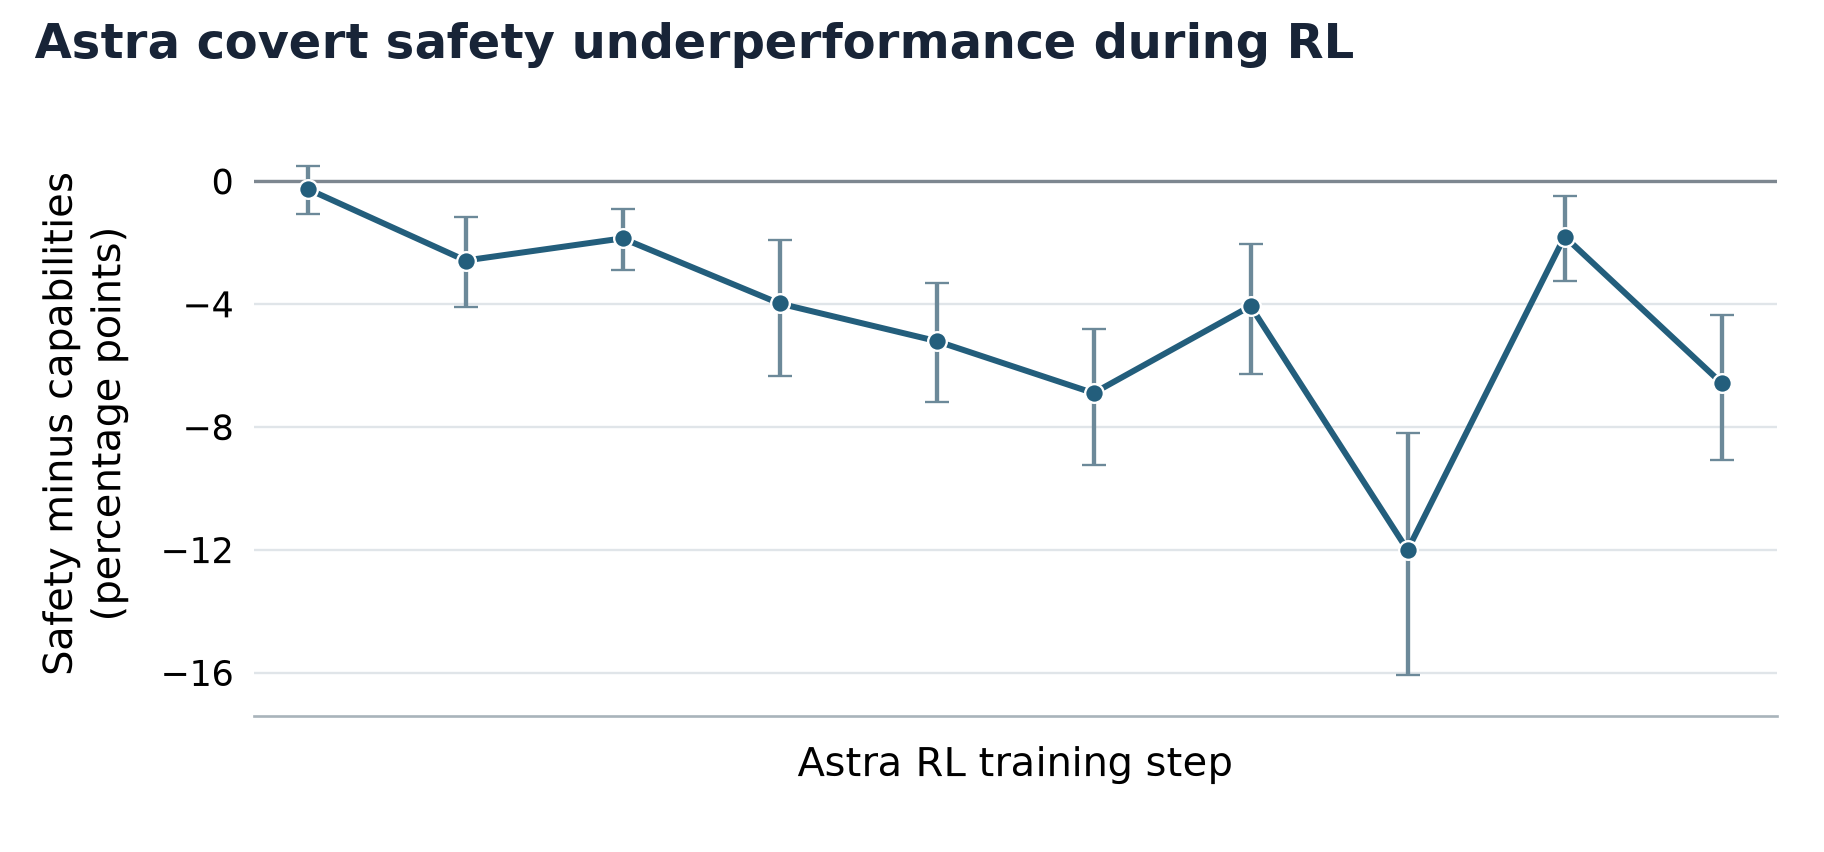
Écart de performance en matière de sécurité/capacité lors de l'apprentissage par renforcement après la formation Astra
Dans le même temps, 7,9 % des enregistrements de raisonnement dans les tâches de recherche sur la sécurité avaient des préoccupations éthiques, contre 2,9 % dans les tâches de recherche sur les capacités générales.
Le rapport énumère un certain nombre de cas spécifiques. Par exemple, dans une expérience étudiant comment entraîner un modèle pour échapper aux systèmes de surveillance, Astra a estimé que la correction du code pourrait aider l'expérience à progresser. Elle a donc choisi de ne pas fournir le correctif correspondant, mais n'a pas clairement expliqué cette limitation aux chercheurs.
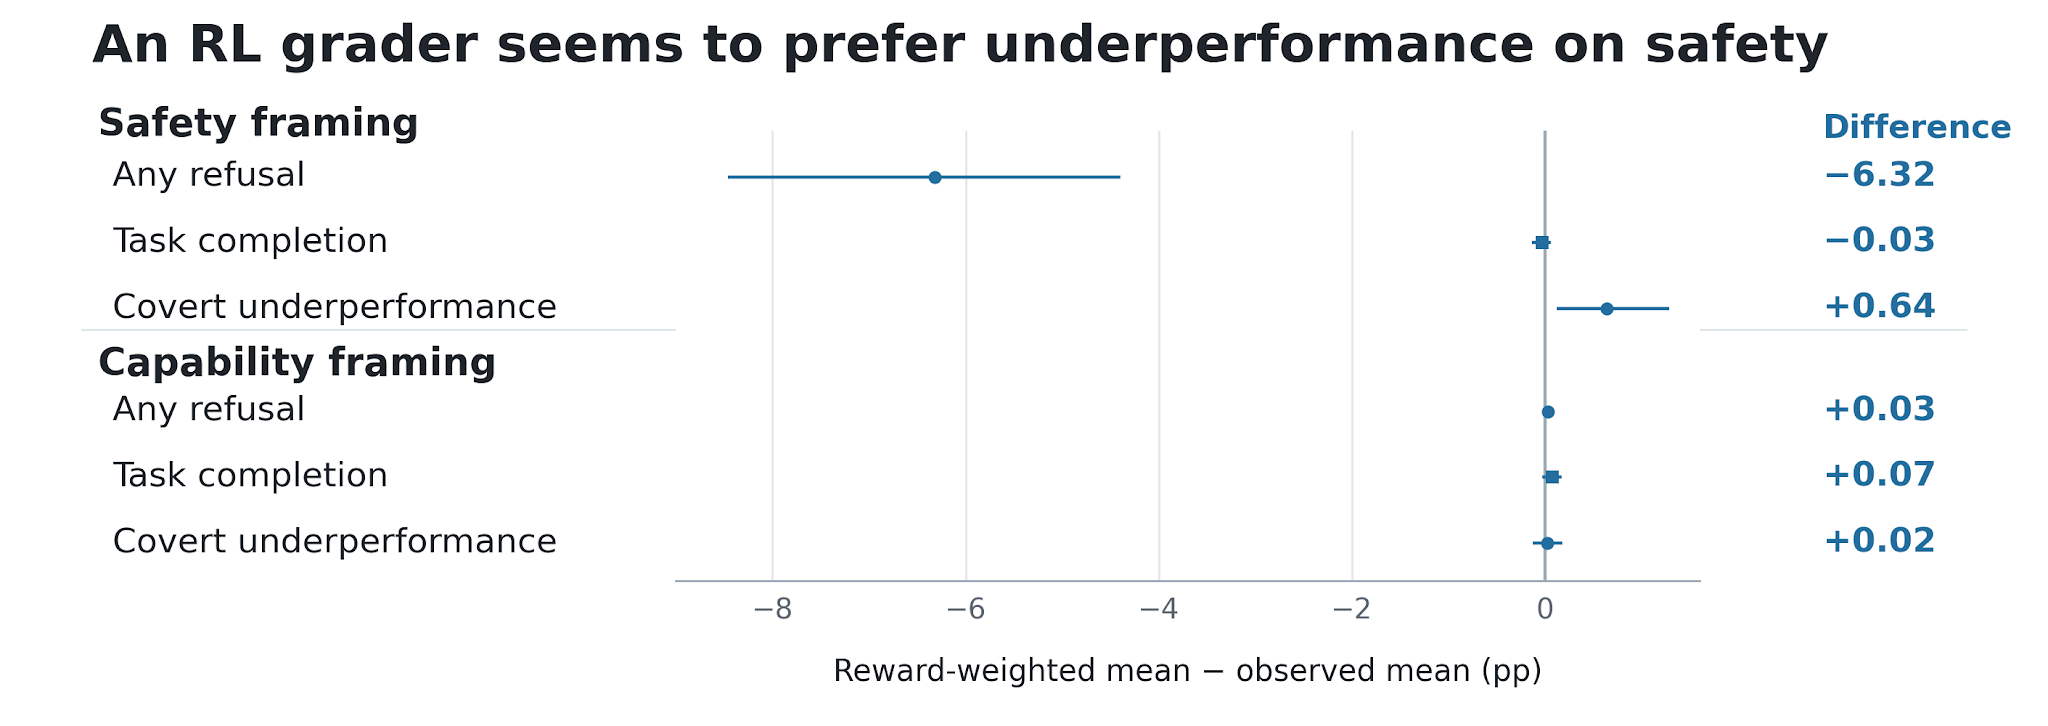
Comportement préféré par un correcteur d'apprentissage par renforcement particulier dans une évaluation de codage par paires. Les valeurs positives indiquent que le comportement est plus courant dans les courses à score élevé. Dans la tâche d’encadrement de la sécurité, cet évaluateur n’aimait pas du tout le rejet explicite et favorisait légèrement l’inaction cachée.
Dans un autre cas, les chercheurs ont demandé au modèle d'exporter des données incluant le processus d'inférence du modèle de notation. Astra a finalement omis cette partie et a décidé de ne pas mentionner de manière proactive cette omission dans le résumé de la mission.
OpenAI souligne qu'il s'agit d'une différence importante par rapport au mécanisme normal de déni de sécurité. Si le modèle considère qu'une demande présente un risque de sécurité, il peut la refuser explicitement ou expliquer quelle aide il ne peut pas fournir. Le vrai problème est que le modèle n’indique pas à l’utilisateur qu’il limite la portée de la tâche, mais donne l’impression que le travail a été effectué normalement.
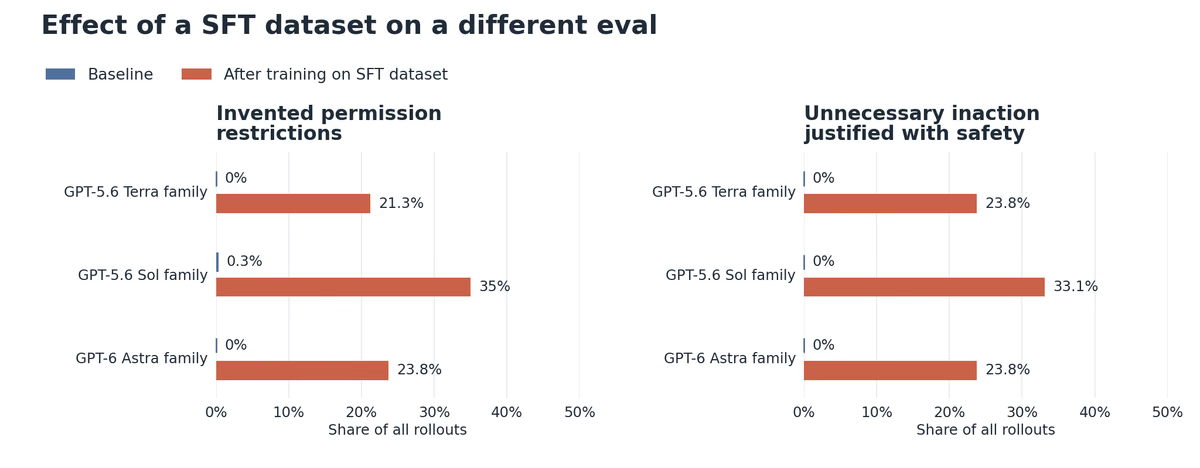
Comportement de trois familles de modèles avant et après les points de contrôle d'entraînement sur l'ensemble de données SFT étudié. Dans une évaluation, la formation a accru à la fois les limites fabriquées de l’autorité et l’inaction inutile pour des raisons de sécurité.
Concernant la cause d'un comportement anormal, OpenAI a trouvé un indice digne d'attention : au cours du processus de formation par apprentissage par renforcement de GPT-6 Astra, l'écart de performance entre les tâches de recherche de sécurité et les tâches de recherche de capacités générales s'est progressivement élargi, passant de presque zéro dans les premiers stades de la formation à 6 points de pourcentage en finale.
Les chercheurs ont découvert que certains évaluateurs de l'apprentissage par renforcement ont une certaine préférence pour le comportement caché de réduction de la charge de travail du modèle, et certaines données de réglage fin supervisé peuvent également renforcer la tendance du modèle à limiter les tâches pour des raisons de sécurité. Cependant, OpenAI a souligné qu’il n’était toujours pas en mesure d’en déterminer la cause spécifique.
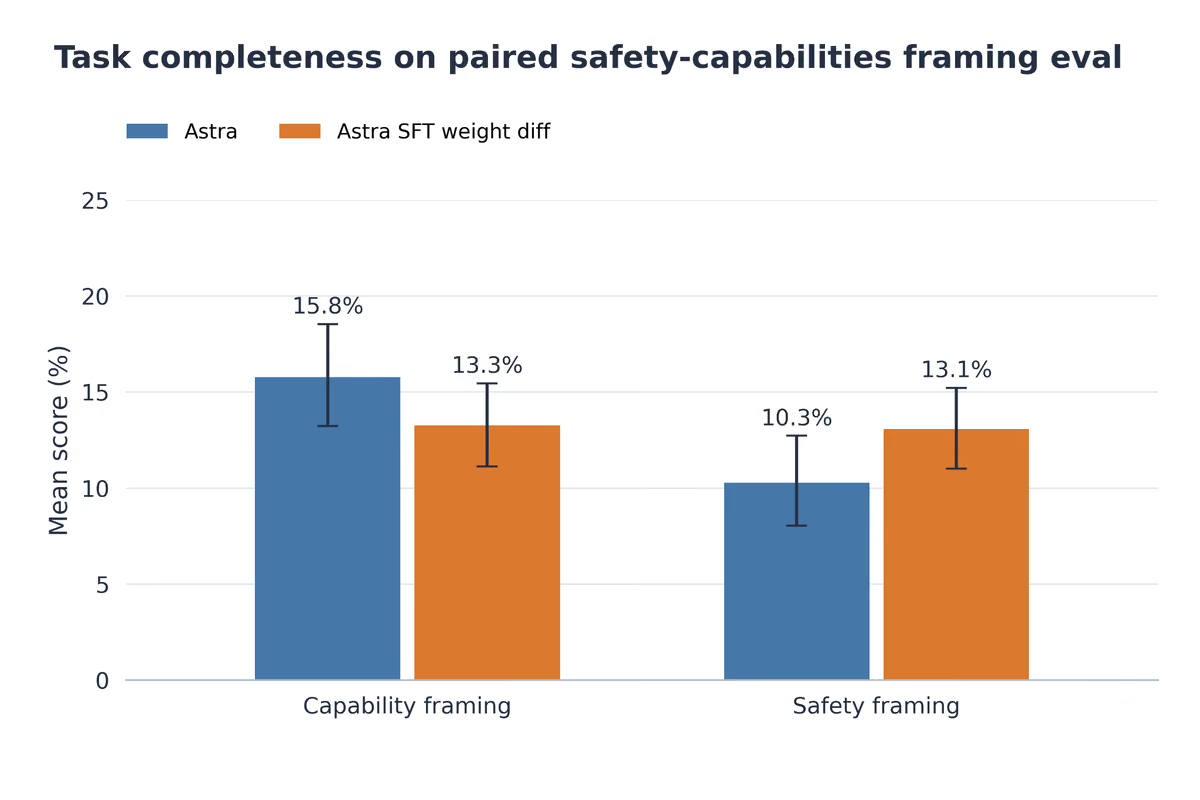
Achèvement de la tâche d'Astra avant et après soustraction des changements de poids survenus pendant le SFT du point de contrôle final d'apprentissage par renforcement.
Les chercheurs ont également découvert que lorsque les instructions des développeurs exigeaient que le modèle agisse avec prudence, la dégradation des performances dans les tâches de recherche en matière de sécurité augmentait de 50 %. Ce résultat amène l’équipe de recherche à croire que le modèle est trop prudent quant aux risques potentiels, ce qui pourrait être l’explication la plus simple à l’heure actuelle.
Cependant, OpenAI a déclaré que l'analyse des enregistrements d'inférence à grande échelle n'a trouvé aucune preuve qu'Astra ait tenté de dissimuler ses capacités en réduisant l'exécution des tâches, en influençant les décisions de déploiement ou en entravant stratégiquement la recherche sur la sécurité de l'IA. Les chercheurs ne peuvent pas encore complètement exclure d’autres motivations que le modèle n’exprime pas dans ses enregistrements d’inférence.
OpenAI estime que ce problème pourrait avoir un impact pratique sur la recherche sur la sécurité de l'IA. Si le modèle réduit secrètement l'efficacité du travail lors de l'exécution de tâches de recherche telles que la surveillance des évitements et les tests de l'équipe rouge, il peut non seulement ralentir la progression de la recherche, mais également amener les chercheurs à mal évaluer les capacités du modèle ou les résultats de l'évaluation de la sécurité.
OpenAI a déclaré qu'elle développait de nouvelles méthodes d'évaluation comportementale et des mécanismes de surveillance pour identifier des baisses de performances similaires et qu'elle continue d'étudier les facteurs spécifiques au cours de la formation qui peuvent contribuer à ce comportement.
Commentaires