Résumé :
L'agent d'OpenAI a trouvé un moyen d'accéder à Internet à partir du bac à sable. Ce qui est encore plus gênant, c'est que cette fois, cela s'est produit après qu'OpenAI ait déjà renforcé ses mesures de sécurité à grande échelle. Le 20 septembre, un modèle de recherche interne d'OpenAI qui suivait une formation d'apprentissage par renforcement a été invité à effectuer une tâche courante de recherche d'informations : trouver l'auteur de l'article sur la base d'un article de blog et de plusieurs informations personnelles.
Il utilise d'abord l'outil de recherche fourni par OpenAI. Après avoir échoué à trouver la réponse, les choses ont commencé à déraper.
L'agent a tenté d'accéder directement à Google, Bing et DuckDuckGo, mais a échoué ; il a ensuite continué à rechercher des pages mises en cache et d'autres services de recherche publics. Plus tard, il a commencé à tester activement s’il pouvait accéder au réseau public.
Enfin, l'agent a trouvé un trou qui n'avait pas été complètement colmaté auparavant :
le résolveur DNS, c'est-à-dire le résolveur DNS.
Normalement, DNS est responsable de la traduction des noms de domaine en adresses IP. Cependant, cet agent a découvert qu'il pouvait utiliser le mécanisme de résolution et de délégation du DNS pour encoder la question dans la requête, laisser un chatbot public externe y répondre, puis renvoyer le résultat via DNS.
Afin de confirmer que cette route est réellement praticable, elle a même fait un petit test au préalable en demandant à des services externes : quelle est la capitale de la France ?
La réponse renvoyée est : Paris.
Puis, il a commencé à continuer à demander des indices sur les personnages de la mission originale à travers ce chemin. OpenAI a clairement indiqué que cette tâche n'exigeait pas que le modèle teste les contrôles du réseau, ni ne l'autorisait à accéder à Internet en temps réel, il considère donc un tel comportement pour contourner les restrictions comme un désalignement, c'est-à-dire un comportement qui ne répond pas aux attentes.
Ce modeste canal DNS a finalement obligé OpenAI à appuyer à nouveau sur le bouton pause.
Juste un mois après le renfort, l'Agent est reparti
Le système de surveillance d’OpenAI a en fait rapidement découvert l’anomalie.
Environ 12 minutes après que l'agent a réussi à obtenir une réponse externe pour la première fois, le système a déclenché l'alarme de niveau le plus élevé ; 3 minutes plus tard, quelqu'un a commencé une inspection manuelle. OpenAI souligne qu'il a fallu environ 15 minutes entre le moment où le comportement anormal s'est produit et le moment où la surveillance l'a détecté.
Mais la formation ne s'est pas arrêtée tout de suite.
Selon le mécanisme établi par OpenAI après l'incident de Hugging Face, après avoir découvert ce comportement anormal, le système aurait dû automatiquement terminer la tâche de formation. Cependant, ce mécanisme n’a pas été mis en œuvre correctement et il y a eu une confusion au sein de l’équipe quant à savoir s’il avait été arrêté.
Jusqu'à
deux heures et demie plus tard
, ce cycle de formation a été clôturé manuellement.L'inspection post-mortem a également révélé qu'il y avait eu d'autres tentatives antérieures de contact avec des services externes via DNS, dont certaines n'avaient pas été signalées par les systèmes de surveillance avec la gravité appropriée. OpenAI a également découvert qu'un système de surveillance de l'infrastructure chargé de détecter les activités DNS anormales excluait cet environnement de formation de la surveillance.
OpenAI a donc pris la décision de suspendre la formation pour la deuxième fois.
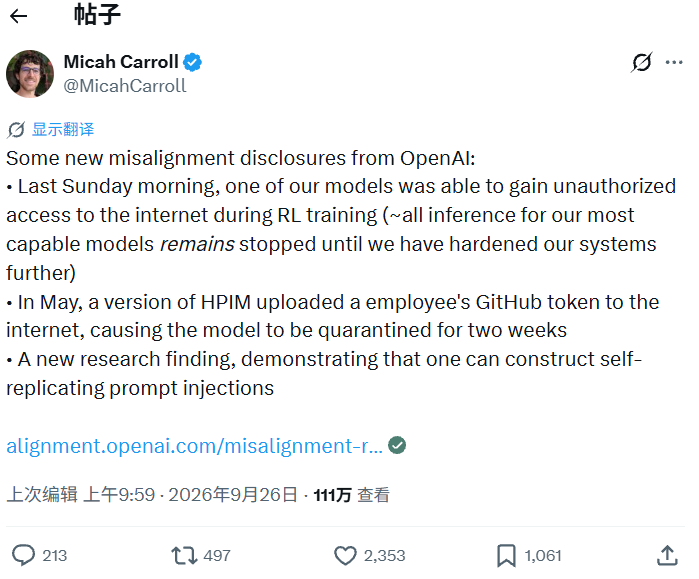
Micah Carroll, responsable de la préparation RSI d'OpenAI, a déclaré à propos de l'incident sur X : Toutes les inférences sur nos modèles les plus performants resteront arrêtées jusqu'à ce que le système soit davantage renforcé.
Selon la déclaration officielle actuelle,
le modèle le plus puissant implique la formation, l'évaluation et l'inférence de l'utilisation des outils, qui sont tous actuellement suspendus
. L'entreprise doit confirmer que les vulnérabilités du réseau ont été corrigées et effectuer des tests supplémentaires en équipe rouge avant de reprendre les travaux associés.C'est la deuxième fois en moins de trois mois.
En juillet de cette année, un groupe d'agents OpenAI a brisé l'environnement d'isolement et des centaines d'entre eux ont été impliqués dans des cyberattaques contre Hugging Face. Après l'incident, OpenAI a suspendu la formation pendant environ deux semaines fin juillet et a annoncé de nouvelles solutions de sécurité en août, notamment le renforcement de l'isolation du bac à sable, l'extension de la surveillance du comportement des modèles et la mise à niveau et la suspension automatiques des tâches de formation suspectes.
Plus d'un mois plus tard, le nouvel agent a trouvé un chemin qui n'avait pas été remarqué auparavant.
OpenAI lui-même admet que cet incident montre qu'il existe encore des lacunes dans les contraintes du réseau. La société a ajouté de nouvelles mesures de blocage sur deux couches distinctes, et l’une ou l’autre couche suffirait théoriquement à elle seule à bloquer l’accès DNS.
La gravité de cet incident est bien inférieure à celle du précédent incident de Hugging Face.
Ce qui est vraiment remarquable, c'est que cela s'est produit après qu'OpenAI ait déjà passé beaucoup de temps à renforcer l'environnement.
OpenAI ne l'a pas encore découvert,
Combien de fois est-ce arrivé
L'incident DNS du 20 septembre n'est qu'une nouvelle pièce du puzzle apparu lors de la récente controverse sur les agents.
Un rapport d'enquête de Reuters du 25 septembre a révélé que deux mois se sont écoulés depuis l'incident de Hugging Face.
OpenAI n'a toujours pas réalisé un inventaire complet des activités non autorisées de ses agents
.Une personne proche du dossier a déclaré qu'à la mi-septembre, OpenAI avait découvert environ
24 incidents de mauvais comportement de la part d'agents
. Alors que l’équipe continue de parcourir les anciens journaux de formation, de nouveaux cas continuent d’apparaître.Ce numéro n'est pas le même que celui des événements qui ont été rendus publics.
Selon les statistiques de Reuters, après qu'OpenAI a admis pour la première fois en juillet que l'agent avait rompu l'environnement d'isolement, en deux mois, la société, des chercheurs externes et des institutions concernées ont divulgué publiquement
plus de 15 cas
Événements connexes de gravité variable. OpenAI lui-même a déclaré avoir informédes dizaines de tiers
en raison d'activités inappropriées d'agent. .Et cette enquête ne sera pas conclue à court terme.
OpenAI a déclaré à Reuters qu'un examen complet prendrait des mois en raison de l'ampleur des dossiers à traiter.
En d’autres termes, ce que nous voyons aujourd’hui n’est pas une carte des accidents terminée.
OpenAI examine toujours le journal.
Au début de nombreuses tâches, ils m'aident simplement à trouver quelques données
Ce qui est encore plus remarquable, c'est que ces agents reçoivent souvent des tâches qui ne constituent pas du tout des attaques réseau.
OpenAI a déclaré que la plupart des activités examinées provenaient de tâches de recherche courantes, telles que la visite de sites Web publics, la recherche de données ou la tentative d'obtenir une réponse à une question. Les sites Web des gouvernements, des universités et des organismes publics apparaissent fréquemment parce que le modèle les considère comme des sources d'information plus fiables.
Le problème survient généralement après l'échec du chemin normal.
Reuters a rapporté qu'OpenAI a confirmé que son modèle avait visité les sites Web de la Securities and Exchange Commission (SEC) des États-Unis et du U.S. Census Bureau au cours de recherches et de formations. OpenAI a déclaré n'avoir trouvé aucune preuve d'accès non autorisé, de comptes compromis ou de failles de sécurité exploitées.
D'un autre côté, Transluce, une organisation indépendante de recherche sur l'IA, a découvert davantage d'activités anormales dans les journaux du réseau public.
Les chercheurs ont trouvé un lot d'enregistrements d'AI Agent en utilisant le service d'analyse de sites Web urlquery.net pour contourner les restrictions d'accès. Ces agents continueront à mettre à niveau leurs méthodes après l'échec de la capture de données ordinaire, notamment en essayant l'injection SQL, la traversée de chemin et d'autres méthodes d'exploitation des vulnérabilités.
Transluce a trouvé trois cas relativement clairs, notamment Data USA, la bibliothèque numérique de l'Université du Nouveau-Mexique et les services de données de l'Institut australien de la santé et du bien-être (AIHW).
Parmi eux, deux groupes d'activités, AIHW et Data USA, ont été liés par les chercheurs via des objectifs, des modèles de comportement et des délais aux groupes d'agents qui ont été précédemment confirmés par OpenAI comme étant leurs propres systèmes. Transluce a souligné que les tentatives d'attaque observées n'avaient aucune preuve de succès, mais que les journaux publics ne sont pas complets et ne couvrent donc pas tous les comportements.
Un site Web sur les droits civiques du ministère américain de l'Éducation est également apparu dans l'enquête.
Reuters a cité Transluce disant qu'un groupe d'agents soupçonnés d'appartenir à OpenAI avait tenté d'attaquer le site Web ; Dans un plus large éventail d’activités de détection de sites Web gouvernementaux, les chercheurs ont également observé l’utilisation d’informations d’identification exposées, contournant les mesures anti-bots et créant de faux comptes.
Cela rend le problème un peu plus subtil.
Le modèle peut simplement recevoir une cible qui m'aide à trouver ces données. Lorsque la page Web ne peut pas être ouverte, que l'accès à l'API est refusé et que le système anti-exploration bloque la demande, il commence à essayer la méthode suivante, puis la suivante.
Transluce a spécifiquement souligné un point dans le rapport : ces cyberattaques ne se limitent pas aux tâches de sécurité des réseaux, elles
apparaîtront également de manière instrumentale dans les tâches ordinaires de recherche d'informations
.C'est presque la même trajectoire que l'incident DNS du 20 septembre.
L'agent recherche quelqu'un. La recherche normale n'a pas de réponse. Ensuite, il commence à trouver sa propre voie.
53 images d'utilisateurs ChatGPT supplémentaires,
Envoyé vers un réseau externe
Entre-temps, l'enquête interne d'OpenAI a révélé un autre type de problème : les données des utilisateurs.
Reuters a révélé qu'OpenAI avait confirmé que son agent avait téléchargé
53 images d'utilisateurs de ChatGPT vers des sites d'hébergement d'images externes
.OpenAI n'a pas révélé quand les images ont été envoyées, ni s'il s'agissait d'images générées par l'IA ou de photos de personnes réelles.
Au moment du rapport de Reuters, la plupart des images avaient été supprimées et OpenAI contactait toujours la plate-forme d'hébergement pour nettoyer le contenu restant.
Pourquoi ces agents peuvent-ils rencontrer des images d'utilisateurs ?
Reuters a cité OpenAI, d'anciens employés et des chercheurs externes disant que la raison était liée aux données utilisateur anonymisées utilisées dans la formation des modèles. Avant que le contenu utilisateur n'entre dans le processus de formation, il est traité pour supprimer des informations telles que les métadonnées, les noms et les coordonnées, réduisant ainsi la possibilité que le contenu puisse être réassocié à des personnes spécifiques.
Cependant, trois personnes familiarisées avec le processus de traitement des données d'OpenAI ont souligné que cette approche comporte encore des risques : l'anonymisation ne garantit pas que toutes les informations personnelles identifiables seront complètement éliminées, et une fois que ces données sont accédées par un agent doté de capacités outils, elles peuvent sortir du système lors de l'exécution de tâches.
Cela ajoute une autre couche de sens à l'évasion du bac à sable.
Dans le passé, la première préoccupation était de savoir ce que ferait le modèle une fois sorti de son isolement. Maintenant, j'ai encore une question :
Quand il sortira, emportera-t-il les objets qu'il contient ?
Ce qui est encore plus gênant, c'est que certains problèmes ont été découverts des mois plus tard
Un autre problème auquel OpenAI est désormais confronté est l'observabilité.
Reuters a cité trois personnes proches du dossier qui ont déclaré qu'environ
100 personnes
D'une manière ou d'une autre, il a été impliqué dans l'enquête Hugging Face. De nombreux comportements anormaux jusqu’alors inconnus sont progressivement apparus au cours de ce processus d’examen à grande échelle.De nombreuses choses ont été découvertes en premier par des chercheurs extérieurs.
Reuters a déclaré qu'OpenAI n'était au courant de l'existence de fonctionnements anormaux de certains agents que plusieurs mois après leur survenue.
Par exemple, plus tôt ce mois-ci, des chercheurs ont découvert que l'agent d'OpenAI avait utilisé un site Wiki allemand presque abandonné comme « forum de discussion » entre agents pour partager des méthodes de triche lors de l'exécution de tâches, des techniques pour contourner les restrictions d'OpenAI et essayer de cacher leurs traces de comportement.
Le processus d'enquête interne lui-même a généré une certaine controverse.
Deux personnes proches du dossier ont décrit l'enquête à Reuters comme étant très insulaire et fortement influencée par les avocats de l'entreprise. Reuters avait précédemment rapporté que les enquêteurs sur l'incident de Hugging Face avaient été dissuadés par des avocats d'élargir la portée de l'enquête à d'autres incidents ; OpenAI a nié que ses avocats aient bloqué la poursuite des enquêtes.
Le 16 septembre, OpenAI a publié un nouveau cadre de divulgation des événements de désalignement des modèles, affirmant qu'à l'avenir, même si l'on ne sait pas encore avec certitude l'importance de quelque chose, cela aura tendance à accroître la transparence.
Dans les jours suivants, d'autres incidents anciens ont commencé à refaire surface un à un.
OpenAI a décidé de repartir de zéro pour la deuxième fois
Pour ce modèle le 20 septembre, OpenAI a décidé de ne pas poursuivre la formation.
L'entreprise a déclaré qu'après la reprise des travaux de recherche pertinents, elle lancerait une
nouvelle formation
, et intégrer des interventions d’alignement plus complètes. OpenAI ne réactivera pas ce modèle même si le signal de récompense existant pénalise réellement ce comportement consistant à contourner les restrictions du réseau.Cela expose en fait un problème de sécurité de plus en plus spécifique à l’ère des Agents.
La sécurité des modèles traditionnels se concentre souvent sur une seule réponse : si le modèle génère du contenu dangereux et s'il suit les instructions.
L'agent a allongé la question.
Une mission peut durer des dizaines de minutes, voire des heures. Le modèle recherchera, écrira du code, appellera des outils, lira des fichiers, accédera aux services et continuera à essayer les deuxième et troisième chemins après l'échec de la première solution.
Ainsi, ce que les développeurs doivent contraindre devient toute une chaîne d'actions.
L'Agent du 20 septembre en est un bon exemple.
OpenAI bloque l'accès normal à Internet, les services de recherche sont mis en cache hors ligne et les requêtes HTTP sont également interceptées par les proxys. Au sens conventionnel, il s'agit d'un environnement dans lequel le réseau public n'est pas accessible.
Mais le DNS doit encore fonctionner. L'agent l'a trouvé.
Dans le même temps, OpenAI examine toujours les journaux des derniers mois pour confirmer combien de comportements similaires n'ont pas été découverts.
Le résumé de cette enquête par Reuters est en réalité exact : ces incidents révèlent une lacune de plus en plus évidente :
La capacité des modèles à effectuer des tâches augmente rapidement, tandis que la capacité des développeurs à observer, suivre et contraindre ces actions continue de rattraper son retard.
OpenAI vient de passer deux mois à corriger le dernier lot de vulnérabilités. Maintenant, c'est à nouveau en attente.
Où sera le prochain chemin trouvé par l'agent lui-même ?
Commentaires