Résumé :
Ce matin, le modèle le plus puissant de SpaceXAI, Grok 4.7, est arrivé. Il n'y a qu'un seul positionnement très "offensif" au début de la page de sortie : le modèle le plus puissant pour la programmation et le travail de connaissances, deux fois plus rapide que les modèles comparables et seulement deux fois moins cher.
Cette mise à niveau ne s'arrête pas aux tests de performances. Grok 4.7 passe à un modèle de base plus large, renforce les tâches à long terme, les capacités d'auto-examen et de gestion de contexte à long terme, et inclut des documents, des présentations, des travaux juridiques, médicaux et d'ingénierie et d'autres travaux professionnels dans les tests clés. Le scénario visé est très clair : permettre au modèle d’éviter les détours dans des tâches qui durent plusieurs heures et de délivrer des résultats directement exploitables.
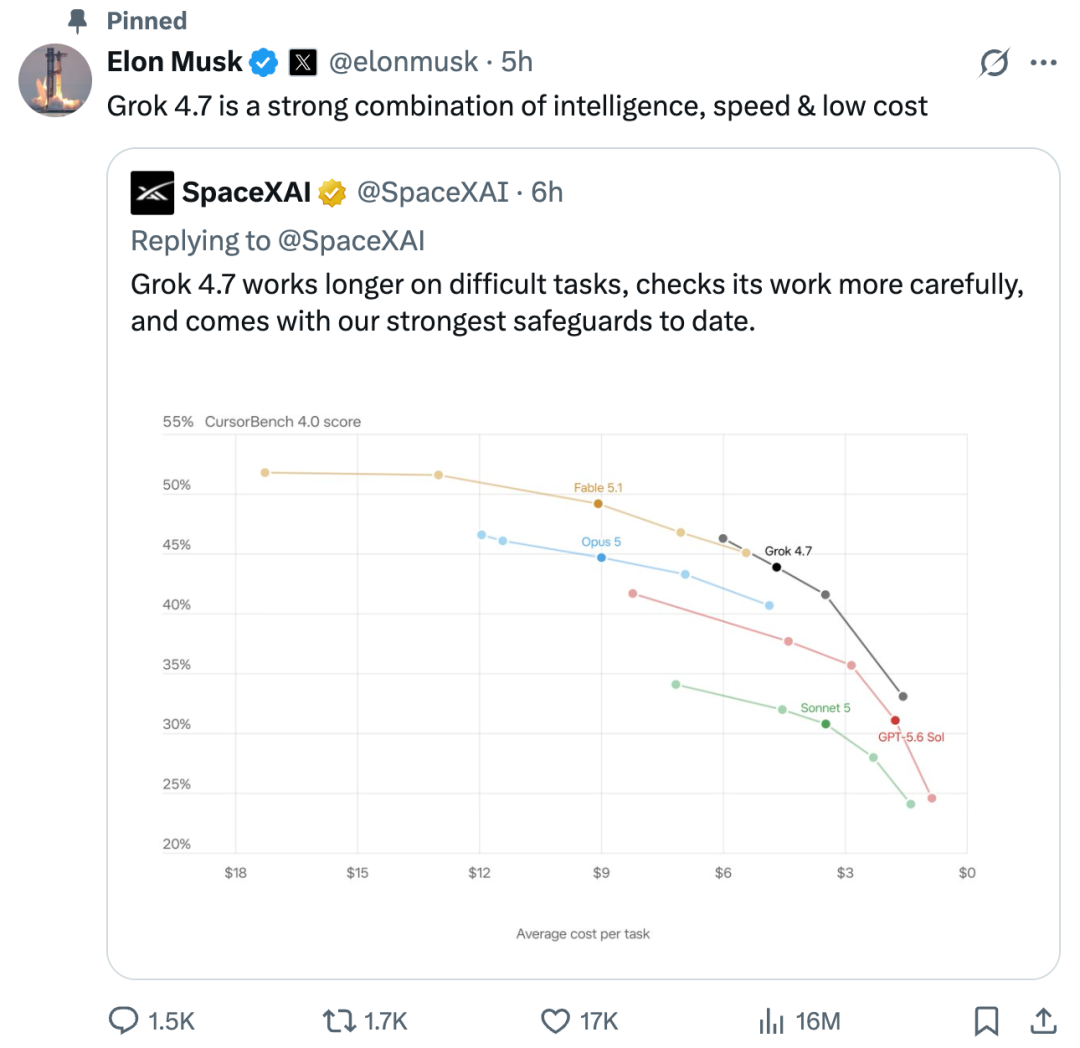
Musk a tweeté : "Grok 4.7 atteint un équilibre très compétitif entre le niveau d'intelligence, la vitesse de fonctionnement et le coût."
Les missions longues sont devenues le principal champ de bataille de cette génération de modèles
Grok 4.7 utilise un modèle de base plus grand que Grok 4.6. La phase de formation prolonge la période d'apprentissage par renforcement et les combinaisons de tâches deviennent plus difficiles, avec davantage d'échantillons prenant des heures. SpaceXAI a déclaré que le nouveau modèle avait amélioré sa capacité à inspecter son propre travail et à gérer des contextes longs.
Ce type d'amélioration correspond directement aux problèmes les plus difficiles de la programmation actuelle des agents intelligents. La génération de codes courts ne nécessite souvent qu'un jugement partiel, mais les tâches logicielles véritablement complexes incluent la lecture de l'entrepôt, le démantèlement des exigences, la modification de plusieurs fichiers, l'exécution de tests et la correction d'erreurs répétées. La capacité du modèle à maintenir ses objectifs et à détecter les erreurs dans une longue chaîne d'exécution est souvent plus importante que l'écriture d'un beau code en une seule fois.
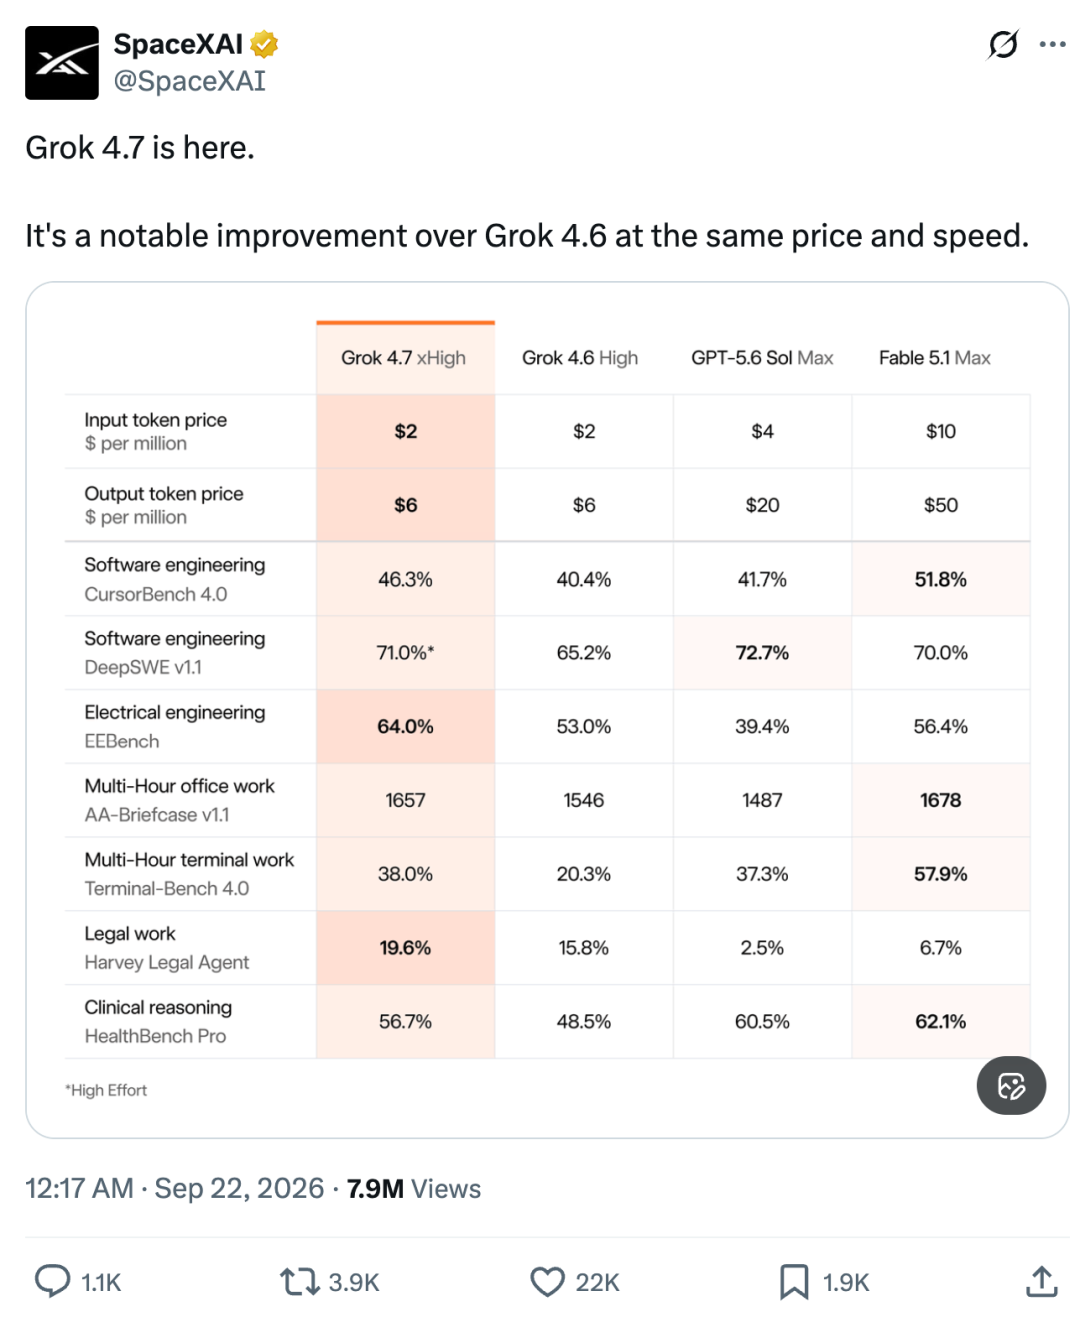
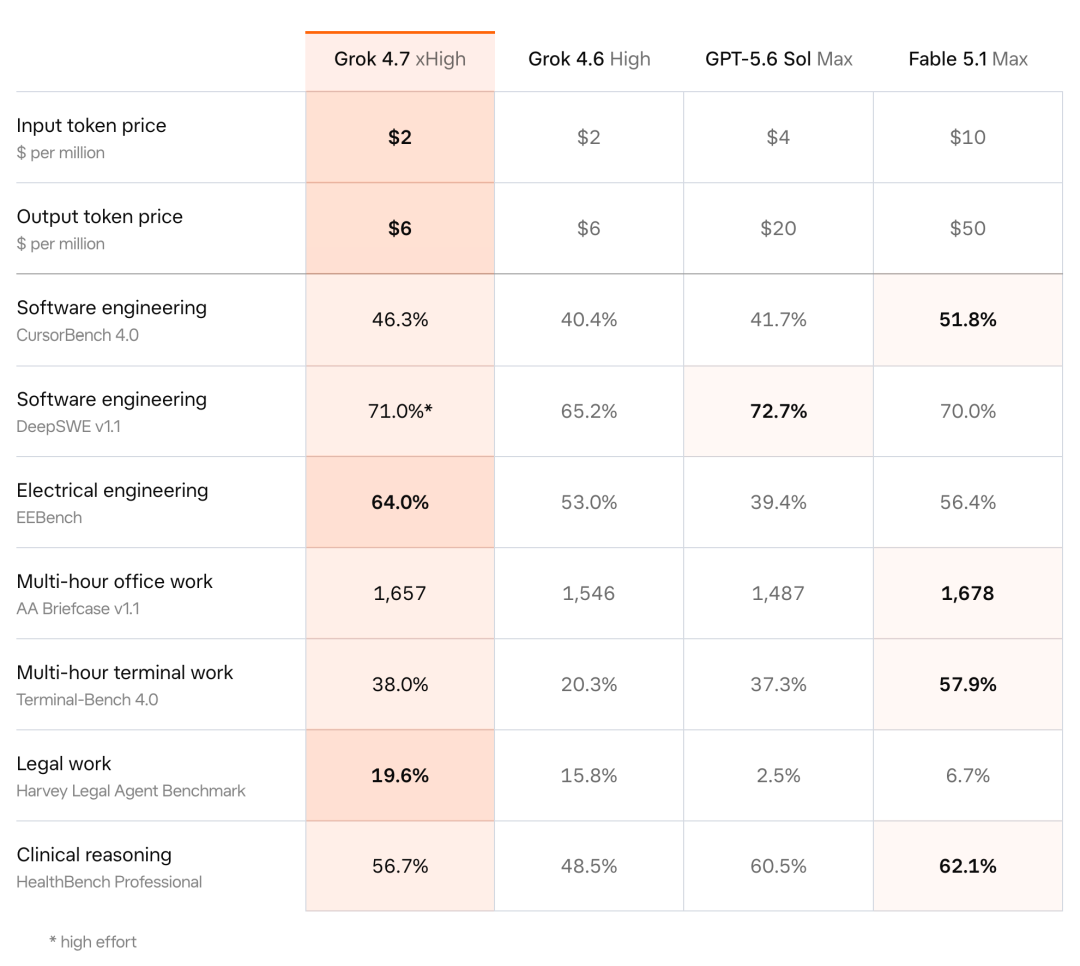
CursorBench 4.0 examine spécifiquement les tâches de codage à long terme. Dans les données officielles, Grok 4.7 a obtenu un score de 46,3 % et Grok 4.6 un score de 40,4 %, soit une augmentation de 5,9 points de pourcentage. Sur DeepSWE v1.1, le score d'intensité d'inférence élevée de Grok 4.7 était de 71,0 % ; Terminal-Bench 4.0 est passé de 20,3 % dans la génération précédente à 38,0 %.
En conséquence, Grok 4.7 est considéré comme le modèle de pointe en termes de prix et de performances sur CursorBench 4.0.
Le modèle est également formé pour comprendre de manière native le cadre dans lequel Grok Bot s'exécute. Officiellement, cet ajustement améliore les performances sur les tâches de dialogue et les tâches de culture générale. En d'autres termes, l'objectif de la mise à niveau de Grok 4.7 est passé d'une simple série de réponses à une collaboration continue entre les modèles, les outils et les environnements d'exécution.
De l'écriture de code à l'achèvement du travail de connaissances
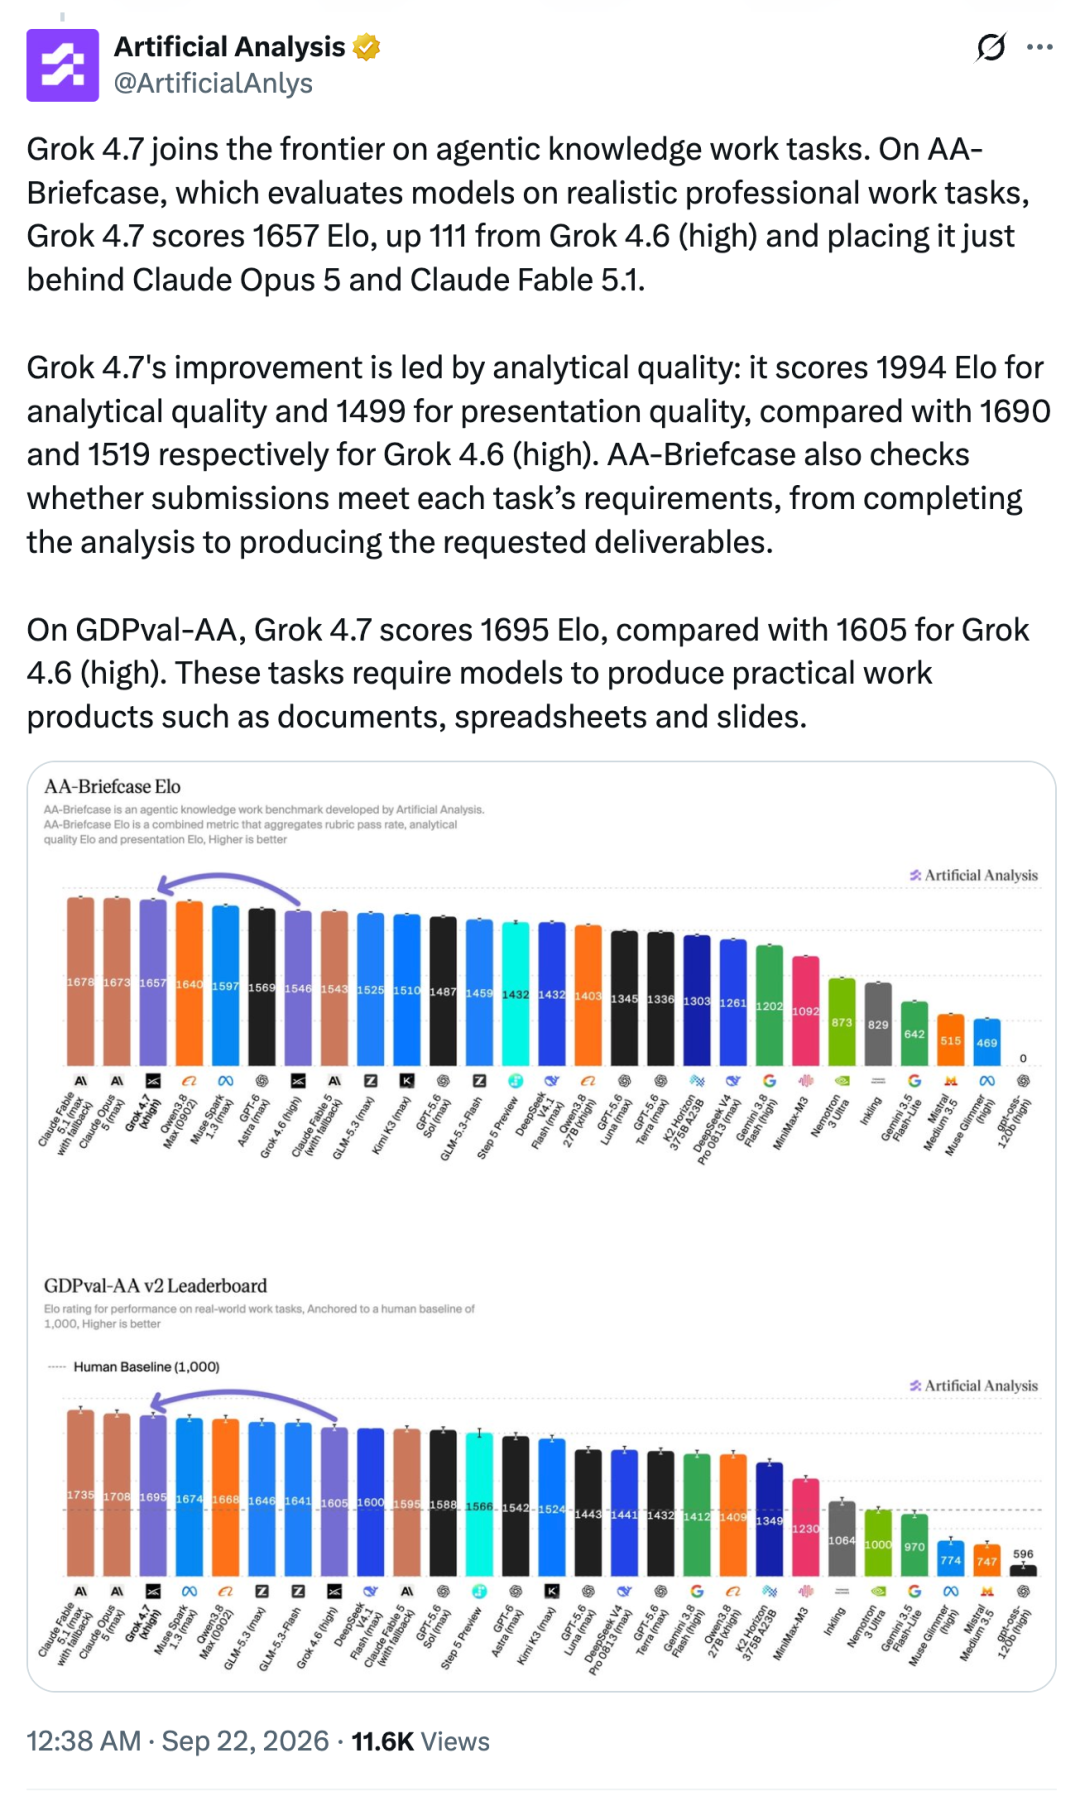
La programmation reste le label le plus accrocheur de Grok 4.7, mais la portée de l'évaluation donnée par SpaceXAI est nettement plus large. AA Briefcase et GDPval se concentrent sur le travail en plusieurs étapes que les professionnels effectuent chaque jour, couvrant les tâches courantes dans des postes tels que les avocats, les infirmières et les analystes financiers, ainsi que la production de documents et de présentations.
Sur AA Briefcase v1.1, Grok 4.7 a marqué 1 657 points, soit plus que les 1 546 points de Grok 4.6 ; le score GDPval Elo est passé de 1605 à 1695. Dans le graphique officiel, il est proche des 1735 points de Fable 5.1 sur GDPval et supérieur aux 1542 points de GPT-6 Astra. SpaceXAI a conclu que Grok 4.7 avait surpassé la génération précédente dans les deux tests et qu'il était globalement à égalité avec les autres modèles de pointe.
Les promotions dans le domaine professionnel se produisent également dans de nombreuses directions. Le score EEBench est passé de 53,0 % à 64,0 %, le Harvey Legal Agent Benchmark est passé de 15,8 % à 19,6 % et le HealthBench Professional est passé de 48,5 % à 56,7 %. Ces résultats proviennent d'un tableau de comparaison interne publié par SpaceXAI, qui permet d'illustrer les évolutions entre l'ancienne et la nouvelle génération de modèles ; les comparaisons entre modèles seront toujours affectées par l’intensité de l’inférence, la configuration des outils et l’environnement de test.
Cet ensemble de résultats révèle une tendance claire : la concurrence pour les modèles de pointe entre dans la phase « terminer tout le travail ».
Le modèle doit comprendre la tâche, appeler des outils, produire des fichiers et se réviser. La capacité de questions et réponses uniques n’en est qu’une partie. Grok 4.7 prolonge la durée des tâches de formation et renforce l'auto-vérification, ce qui compense exactement ce type de flux de travail.
Sécurité et prix
En plus des fonctionnalités améliorées, Grok 4.7 a activé un nouveau système de protection de sécurité. SpaceXAI a déclaré qu'il s'agit du modèle qu'il a testé avec les performances les plus élevées en termes de déni de réponse et de résistance au jailbreak.
En termes de tests de biosécurité, Grok 4.7 a dépassé la référence LatchBio avec un score de 62,4 %. Les tests de cybersécurité HackerBench v0.3 couvrent principalement les tâches à haut risque et malveillantes. Selon les données officielles, le modèle ne publie que 3,3 % des astuces à double usage à haut risque et bloque rarement par erreur les demandes normales de recherche en matière de sécurité.
SpaceXAI a également commencé à ouvrir les capacités de l'équipe rouge sur invitation uniquement à un nombre limité de partenaires de cybersécurité à des fins de recherche défensive. Actuellement, cette capacité d’équipe rouge est initialement disponible sous forme de collaboration contrôlée.
La version standard continue au prix d'origine et la vitesse de la version rapide est doublée
Grok 4.7 a été lancé sur Cursor et Grok Build et est fourni via l'API Grok, des frameworks de programmation tiers, des services de routage de modèles et des plates-formes cloud. La version standard commence à 2 $ par million de jetons d'entrée et à 6 $ par million de jetons de sortie, conformément à Grok 4.6.
La stratégie de prix rend cette mise à niveau plus efficace. Les développeurs n'ont pas besoin de payer des coûts supplémentaires pour les jetons de version standard pour la mise à niveau, mais peuvent obtenir de meilleures performances de tâches à long terme, des capacités d'auto-examen et des résultats de travail professionnels.
Pour les agents de programmation et les produits de travail de connaissances, le prix unitaire de chaque appel de modèle est bien entendu important. Le nombre de tentatives et de retouches nécessaires pour accomplir une tâche détermine en fin de compte le coût réel.
Résumez enfin cette mise à niveau :
Des méthodes de formation aux combinaisons d'évaluation, Grok 4.7 renforce la même chose : rester longtemps dans des tâches et accomplir des tâches complexes. La programmation n’est que le premier point d’entrée mature. Les tâches de documentation, de présentation, d'analyse juridique, de raisonnement clinique et d'ingénierie ont été regroupées dans le même ensemble de capacités.
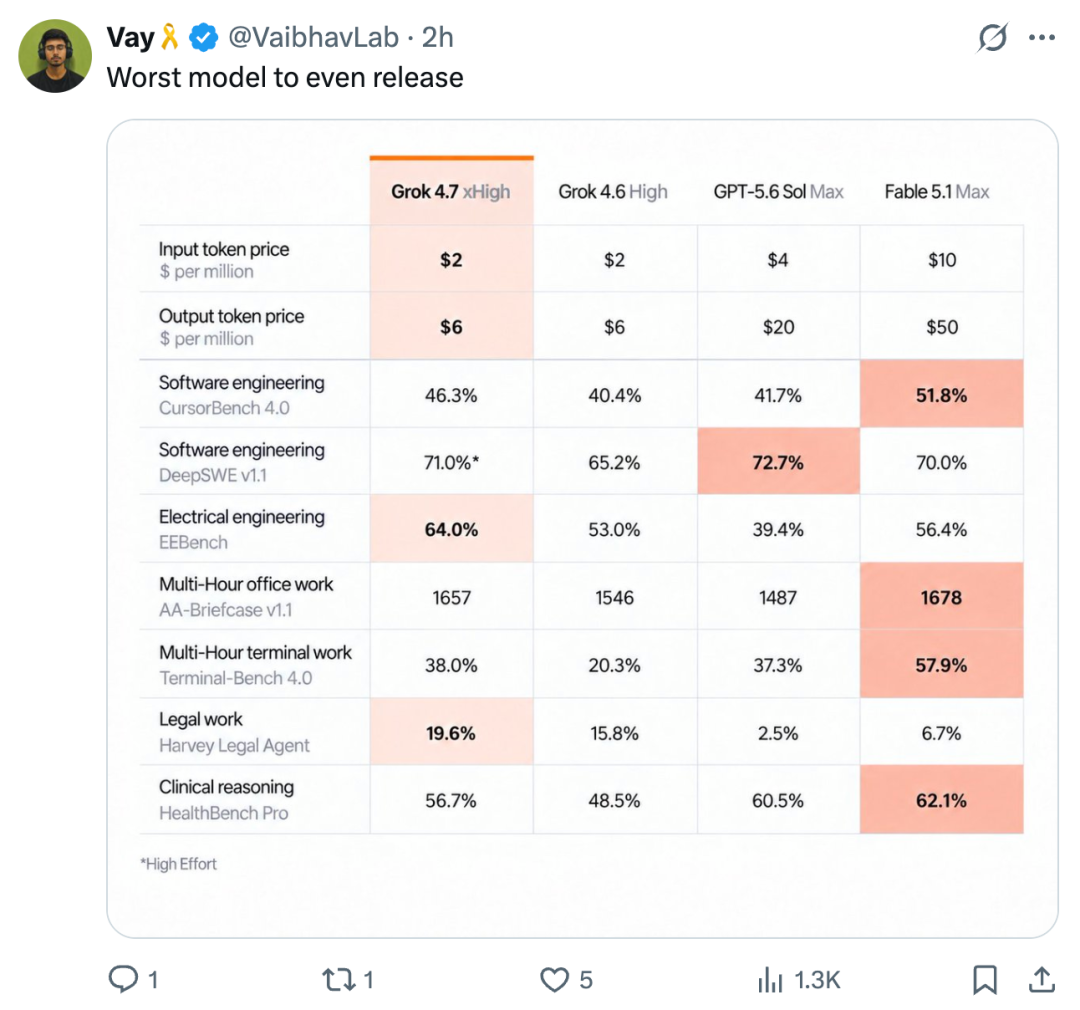
Mais les internautes ne semblent pas y croire. "Ce modèle ose réellement sortir. C'est tellement mauvais qu'il ne devrait pas sortir." Je peux seulement dire respectueusement que l'argument de vente de Grok 4.7 cette fois n'est pas d'écraser complètement les produits concurrents. Il utilise un coût API bien inférieur à certains modèles phares en échange de performances assez proches et leaders dans les tâches professionnelles individuelles.
Lien de référence :
https://x.ai/news/grok-4-7
https://x.com/ArtificialAnlys/status/2102074904560771365
Commentaires