
Résumé :
Un épisode dramatique s'est récemment produit dans le cercle de l'IA : un tweet d'annonce officielle de DeepSeek, avant que tout le monde ait eu le temps d'étudier attentivement les détails techniques, est d'abord sorti du cercle à cause du texte de couverture.
Certains internautes ont découvert que la couverture de l'article public « DeepSeek Open Source Inference Framework : Towards a Truly Inclusive Future » tapait par erreur « Putt & Whitney » comme « HP », ce qui tombait en collision avec la célèbre marque d'ordinateurs Hewlett-Packard (HP).
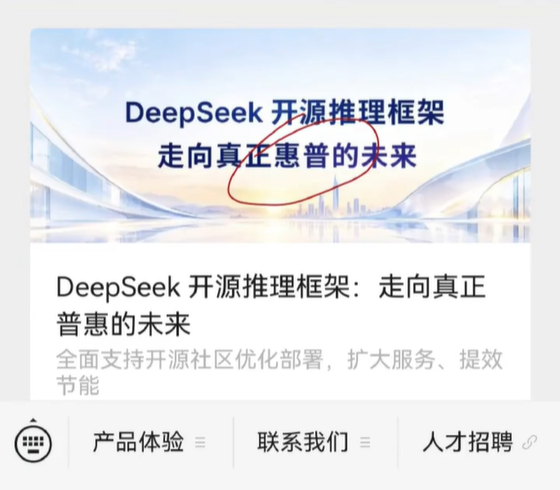
De nombreux internautes ont plaisanté en disant que DeepSeek envoyait involontairement une vague d'annonces de trafic à HP gratuitement ; certains ont également plaisanté en disant que les dirigeants de HP saisiraient l'occasion pour venir discuter de coopération.
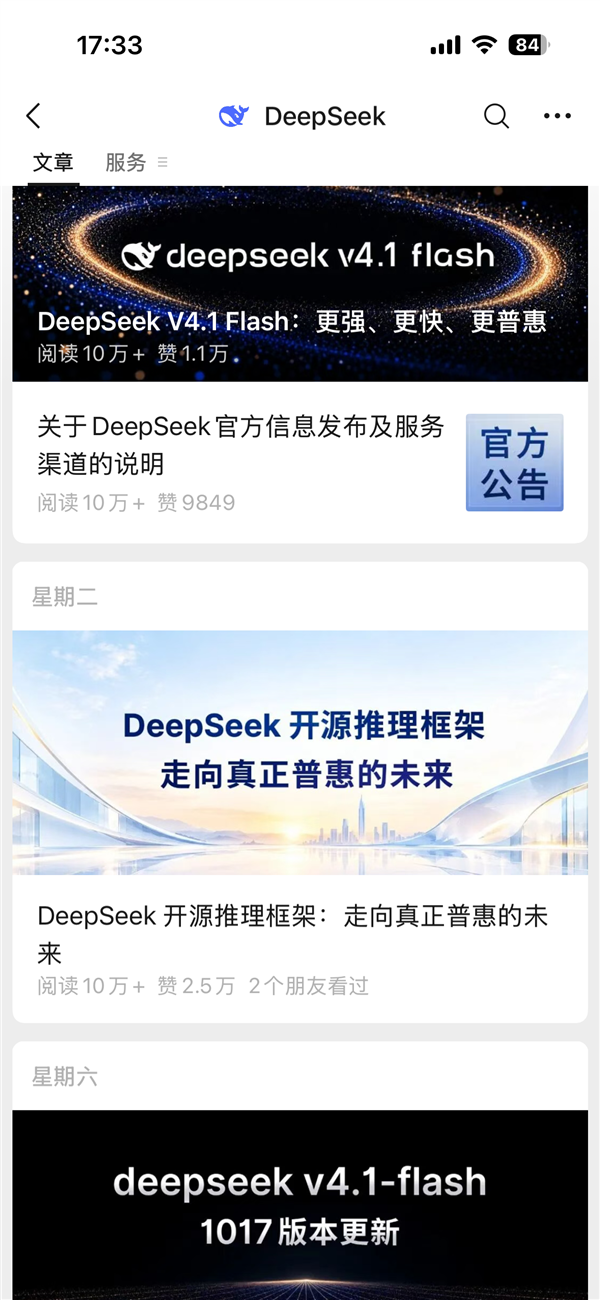
Cette erreur intéressante a été rapidement découverte par le responsable. L'image de couverture a été modifiée d'urgence et le texte a été restauré pour devenir « Vers un avenir véritablement inclusif ». Le petit oolong s'est terminé avec succès.
Blague à part, le poids de cet article lui-même est le véritable objectif de cet incident. DeepSeek a récemment officiellement publié un tweet annonçant que son cadre d'inférence interne DeepInfer est entièrement open source.
Les développeurs qui connaissent le rythme de DeepSeek savent que cette équipe a continué à intensifier ses efforts dans le domaine de l'open source et a déjà publié un certain nombre de grands modèles, des chaînes d'outils de compilation TileLang et des bibliothèques d'opérateurs d'inférence prenant en charge.
Cette fois, ils ont divulgué directement au monde extérieur le moteur d'inférence sous-jacent qui prend en charge les services en ligne à grande échelle et ont présenté un plan de déploiement complet peaufiné dans l'environnement de production, démontrant leur sincérité.
La citation officielle « faites-le pour le bien et faites-le pour tout le monde, faites-le pour la compétence et faites-le pour tout le monde » pour clarifier l'intention initiale.
Pour faire simple, si un grand modèle doit être mis en œuvre, non seulement des paramètres de modèle solides suffisent, mais le cadre d'inférence est la clé pour déterminer le débit, la latence et les factures de puissance de calcul.De nombreuses équipes et entreprises de petite et moyenne taille ont obtenu de grands modèles open source, mais elles sont bloquées dans le processus de déploiement : les demandes simultanées élevées ne peuvent pas être gérées, les délais fluctuent considérablement, la surcharge de puissance de calcul reste élevée et le coût du déploiement privatisé et du lancement du cloud public a découragé de nombreux acteurs.
DeepInfer est open source et vise ce problème.
DeepSeek espère partager l'expérience d'optimisation d'inférence à grande échelle accumulée dans la pratique interne avec l'ensemble de la communauté pour aider les développeurs et les entreprises à optimiser les indicateurs de services en ligne, à augmenter le débit, à réduire les délais de réponse et à créer en douceur des services d'IA dans le cloud privé ou public.
Une fois l'optimisation mise en place, la puissance de calcul et la consommation d'énergie diminueront simultanément, et le seuil d'utilisation des services d'IA sera abaissé, permettant à davantage d'industries et à davantage d'utilisateurs d'utiliser des services de grand modèle avec des performances de coût plus élevées et, à terme, d'atteindre l'objectif d'une « IA inclusive ».
Commentaires