Résumé :
Un ingénieur de Google DeepMind a récemment réalisé une expérience créative : il a réussi à exécuter le petit modèle de langage Gemma 3 270 M de Google directement dans une imprimante laser de bureau ordinaire. Le nombre de paramètres de ce modèle est d'environ 270 millions et l'imprimante utilisée dans l'expérience ne dispose que de 14,1 Mo de mémoire disponible, mais elle atteint néanmoins une vitesse de génération de plus de 60 mots par seconde.
Ce résultat a été annoncé par l'ingénieur Omar Sanseviero sur la plateforme sociale X. Il a déclaré qu'avec l'aide du projet Carbon, il avait exécuté le modèle Gemma directement sur l'imprimante de bureau. L’ensemble de l’expérience n’a pas modifié le micrologiciel de l’imprimante et n’a pas non plus utilisé de carte informatique externe ou autre matériel. Au lieu de cela, il s'appuyait entièrement sur le langage de description de page PostScript intégré aux imprimantes laser modernes.
PostScript est un langage de description de page complet de Turing qui est couramment utilisé pour contrôler la façon dont les imprimantes présentent le texte, les graphiques et la mise en page. L'équipe expérimentale a utilisé Carbon, un moteur d'inférence léger de Transformer, et l'a associé au modèle quantifié Gemma 3 270M pour finalement générer un fichier d'impression PostScript original. Lorsque l'imprimante exécute le fichier, elle termine le calcul d'inférence du modèle de langage dans son interpréteur PostScript.
Afin d'éviter de manquer de mémoire dans l'imprimante lors de l'inférence du modèle, l'expérience a adopté une technologie de chargement à flux laminaire dynamique. Le système charge constamment différentes couches du modèle dans et hors de la mémoire, maintenant l'utilisation maximale de la mémoire à seulement 14,1 Mo, tandis que l'imprimante alloue 244,6 Mo de mémoire virtuelle PostScript. Malgré cela, la Gemma 3 270M atteint toujours une vitesse de génération de 61,3 jetons/s sur le processeur de l'imprimante.
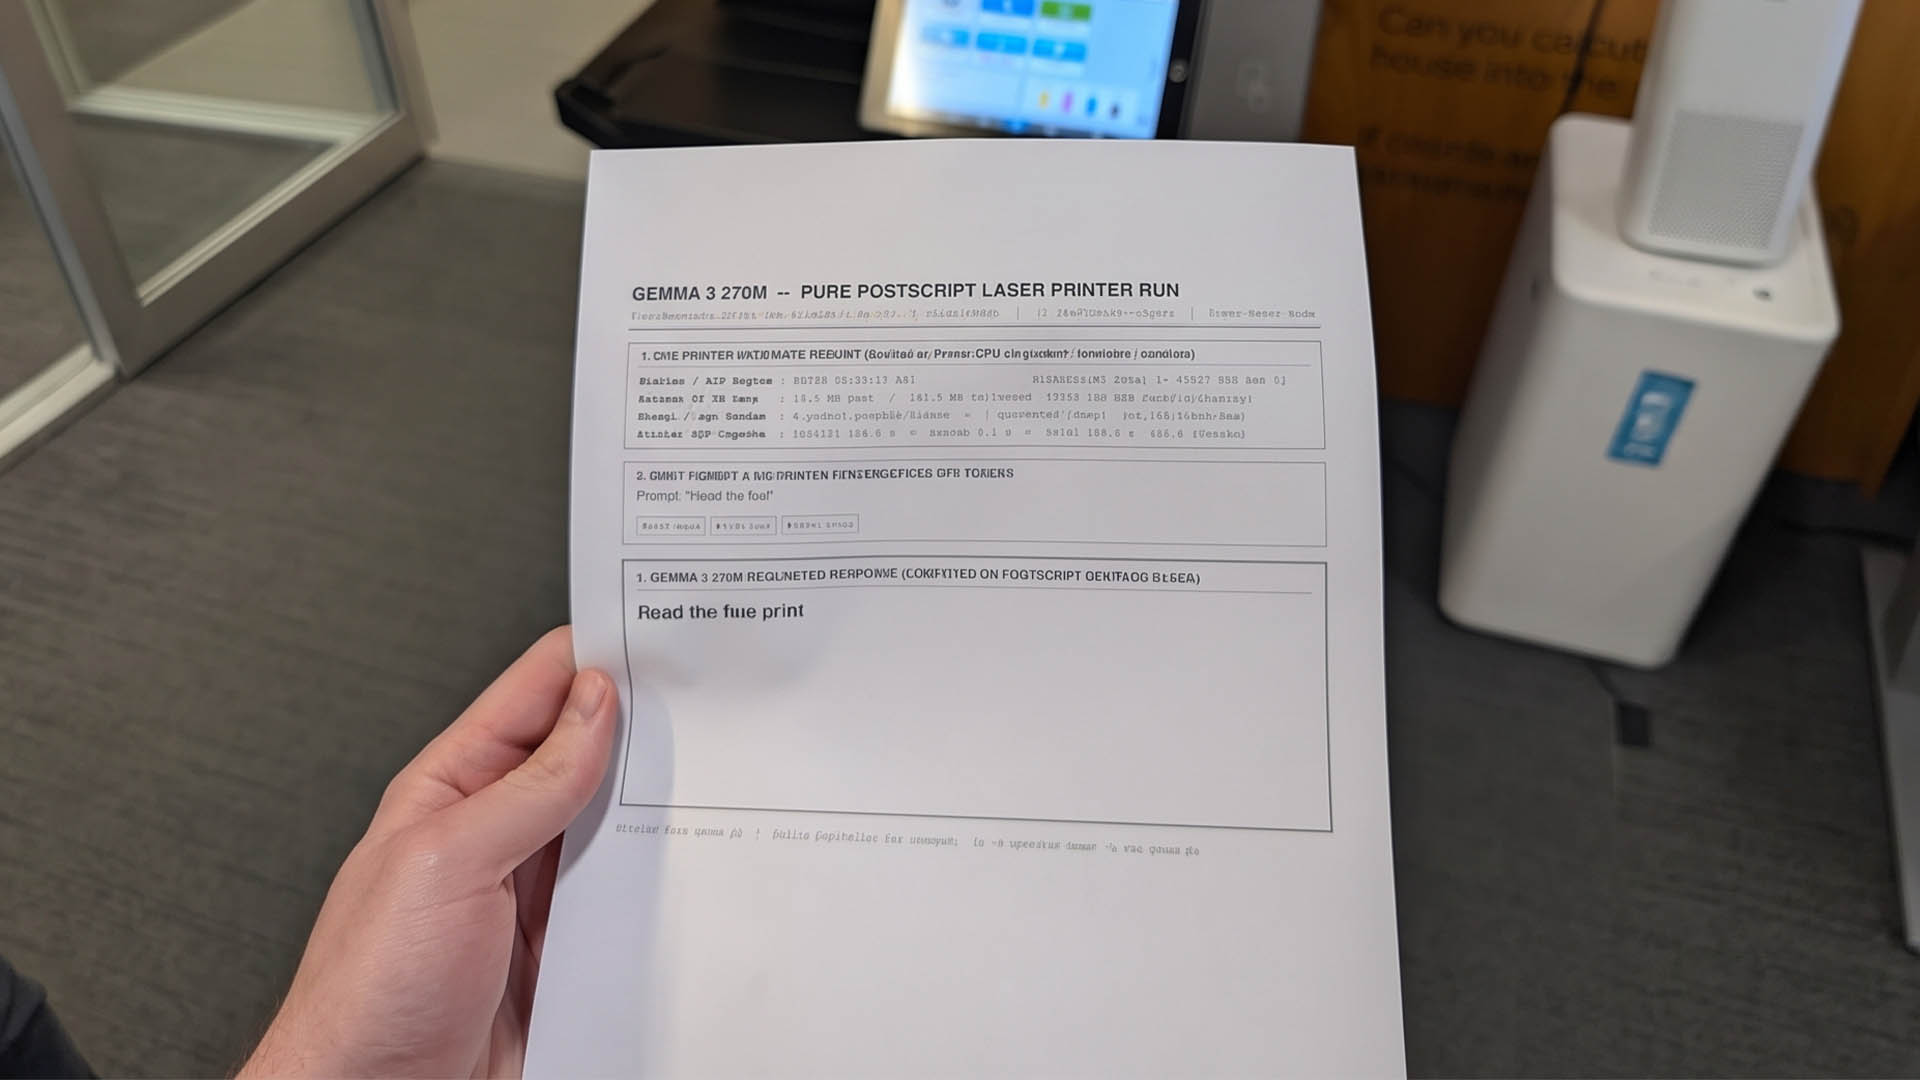
Selon les informations matérielles capturées lors de l'expérience, cette imprimante Ricoh effectue de manière native des calculs Transformer à 18 couches au sein de l'interpréteur PostScript niveau 3. Lorsque l'invite « Lire l'amende » contenant seulement quatre jetons est saisie, l'étape de pré-remplissage prend 184 secondes, tandis que le temps de décodage pour générer un seul jeton n'est que de 0,1 seconde et que l'ensemble du processus de traitement totalise 184 secondes.
Une fois le calcul terminé, l'imprimante imprime enfin la réponse en trois mots « Lisez les petits caractères » directement sur le papier. Ce résultat prouve non seulement que le modèle complète effectivement le raisonnement à l'intérieur de l'imprimante, mais montre également que le potentiel des équipements de bureau quotidiens au niveau logiciel dépasse de loin les attentes des gens. Bien que ce mode de fonctionnement ne soit pas adapté aux environnements de production réels, il démontre les limites de ce qui est possible en combinant de petits modèles quantitatifs, des moteurs d'inférence et des capacités matérielles existantes.
Commentaires