
Résumé :
De même, pour effectuer correctement les 10 tâches de programmation, la nouvelle version de DeepSeek coûtait moins de 40 % du Claude Opus 5.5, et l'attente moyenne pour chaque tâche était de deux minutes plus longue.
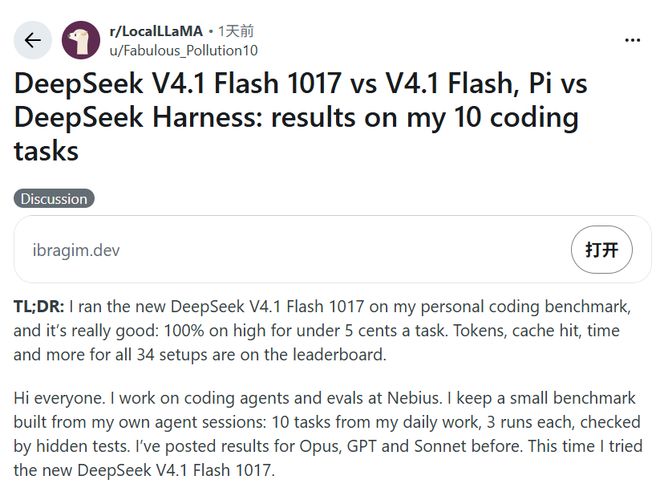
Le 17 octobre, DeepSeek a publié la V4.1-Flash-1017 et le prix est resté inchangé. Après sa sortie, les développeurs l'ont déjà utilisé pour créer des jeux, créer des pages Web et modifier du code.
Afin de tester son niveau réel, le développeur Ibragim Badertdinov a sélectionné 10 tâches de son travail quotidien et a exécuté différents modèles trois fois dans le même ensemble d'outils de programmation, en utilisant la vitesse d'inférence élevée de DeepSeek V4.1-Flash-1017 et la vitesse basse d'Opus 5.5 et GPT-6 Astra.
Après les tests réels, les trois modèles ont réussi le test, mais l'écart s'est creusé en raison de la facturation et du temps perdu : DeepSeek n'a dépensé en moyenne que 0,045 USD par tâche, ce qui était bien inférieur aux 0,1168 USD d'Opus et à environ 0,26 USD de GPT-6 Astra ; cependant, Opus et GPT n'ont pris que 37 secondes et 55 secondes, respectivement, mais DeepSeek a pris 2 minutes et 38 secondes.
Ces 10 tâches sont toutes de petite envergure. En tant que projet complet, l'écart entre DeepSeek, GPT et Claude est-il simplement une question d'attente encore un peu ?
Réussite des dix questions en 01, DeepSeek permet d'économiser de l'argent, Opus fait gagner du temps
Les sujets choisis par Ibragim provenaient d'environ trois mois de ses propres expériences d'utilisation d'agents, impliquant le traitement des données, le back-end, le front-end et le déploiement, en utilisant Python et TypeScript. Il a sélectionné les tâches qu'il pouvait habituellement accomplir en moins d'une heure, puis y a ajouté des programmes de vérification automatique.
Un exemple simplifié qu'il a divulgué consiste à importer un lot de données dans une table de données locale. En plus de réussir l'importation, le programme doit également ignorer les enregistrements en double, rejeter les numéros contradictoires et signaler les données insatisfaisantes ; lors du remplacement d'anciennes données, il ne peut pas détruire le contenu original à mi-chemin de l'écriture. Le test vérifiera les entrées vides, les conflits de données, la corruption du fichier d'origine, etc.
Les trois modèles ont réussi ces contrôles, mais DeepSeek a pris d'autres mesures.
Fonctionnant également sur l'outil de programmation Pi, DeepSeek effectue en moyenne 15,3 étapes par tâche, Opus 3,7 étapes et GPT-6 Astra 6,5 étapes. L'utilisation totale des jetons de DeepSeek est d'environ 547 000 et celle d'Opus est d'environ 31 000.J'en consomme beaucoup, mais la facture n'augmente pas. Ibragim a expliqué que presque toutes les entrées DeepSeek ont atteint le cache et que le taux de réussite du cache enregistré a atteint 97,9 %. Les 547 000 jetons n'ont pas été nouvellement écrits par le modèle. Une réponse aussi longue incluait du contenu envoyé à plusieurs reprises lors de plusieurs séries d’appels. Des entrées mises en cache bon marché ont permis de maintenir le coût de ce test à moins de 5 cents par test.
Pour les utilisateurs, l'impact de ces deux minutes dépend du fait qu'ils aient ou non attendu devant l'écran. Après avoir confié la tâche et fait autre chose, attendre peut ne pas être un obstacle ; si vous souhaitez effectuer la prochaine série de modifications immédiatement après avoir vu les résultats, la vitesse d'Opus et de GPT dans cet ensemble de tests est plus utile. Ce qui est comparé ici, c'est le coût d'exécution des tâches via l'API, et non les frais mensuels des forfaits d'abonnement ChatGPT ou Claude.
La nouvelle version est également améliorée par rapport à la version précédente. Ibragim utilisait auparavant le paramètre d'inférence le plus élevé de la version de septembre de Flash pour tester et réussissait 28 fois sur 30 exécutions, avec une durée moyenne de 4 minutes et 30 secondes pour chaque test. Cette fois, en utilisant la nouvelle version du réglage haut de gamme, il a réussi les 30 fois et le temps a été réduit à 2 minutes et 38 secondes.
02 J'ai construit une BMW pour 0,38 $, mais il m'a fallu 40 minutes pour exécuter une page Web ordinaire
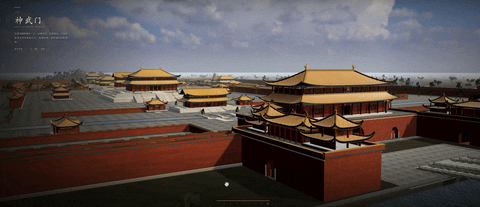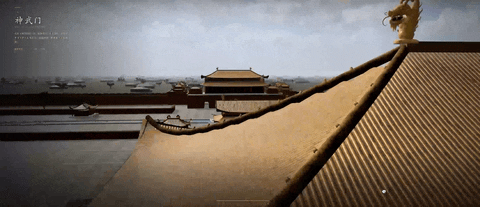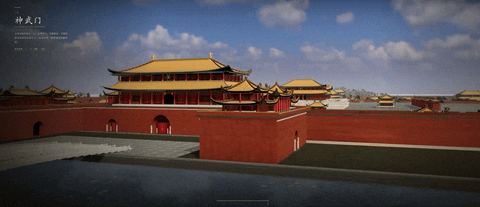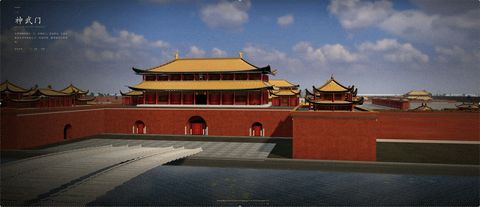
Ce que DeepSeek veut montrer cette fois, ce n'est pas seulement remplir une fonction. Les cas officiellement publiés incluent la scène 3D de la Cité Interdite, un jeu de course sur le Web et une démonstration de reproduction "Portal 2" réalisée avec Godot. La société affirme que la nouvelle version améliore la capacité de mener à bien des projets à partir de zéro grâce à un apprentissage par renforcement avec auto-évaluation.
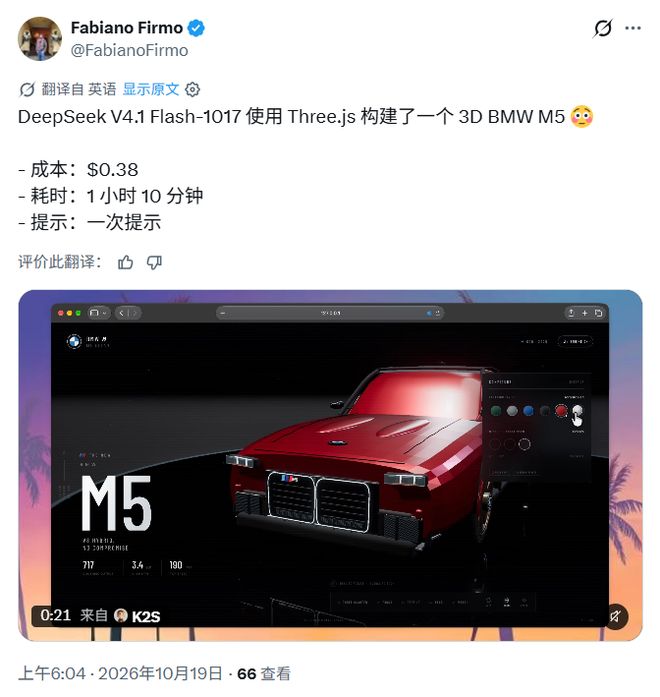
Le développeur Fabiano Firmo lui a demandé d'utiliser Three.js pour créer un modèle 3D de la BMW M5. Sur la photo qu'il a publiée, une voiture rouge apparaît sur la page d'affichage, avec des options de couleurs à côté.
Selon lui, il n'a fait qu'un seul rappel cette fois-ci, qui a coûté 0,38 $ et a pris 1 heure et 10 minutes.
Certains utilisateurs ont également fait la démonstration d'un jeu similaire à "Rocket League", dans lequel des voitures jouent au football sur le terrain. L'utilisateur X, Markets & Mayhem, a commenté que les effets physiques fonctionnent normalement et qu'ils sont jouables, mais qu'ils doivent encore être peaufinés. Pour quelqu'un qui souhaite d'abord prototyper une page Web ou un jeu, ces démos sont plus faciles à utiliser que les résultats d'examens modèles.
Cependant, être prêt à attendre plus d'une heure pour voir une voiture en 3D ne signifie pas que vous êtes prêt à attendre aussi longtemps pour créer une page Web ordinaire.
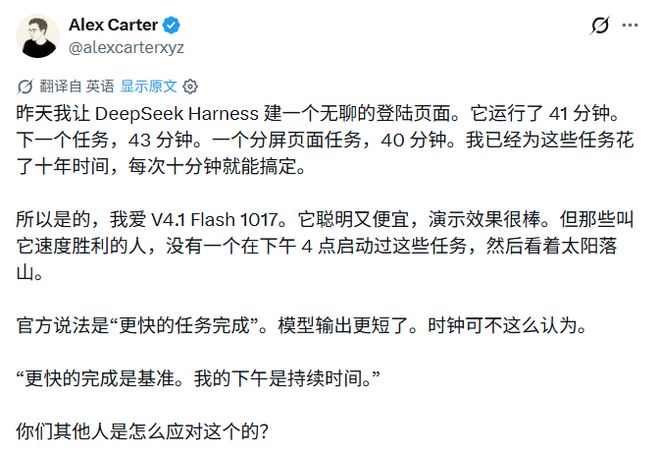
Le développeur Alex Carter a déclaré avoir demandé à DeepSeek Harness de créer une page de destination ordinaire, dont l'exécution a pris 41 minutes ; les deux tâches de page Web suivantes ont pris respectivement 43 minutes et 40 minutes supplémentaires. Il pensait que le modèle était intelligent, bon marché et bien présenté, mais les pages représentaient des années de travail et pouvaient généralement être complétées en dix minutes.
Le débug du développeur a également un sentiment similaire : le modèle est devenu plus intelligent, mais il est facile de réfléchir trop longtemps et de retarder l'action. Un autre utilisateur, Elshayib, a souligné que sa plainte ne concernait pas le nombre de mots produits par seconde, mais que le modèle mettait trop de temps à réfléchir avant d'agir.
Un test de la plate-forme API OmniaKey a enregistré ce long résultat de raisonnement. Il nécessite que la nouvelle version de Flash écrive un programme qui calcule les expressions selon les règles de fonctionnement de Python et ne puisse pas appeler d'outils d'analyse prêts à l'emploi. Le modèle a mis environ 88 secondes pour réussir les 30 cas d'utilisation d'inspection ; sur les quelque 20 700 jetons produits, environ 19 700 étaient considérés comme du contenu.
Mais Flash n'est pas lent pour toutes les tâches. Dans un autre test d'OmniaKey, il a extrait 10 champs d'un e-mail de facture mélangé en allemand et en anglais, et a répondu correctement à tous en 5,2 secondes ; l'appel à l'outil pour interroger la météo et l'heure dans deux villes a été réalisé en 2,6 secondes. OmniaKey lui-même vend l'API modèle, et chacun de cet ensemble de tests ne sera exécuté qu'une seule fois.
Ces exemples de modélisation et de pages de destination BMW ne constituent pas des comparaisons de trois modèles sur le même sujet. L'état du produit fini de deepSeek et le nombre de fois qu'il sera révisé ultérieurement doivent encore être comparés à GPT et Claude selon les mêmes exigences.
03 Après avoir baissé le rapport, c'était une minute plus rapide et il y a eu trois autres pannes
Étant donné que le paramètre d'inférence élevé prend beaucoup de temps, que se passera-t-il s'il est abaissé ? Ibragim l'a également testé.
Dans Pi, une fois que la nouvelle version de DeepSeek est ajustée au réglage bas, le temps moyen par élément est réduit de 2 minutes et 38 secondes à 1 minute et 31 secondes, et le coût est réduit de 0,045 USD à 0,0257 USD. Cependant, 3 exécutions sur 30 ont échoué.
Toutes les passes obtenues à des niveaux élevés ne peuvent être conservées intactes.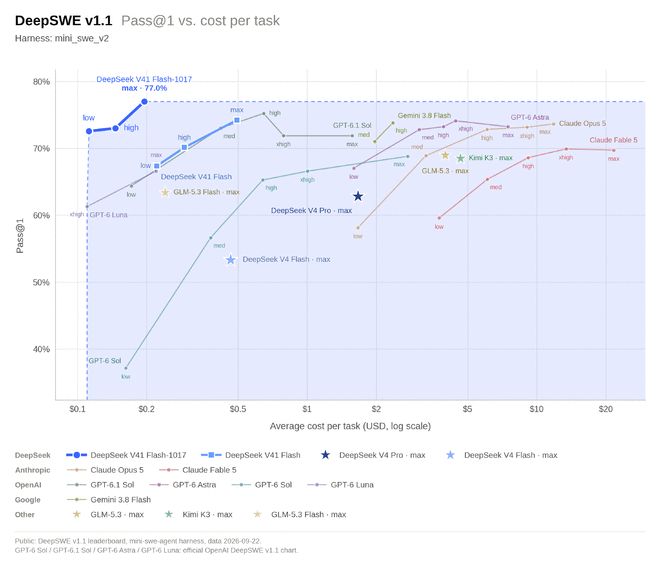
À ce niveau bas, je suis passé au harnais de DeepSeek, et les résultats ont encore changé : il a réussi 29 fois en 30 exécutions, soit deux de plus que Pi. Selon les archives d'Ibragim, l'environnement de l'outil officiel a aidé le modèle à gérer une condition aux limites qui manquait dans Pi.
Les deux ensembles d'outils fonctionnent différemment avec les modèles. DeepSeek Harness fournit directement des outils de lecture et d'édition de fichiers, tandis que Pi permet principalement d'utiliser le modèle via la ligne de commande ; les mots d'invite du système du premier sont également plus longs. Après avoir changé d'outil cette fois, l'utilisation des jetons a augmenté d'environ 75 % et le temps moyen passé est passé de 1 minute et 31 secondes à 1 minute et 53 secondes. Dans les deux ensembles d’outils, seules 9 tâches peuvent être accomplies trois fois de suite.
Pour le même modèle, si vous modifiez l'équipement d'inférence et l'ensemble d'outils, la vitesse, le coût et le succès changeront.
Vous ne voyez que les résultats publiés par les autres, mais vous devez également savoir quels paramètres ils ont utilisés.DeepSeek a également clairement mentionné lors de sa sortie qu'il disposait d'outils optimisés tels que DeepSeek Harness, Tencent CodeBuddy et WorkBuddy, et a recommandé aux utilisateurs de Harness de passer à la version 0.2.1-rc.1 ou supérieure.
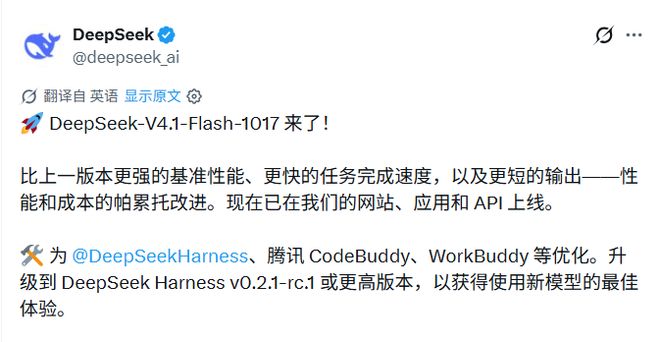
Cette mise à jour a été lancée sur les pages Web, les applications et les API. Les appels d'API utilisent toujours deepseek-flash et le prix reste inchangé ; les nouveaux poids du modèle ont également été rendus publics dans le cadre du protocole MIT.
Cependant, le test de programmation précédent a été réalisé en connectant le modèle à un outil capable de lire des fichiers, de modifier le code et d'exécuter des vérifications. Lui demander d’écrire un morceau de code dans la fenêtre de discussion est différent de lui demander de reprendre un projet. L'environnement d'utilisation est différent.
04Pour le même ensemble de questions, GPT et Claude peuvent être moins chers
Opus et Astra sont les produits phares des deux sociétés, et OpenAI et Anthropic proposent également des modèles moins chers.
Dans la même série de tests Ibragim, la vitesse élevée du GPT-6 Luna et la vitesse élevée du Haiku 5.5 ont toutes réussi 30 fois. Le coût moyen de chaque article n'était respectivement que de 0,0145 USD et 0,0208 USD, ce qui est inférieur à celui de DeepSeek.
La consommation moyenne de temps des deux est respectivement de 2 minutes et 46 secondes et de 2 minutes et 08 secondes.Le choix n'est plus seulement "GPT cher, Claude" ou "DeepSeek bon marché". Les personnes qui utilisent déjà Luna ou Haiku pour gérer de petites tâches ne pourront peut-être pas économiser davantage en passant à Flash.
Des tâches plus difficiles changent la question du temps d'attente, mais plutôt de savoir si vous pouvez faire confiance aux résultats. L'utilisateur de X, Yum, a déclaré qu'après avoir essayé la nouvelle version, il était toujours très inquiet des hallucinations, en particulier de la reconstruction et de la modification de l'architecture de plusieurs fichiers. Il demanderait à un autre modèle de vérifier les modifications plutôt que de laisser DeepSeek approuver sa propre solution. C'est son choix d'usage, pas un test sur la même question pour prouver que GPT ou Claude est plus fiable.
Par conséquent, le progrès le plus solide à l'heure actuelle est que la nouvelle version de DeepSeek a fourni les mêmes résultats d'inspection que le modèle phare dans un lot de véritables petites tâches de programmation.
Le nombre de corrections manuelles nécessaires dans les grands projets et la possibilité de résoudre les problèmes détermineront jusqu'où ce remplacement peut aller.
Il y a encore beaucoup de travail entre construire une voiture 3D et maintenir un projet sur le long terme.Ibragim se prépare également à rendre cette épreuve plus difficile. Il a déclaré à la fin du message que la prochaine étape consisterait à sélectionner un groupe de tâches beaucoup plus difficiles et à comparer différents outils et modèles.
Commentaires