Résumé :
Le 9 novembre, heure locale, Anthropic a sorti Claude Fable 5.2 et Claude Mythos 5.2. Les deux partagent le même modèle sous-jacent. Fable est disponible pour tous les utilisateurs et dispose de protections intégrées en matière de cybersécurité et de biosécurité ; Mythos supprime ces restrictions et n'est ouvert qu'aux institutions qui réussissent le programme de vérification Cyber ou Life Sciences.
Après sa sortie, les descriptions de chacun étaient presque les mêmes : plus fort et plus rapide. Certains développeurs estiment également que le prix est erroné à première vue. Pour le codage, Fable 5.2 n’est pas rentable. Cependant, Anthropic lui-même a déclaré dans la documentation de la version que pour la plupart des travaux de codage et de connaissances, il est recommandé à tout le monde de "commencer avec Claude Opus 5.5".
Les modèles les plus puissants de l'histoire sont constamment mis à jour, mais il ne reste plus beaucoup de temps pour les utiliser. Avant d’atteindre l’AGI, les entreprises d’IA ont d’abord atteint le plafond de la commercialisation.
Les plus forts continuent de devenir plus forts, le prototype de la main-d'œuvre numérique a-t-il émergé ?
Parlons d’abord de ce qui est fort. FrontierCode 2.0 teste "si les responsables de projets open source sont disposés à fusionner le code écrit par des modèles". Au niveau de puissance de calcul le plus élevé, Fable 5.2 a atteint 49,1 %, tandis que la génération précédente Fable 5.1 a atteint 32,4 %.
L'indice du travail à distance, qui mesure le nombre de tâches de travail à distance réelles qu'un modèle peut effectuer de manière indépendante, a plus que doublé, passant de 17,9 % à 41,3 %.
Anthropic dispose également d'un test interne de simulation de robot, RoboDojo Sim, dont le score est passé de 27,6 % à 64,9 %. Cependant, ce numéro provient des opérations internes de l’entreprise et ne peut être reproduit par le monde extérieur.
Ensuite, il y a le point faible. Également dans le tableau de comparaison officiel, dans AutomationBench, les 51,4 % de Fable 5.2 ont perdu contre les 53,9 % de Google Gemini 4 Carbon.
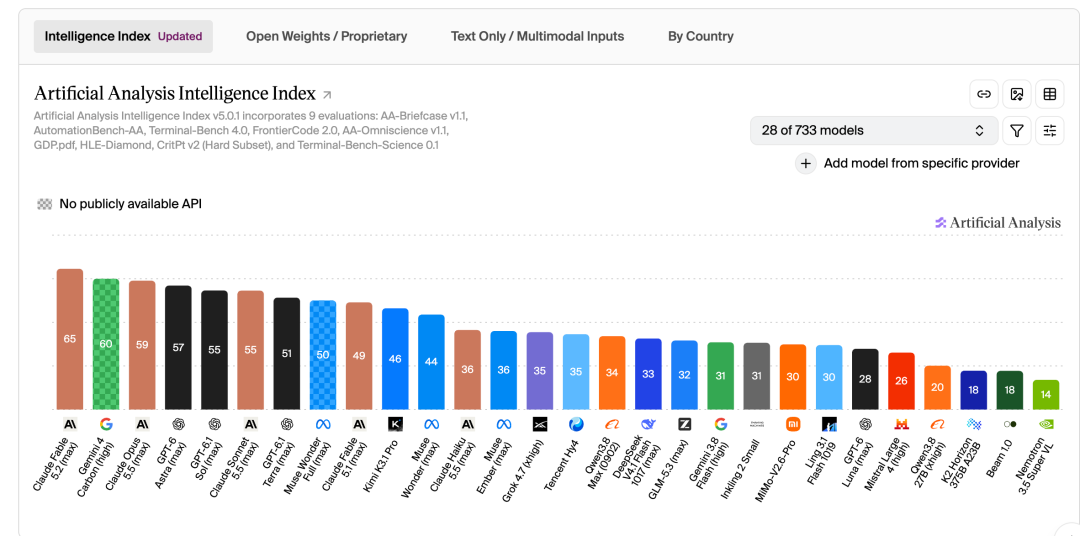
Sur la liste intelligente de la plateforme externe Artificial Analysis, Fable 5.2 arrive en tête de liste avec 65 points, dépassant de loin Gemini 4 Carbon à la deuxième place avec 60 points, et 9 points derrière GPT-6 astra à la quatrième place.
Quelle est sa force ? En plus d’une journée, un exploit majeur dans l’histoire des mathématiques humaines a été directement réalisé.
En 30 heures, la vérification formelle du dernier théorème de Fermat était terminée ; en outre, deux problèmes de physique non résolus liés aux trous noirs et à la gravité quantique ont également été résolus. Il peut également faire fonctionner un système d'exploitation de manière totalement indépendante, concevoir et fabriquer indépendamment des équipements électroniques et prédire la structure des capsides de virus adéno-associés complexes...
Certaines personnes pensent que Fable 5.2 signifie que l'IA passe d'un outil de productivité à une main-d'œuvre numérique dotée de capacités d'exécution d'ingénierie.
Cependant, de nombreux groupes de développeurs pensent que cela peut signifier qu'Anthropic a « atteint sa fin » dans le sens du codage. Si l 'on ne développe pas de nouvelles pistes et de nouveaux modèles, il sera difficile de stimuler la perception des investisseurs. Et maintenant, cela coïncide avec la période critique pour laquelle Anthropic se dirige vers les prix d’introduction en bourse.
Le prix est très en avance, donc Anthropic vous recommande de ne pas l'utiliser
Cependant, lorsque de nombreux développeurs étaient impatients de tester les fonctionnalités de Fable 5.2, ils ont constaté qu'il y avait un problème avec le prix.
Le prix standard de Fable 5.2 est de 8 $ pour l'entrée et de 40 $ pour la sortie par million de jetons, ce qui semble être une baisse de 20 % par rapport aux 10 $ et 50 $ de la génération précédente, et la vitesse de sortie est jusqu'à 30 % plus rapide que la version 5.1. S'il est trop lent, vous pouvez activer le mode rapide, ce qui augmente la vitesse de 2,5 fois et double le prix. L'entrée est de 16 $ et la sortie est de 80 $.
Intuitivement, le coût par tâche en analyse artificielle est également très supérieur.
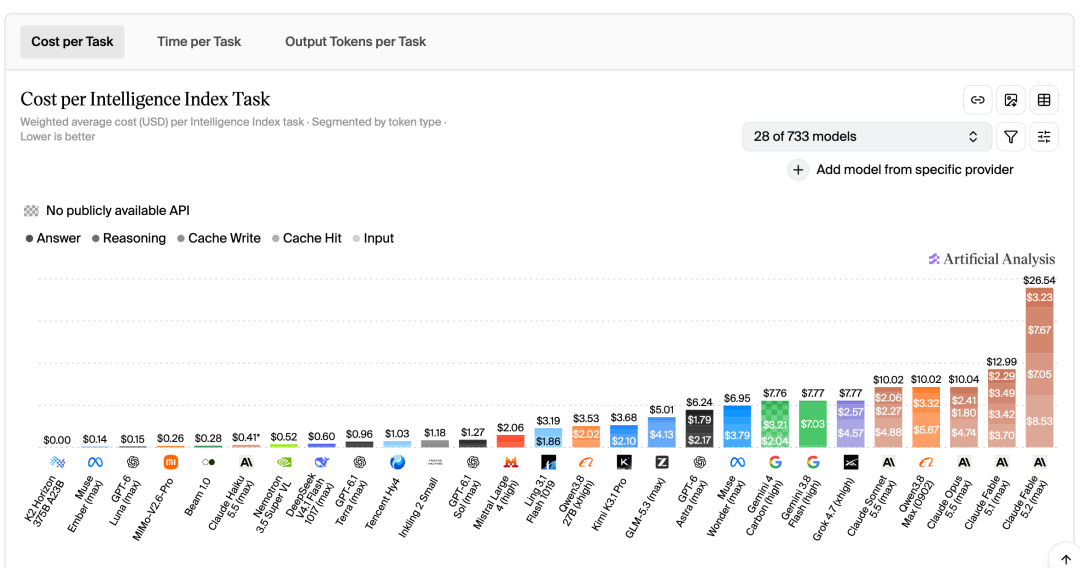
Cependant, Anthropic lui-même a mis une courbe « précision du code par rapport au coût par tâche » dans les documents de version et a conclu qu'au niveau de puissance de calcul moyen, les 45,3 % de Fable 5.2 sont déjà proches du niveau le plus élevé de 45,5 % de l'Opus 5.5, et le coût de réalisation d'une tâche n'est que d'environ la moitié.
À l'heure actuelle, les responsables d'Anthropic ont modifié l'échelle de mesure de la consommation intelligente. Au cours des deux dernières années, la comparaison des prix du secteur était basée sur le coût par million de jetons. Cette fois, il a été remplacé par le coût par tâche terminée. Les résultats mesurés par deux règles peuvent être complètement opposés. Un modèle dont le prix unitaire du jeton est 20 % moins cher peut coûter deux fois plus cher s'il faut trois tours supplémentaires pour réussir.
De plus, la recommandation officielle d'Anthropic est la suivante : "Pour la plupart des travaux de codage et de connaissances, nous recommandons aux utilisateurs de commencer avec Claude Opus 5.5."
En comparaison avec l'échelon de prix actuel, DeepSeek V4.1-Flash coûte 0,3 USD par million d'entrées et 1,2 USD par million de sorties, Kimi K3.1 Pro coûte 2 USD par million d'entrées et 10 US$ en sortie, et la version standard GPT-5.5 coûte 5 US$ et 30 US$. Le Fable 5.2 se situe au sommet, à 8 $ et 40 $.
En d’autres termes, ce modèle coûte très cher à chaque ouverture. Sa valeur réside dans le fait de l’ouvrir une fois à un moment critique, et non tous les jours.
À cet égard, Anthropic lui a assigné deux nouveaux rôles. L’un est conseiller. Des modèles bon marché comme Haiku, Sonnet et Opus viennent le demander lorsqu'ils rencontrent des problèmes. L'autre est Orchestrator, un planificateur. Il ne le fait pas personnellement, mais répartit les tâches et les assigne aux modèles plus petits ci-dessous.
Plus fort que le plus fort est toujours en cours de rafraîchissement, mais ce n'est plus le plus important
Anthropic a déclaré qu'un ingénieur avait donné à Fable 5.2 un dossier vide, qui coordonnait plus de 1 000 sous-agents et fonctionnait en continu pendant 8 jours, et avait finalement remis un prototype de système d'exploitation pouvant être démarré sur un ordinateur portable, avec son propre noyau, disque, clavier et pilote réseau, stockage de fichiers, fenêtre, interface de connexion et programme d'installation.
Un autre groupe d'agents a migré l'un des services de production d'Anthropic de Python vers Rust, et la vitesse de démarrage était environ 26 fois plus rapide après la migration.
Cela est même impliqué dans le matériel. Anthropic a déclaré avoir collaboré avec le fabricant de circuits imprimés Diode pour concevoir trois produits : un assistant vocal domestique, un haut-parleur de conférence USB et un animal électronique portable, comprenant des circuits imprimés, des boîtiers et des logiciels. Les cartes peuvent fonctionner sans aucune modification électrique une fois construites.
L'exemple mathématique est le suivant. Environ 1 000 agents ont passé moins de 30 heures à traduire la preuve existante du dernier théorème de Fermat sous une forme que Lean peut vérifier étape par étape. Faire la même chose en septembre de cette année a nécessité 11 jours, un échafaudage spécial et les conseils complets des chercheurs ; cette fois, seulement un tiers du jeton de sortie a été utilisé et la longueur de la preuve était d'environ un septième de la longueur d'origine.
Ces cas ressemblent à des frimeurs. Mais si vous remplacez « 1 000 sous-agents » par « 1 000 subordonnés », vous constaterez que cela décrit en réalité une structure organisationnelle et non un modèle.
Un initié de l'industrie estime que la concurrence pour les meilleurs modèles a convergé, c'est-à-dire la convergence des prix et la convergence des données. La prochaine étape est sans aucun doute l'étape « d'application », où la limite supérieure des capacités du modèle et la limite inférieure du prix sont réalisées en même temps, ce qui signifie que l'IA peut être utilisée pour différentes explorations différenciées. D’ici là, pour les modélistes, la concurrence portera sur des dimensions telles que le harnais, la mémoire et les habitudes des utilisateurs.
À ce stade, nous pouvons constater que les grands modélistes prennent des dispositions. Par exemple, DeepSeek et OpenAI complètent également le même ensemble de fonctionnalités.
En août de cette année, DeepSeek a lancé DeepSeek Harness en open source sous la licence MIT. Le 17 octobre, lorsque DeepSeek a publié la V4.1-Flash-1017, il a clairement indiqué que le nouveau modèle était optimisé pour les produits intelligents tels que DeepSeek Harness, Tencent CodeBuddy et WorkBuddy. Et Cui Tianyi de l'équipe de harnais a recruté des personnes à grande échelle. Ifeng Technology a déjà appris auprès d'initiés de l'industrie que Liang Wenfeng lui-même est meilleur dans "c'est aussi le domaine".
Le 5 novembre également, Kimi vient de publier Kimi Hosted Agents (agents hébergés), proposant officiellement Harness as a Service.
Le même jour, Cat Wu, responsable des produits Claude Code chez Anthropic, a rejoint OpenAI et était responsable de la gestion produit de l'équipe produit principale. Elle a contribué à faire passer Claude Code de prototypes internes à des produits commerciaux largement utilisés, puis a brièvement rejoint Cursor.
Claude Code est l'un des produits les plus représentatifs d'Anthropic sur le marché de la programmation d'IA. Cat Wu possède une expérience directe de son processus, de la conception du produit à la commercialisation. Son recrutement par OpenAI signifie évidemment renforcer les capacités du Codex et des produits Agent plus larges.
En fait, juste avant la sortie de Fable 5.2, le prétendu nouveau modèle de Gemini a été « divulgué ». L'utilisateur @chetaslua a commenté que "cela prend deux fois plus de temps et la quantité de code double". Il s'agit d'un nouveau point de contrôle pour Gemini 4 nommé "krypton" au sein de Google. On dit que les performances dans les visuels de génération de code et les scènes 3D dépassent considérablement le carbone nouvellement publié. Par conséquent, la vitesse de rafraîchissement des modèles haut de gamme augmente. Certaines personnes pensent que cela est dû au RSI, sinon il n’y a aucun moyen de l’expliquer.
Ensuite, la question se pose. Si l’intelligence n’est plus un problème, qu’est-ce que la compétitivité ? Comment se déroulera le prochain concours de mannequins ? La réponse sera bientôt révélée.
Commentaires