
Résumé :
Microsoft a officiellement annoncé Maia 300, une puce d'intelligence artificielle auto-développée de troisième génération, et prévoit de la déployer dans un environnement de production à partir de 2027 pour prendre en charge les tâches de raisonnement de l'IA derrière des produits et services tels que Copilot. Microsoft a déclaré que par rapport au système GPU leader actuel, Maia 300 devrait être capable de traiter 40 % de jetons en plus par mégawatt de puissance ; dans une configuration de rack complète composée de 96 accélérateurs, son débit de jetons au niveau du rack peut être jusqu'à 7 fois supérieur à celui de la génération précédente Maia 200.
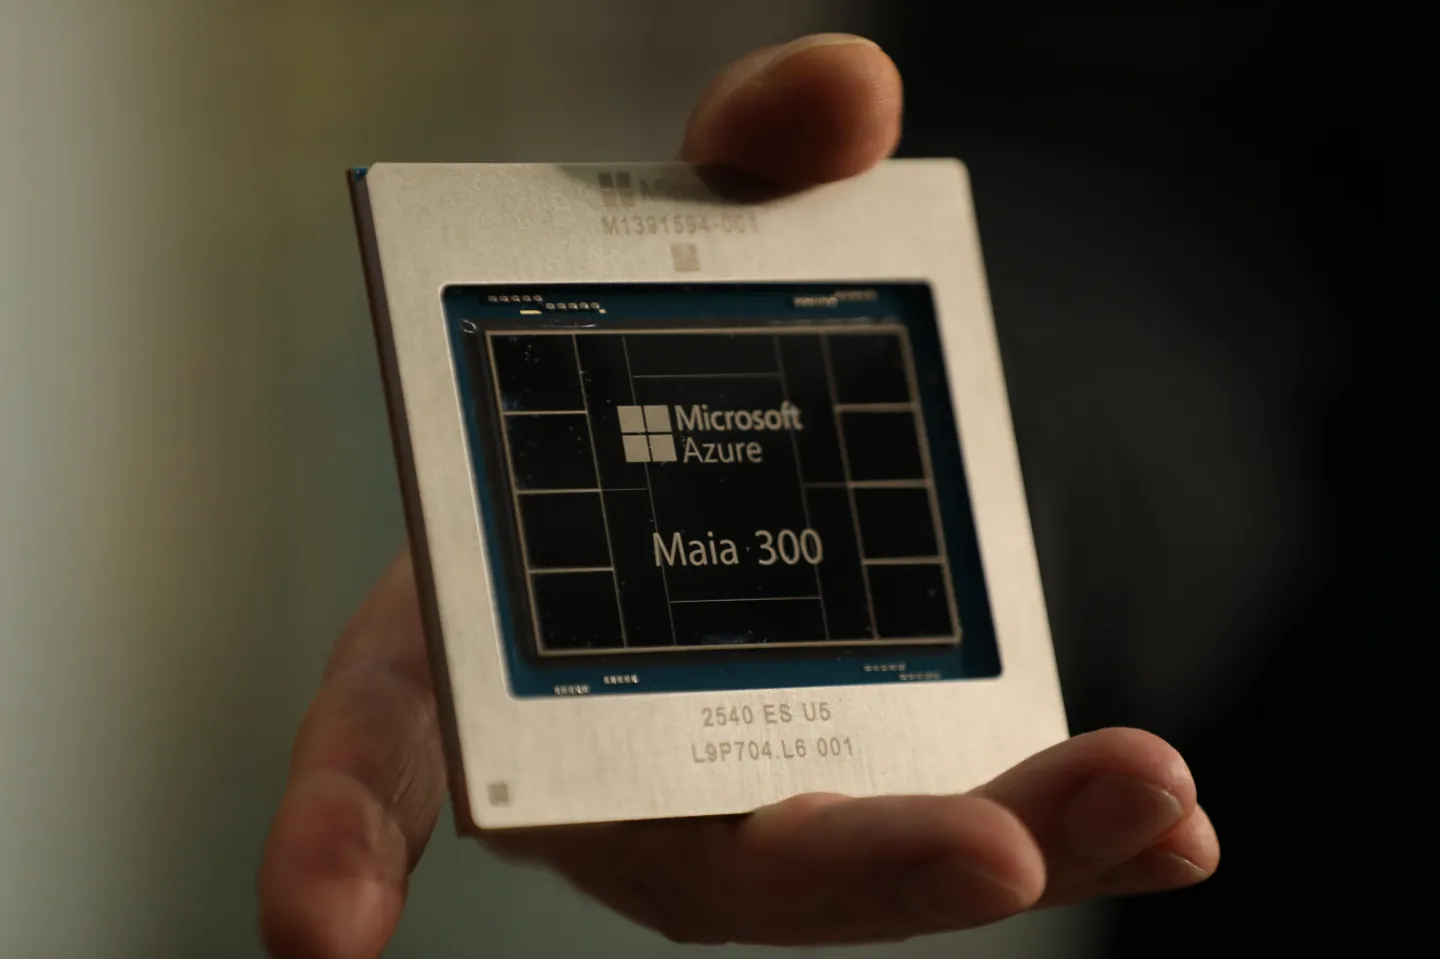
Cette version marque la poursuite des investissements de Microsoft dans les puces IA auto-développées. Alors que l'utilisation des services d'intelligence artificielle continue de croître, Microsoft espère réduire les coûts d'exploitation, améliorer l'efficacité énergétique et réduire la dépendance aux GPU de fournisseurs tels que Nvidia et AMD grâce à des accélérateurs auto-conçus.
Scott Guthrie, vice-président exécutif de l'activité cloud computing de Microsoft, a déclaré que la société prévoyait d'étendre l'échelle de déploiement des puces de la série Azure Maia au niveau de plusieurs gigawatts à partir de 2027 et d'en faire le principal système d'inférence d'IA pour les produits et services Microsoft.
Cet objectif signifie que Microsoft espère mettre progressivement à niveau les puces qu'il a développées en passant d'une partie de l'infrastructure existante à une plate-forme informatique de base prenant en charge ses propres services d'IA. Cependant, cela ne signifie pas que Microsoft cessera complètement d’acheter des GPU auprès de Nvidia ou d’AMD. Microsoft continuera probablement à utiliser plusieurs plates-formes matérielles pour les tâches de formation et d'inférence qui nécessitent des capacités informatiques différentes.
Maia 300 est le produit de troisième génération de la série Maia de Microsoft, et c'est également la puce de nouvelle génération lancée après l'annonce du Maia 200 en janvier de cette année. Maia 200 est actuellement utilisé pour les charges de travail d'IA dans plusieurs environnements de production Microsoft, notamment Microsoft Copilot, GitHub Copilot, Microsoft Foundry et les modèles d'intelligence artificielle auto-développés par Microsoft.
Guthrie a déclaré qu'à en juger par les indicateurs de fonctionnement des services d'IA réels, Maia 200 est déjà l'une des infrastructures d'IA les plus performantes de Microsoft. La nouvelle génération Maia 300 est spécialement conçue pour les charges de travail d'IA en constante évolution, en particulier celles qui doivent gérer un raisonnement sur un long contexte, des conversations en temps réel très sensibles à la latence et des tâches d'agent d'IA qui exécutent continuellement plusieurs étapes.
Ces applications imposent des exigences matérielles différentes de celles de l'inférence IA traditionnelle.
À mesure que les modèles de langage à grande échelle sont progressivement utilisés dans les assistants de programmation, l'automatisation d'entreprise et l'exécution de tâches complexes, le contexte que les systèmes d'IA doivent traiter devient de plus en plus long, et une seule tâche implique de plus en plus d'appels de modèles et d'opérations d'outils. Pour les fournisseurs de services cloud, outre les performances du modèle lui-même, la latence de réponse, le nombre de requêtes simultanées, la capacité de mémoire et le coût réel de chaque inférence doivent également être pris en compte.
Par conséquent, l'objectif de la conception du Maia 300 n'est pas seulement d'augmenter la puissance de calcul maximale, mais également d'améliorer l'efficacité globale dans un environnement professionnel réel qui fonctionne en continu. Microsoft espère optimiser spécifiquement l'architecture de la puce pour la rendre plus adaptée à la gestion de la charge de calcul générée par les modèles d'inférence et les agents d'IA de nouvelle génération.
En termes de fabrication de puces, Maia 300 adopte le processus avancé N2P de TSMC et introduit une architecture de conception basée sur les cœurs. Par rapport aux conceptions traditionnelles qui intègrent différentes fonctions sur une seule grande puce, l'architecture de la puce centrale peut diviser des fonctions telles que l'informatique, le contrôleur de mémoire et les entrées et sorties en différents modules, puis les concevoir en fonction de leurs caractéristiques respectives.
L'équipe matérielle et infrastructure de Microsoft Azure a déclaré que cette conception permet d'utiliser davantage de surface de silicium dans la puce pour les performances informatiques, tout en permettant à différents modules fonctionnels d'adopter des technologies plus adaptées à leurs propres besoins.
Cette idée a une signification pratique. Pour les accélérateurs d’IA, l’unité de calcul est importante, mais la manière dont les données sont transmises entre l’unité de calcul, la mémoire et les périphériques externes affectera également les performances globales. Si l’unité de calcul doit attendre l’arrivée des données, même si elle dispose d’une puissance de calcul théorique élevée, elle ne pourra pas exploiter pleinement ses performances.
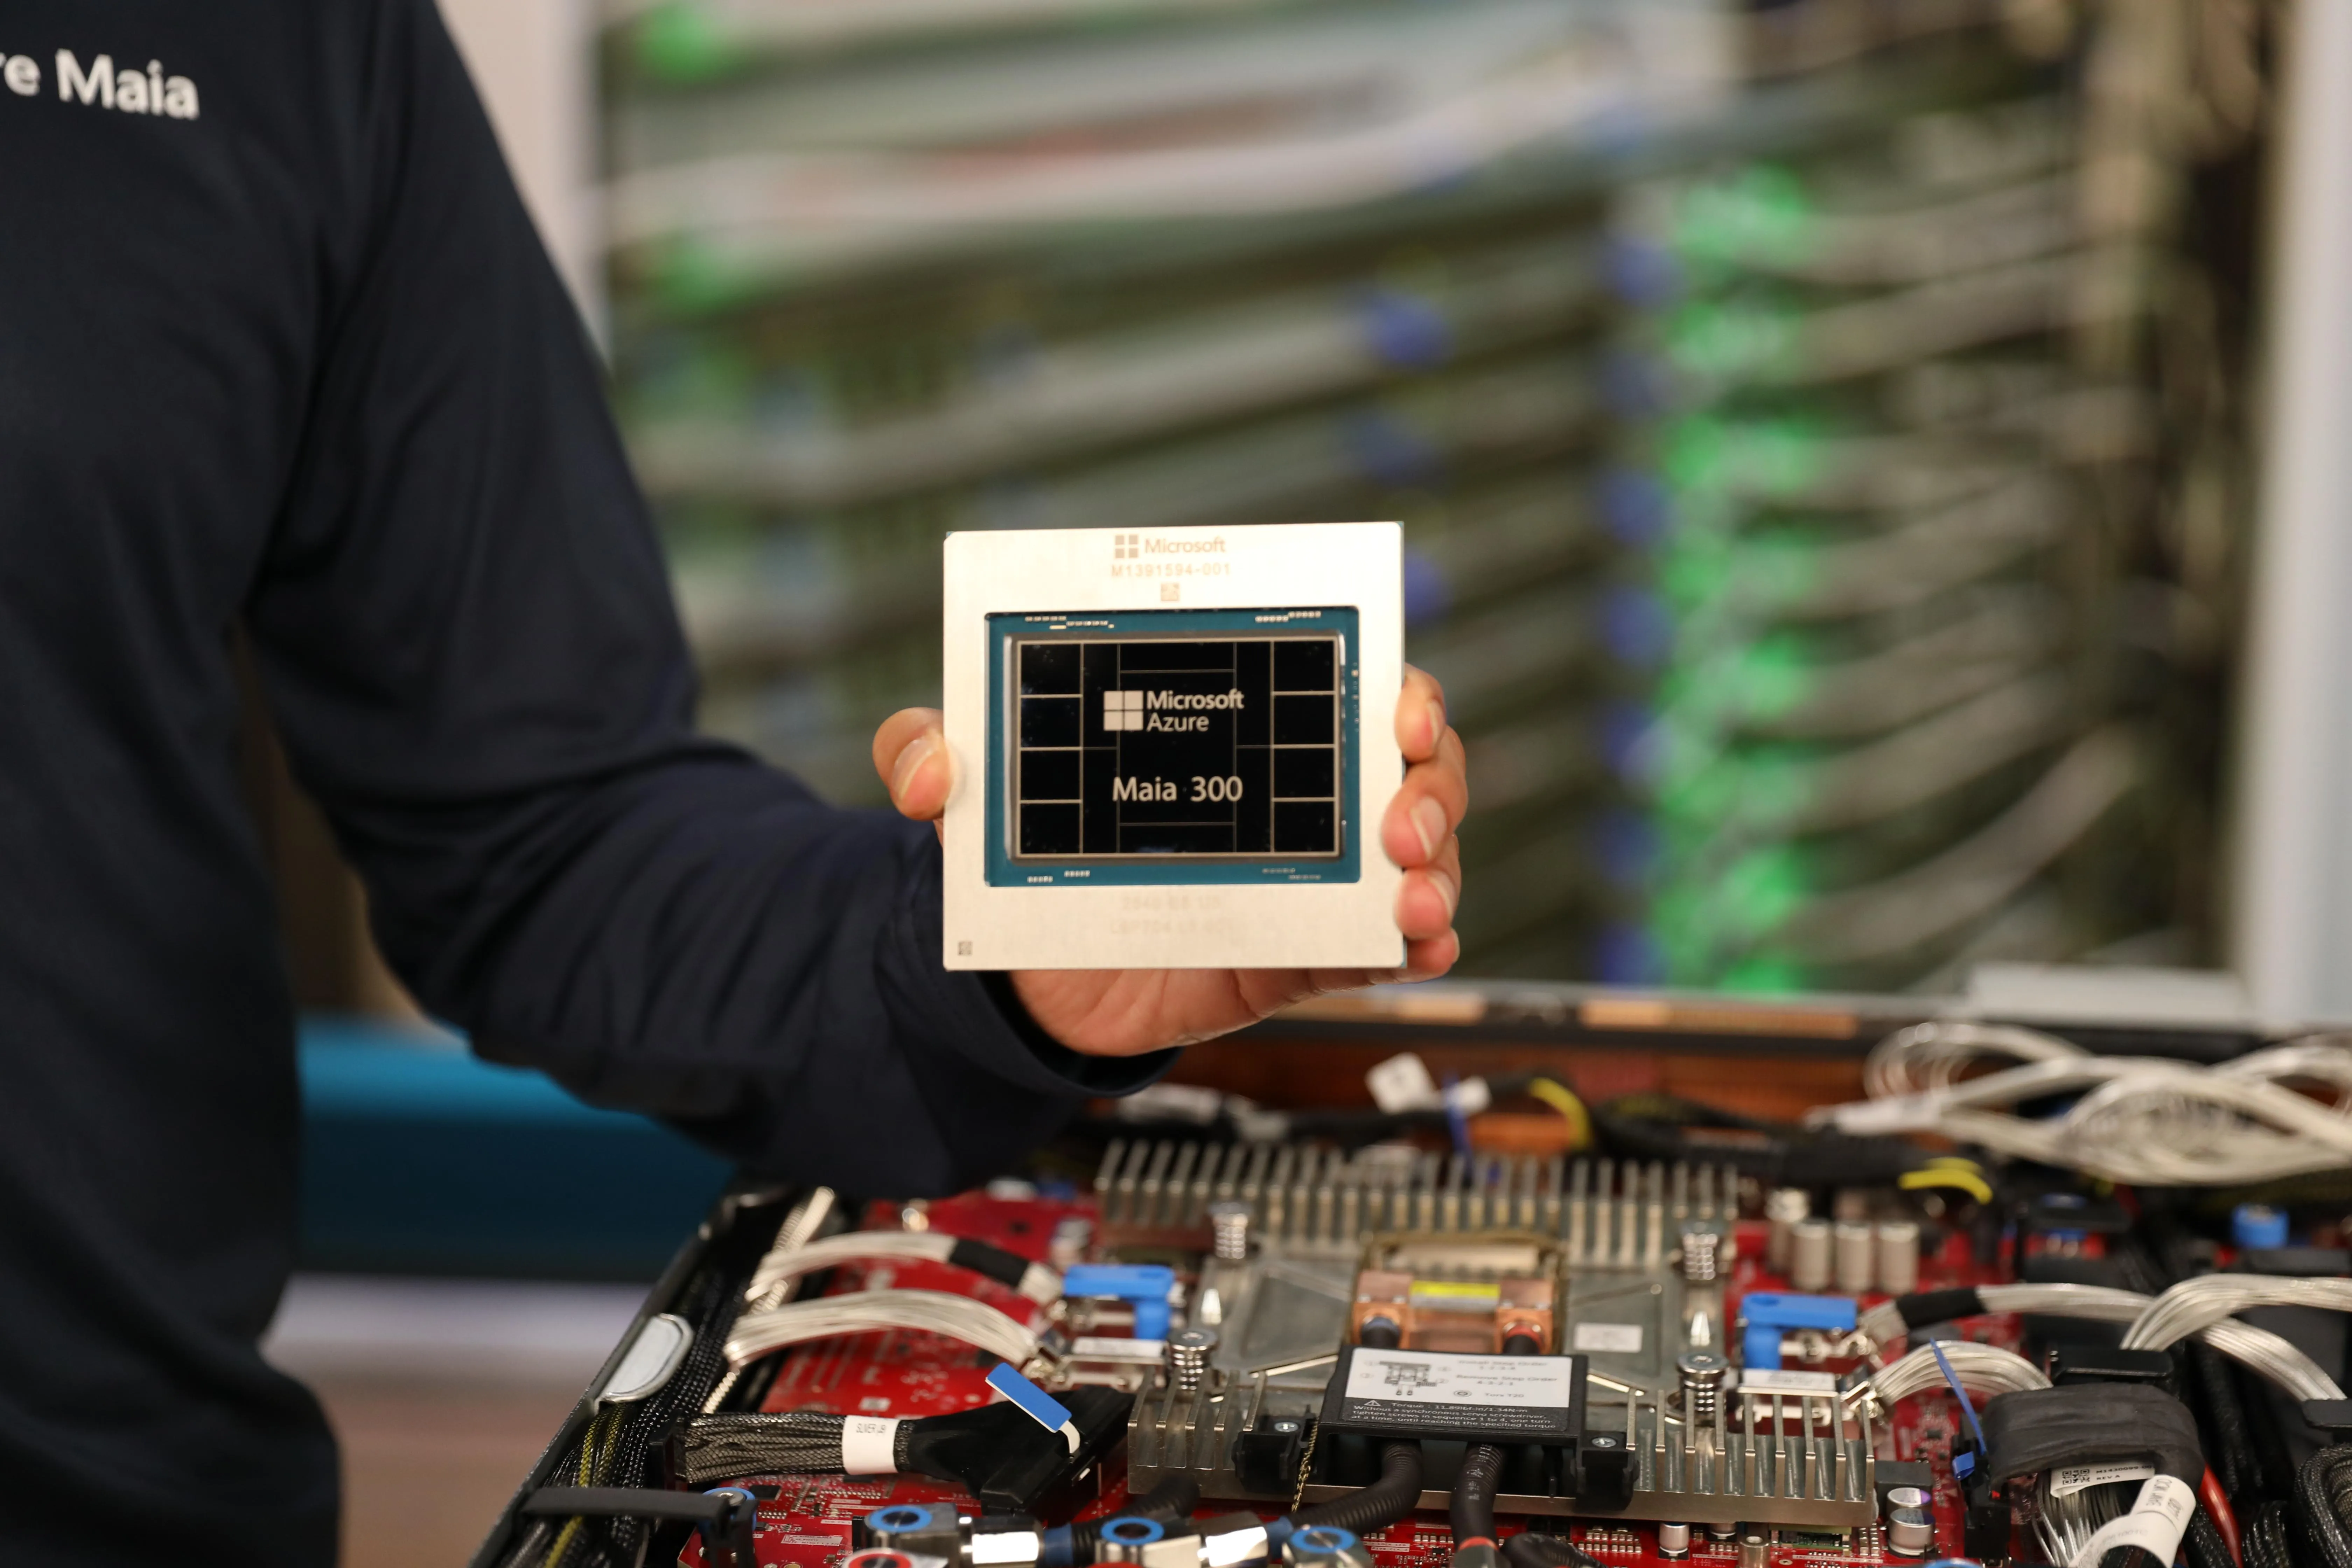
En optimisant séparément le calcul, le contrôle de la mémoire et les fonctions d'entrée et de sortie, Microsoft espère améliorer l'efficacité globale de l'utilisation des ressources de la puce et parvenir à un meilleur équilibre entre performances, consommation d'énergie et coûts de fabrication.
L'utilisation de processus avancés contribuera également à améliorer la densité des transistors et l'efficacité énergétique, mais les performances finales de la puce dépendent toujours de plusieurs facteurs tels que la microarchitecture, le sous-système de mémoire, la conception des interconnexions et l'optimisation logicielle. Les données de performances publiées par Maia 300 proviennent actuellement principalement de la propre introduction de Microsoft, et l'effet réel doit encore être évalué en fonction de différents modèles, charges de travail et conditions de déploiement.
Dans le domaine du raisonnement de l'IA, le débit des jetons est l'un des indicateurs importants pour mesurer l'efficacité du système. Le jeton est l'unité de données de base utilisée par les grands modèles de langage lors du traitement du texte, correspondant généralement à un mot, un fragment de mot ou une autre unité de texte. Le nombre de jetons que le système peut traiter par unité de temps affecte directement le nombre d'utilisateurs qu'il dessert en même temps et les ressources informatiques requises pour accomplir la tâche.
Microsoft s'attend à ce que le Maia 300 gère 40 % de jetons en plus par mégawatt que les principaux systèmes GPU. Cela signifie qu'avec le même budget énergétique, Microsoft devrait traiter davantage de requêtes d'IA ou réduire la consommation d'énergie tout en fournissant les mêmes capacités de service.
Pour les fournisseurs de services cloud disposant de centres de données à grande échelle, cette amélioration de l'efficacité peut apporter une valeur économique significative. Les centres de données d’IA doivent non seulement acheter des accélérateurs coûteux, mais doivent également supporter les coûts d’alimentation électrique, de refroidissement, d’équipement réseau et de construction d’infrastructures. À mesure que l’utilisation des modèles continue de croître, l’alimentation électrique et la capacité des centres de données deviennent des facteurs importants limitant l’expansion des services d’IA.
Cependant, l'efficacité des jetons par mégawatt n'est pas le seul indicateur permettant de mesurer les puces IA. L'échelle des paramètres, la longueur du contexte, les paramètres de précision et les méthodes d'inférence des différents modèles affecteront tous les résultats des tests. Pour comparer de manière exhaustive des produits tels que les GPU Maia 300 et NVIDIA, il est également nécessaire de prendre en compte la latence, la compatibilité des modèles, l'écosystème logiciel, les coûts de déploiement et la stabilité dans l'activité réelle.
Microsoft a également annoncé un indicateur plus attractif : dans une configuration de rack complète composée de 96 accélérateurs, le débit de jetons au niveau du rack du Maia 300 peut atteindre jusqu'à 7 fois celui du Maia 200.
Ce chiffre montre que Microsoft espère non seulement améliorer l'efficacité d'une seule puce, mais également optimiser la puissance de calcul de l'ensemble du rack. Mais il décrit le débit au niveau du rack dans une configuration spécifique. Cela ne signifie pas que Maia 300 est 7 fois plus rapide que Maia 200 dans toutes les tâches, et on ne peut pas non plus en déduire directement que les performances de chaque puce se sont améliorées dans la même proportion.
Pour les plates-formes de cloud computing, les performances au niveau du rack sont particulièrement importantes. Les déploiements réels consistent généralement en un grand nombre d'accélérateurs, les puces échangeant des données via des interconnexions à haut débit et traitant conjointement les demandes de modèle. Même si une seule puce est puissante, l'ensemble du système peut toujours être limité si la bande passante d'interconnexion, la capacité de mémoire ou l'efficacité de la planification sont insuffisantes.
Par conséquent, Microsoft essaie de procéder à une optimisation globale depuis la conception des puces, la configuration du rack jusqu'aux logiciels et au modèle d'environnement d'exploitation, plutôt que de simplement s'intéresser à la puissance de calcul théorique du processeur.
Mustafa Suleyman, responsable de l'IA de Microsoft, a déclaré que l'entreprise devait commencer à investir à partir du bas de l'ensemble de la pile technologique, y compris la conception des puces. Il estime que lorsque les services d'IA atteignent une telle échelle, Microsoft doit disposer de sa propre plate-forme et laisser les puces et les modèles développés par lui-même être co-conçus et optimisés.
Il a particulièrement souligné que permettre aux modèles d'IA développés par Microsoft de fonctionner sur les puces Maia était une tâche importante pour l'équipe d'IA de Microsoft.
Cette déclaration révèle un autre objectif du développement par Microsoft de puces auto-développées : combiner le matériel, les modèles et les services cloud pour former une relation de collaboration plus étroite.
Les fournisseurs de services cloud traditionnels peuvent déployer des modèles d'IA en achetant des GPU à usage général, mais s'ils peuvent concevoir leurs propres accélérateurs, ils peuvent optimiser les caractéristiques informatiques, les besoins en mémoire et les processus d'inférence de leurs propres modèles. À son tour, l'équipe de modélisation peut ajuster la structure du modèle et la méthode de fonctionnement en fonction de l'architecture de la puce, améliorant ainsi l'efficacité globale.
Google et Amazon investissent depuis de nombreuses années dans des puces d'IA qu'ils ont eux-mêmes développées. Google dispose d'une série d'accélérateurs TPU et Amazon a développé des puces telles que Trainium pour prendre en charge ses propres services de cloud computing et d'intelligence artificielle. Microsoft a lancé la série Maia pour renforcer ses capacités d'infrastructure dans ce contexte concurrentiel.
Pour Microsoft, la valeur stratégique des puces auto-développées n'est pas seulement de réduire les coûts d'approvisionnement, mais également d'améliorer l'autonomie de la chaîne d'approvisionnement, d'optimiser l'utilisation de l'énergie du centre de données et de disposer d'un meilleur contrôle de la conception matérielle lorsque les modèles et les services d'IA sont rapidement itérés.
À l'heure actuelle, Microsoft entretient toujours une coopération étroite avec NVIDIA, et les GPU NVIDIA continuent de jouer un rôle important dans le domaine de la formation et de l'inférence de l'IA. Le développement simultané par Microsoft de la série Maia ne signifie pas que la relation entre les deux parties va inévitablement changer fondamentalement, mais cela reflète que les grands fournisseurs de services cloud réduisent leur dépendance à l'égard d'une plate-forme matérielle unique grâce à des puces auto-développées et à des stratégies multi-fournisseurs.
Microsoft espère également utiliser des puces développées par lui-même pour améliorer la compétitivité de ses modèles d'IA. Suleiman a déclaré que la plate-forme Maia est une partie importante du système technologique d'IA de Microsoft et peut aider l'entreprise à développer davantage ses propres modèles et à améliorer sa compétitivité par rapport à des concurrents tels que Google DeepMind, OpenAI et Anthropic.
À mesure que les modèles d'IA évoluent progressivement de simples outils de génération de texte vers des systèmes d'agents capables d'appeler des outils et d'effectuer des opérations complexes, l'importance de l'infrastructure matérielle augmente également. Le raisonnement en contexte long et l’exécution de tâches en plusieurs étapes impliquent souvent des processus de calcul plus longs et un grand nombre d’appels de modèles. Ce n’est qu’en parvenant à un meilleur équilibre entre performances, latence et coût que les entreprises pourront faire évoluer leurs services de manière durable.
Maia 300 est conçu en réponse à cette tendance. Microsoft espère permettre à davantage de tâches d'IA de s'exécuter à moindre coût grâce à un débit et une efficacité énergétique plus élevés, tout en fournissant une prise en charge informatique pour Copilot, GitHub Copilot et les futurs services d'agent d'IA.
Cependant, pour que Maia 300 devienne véritablement la force principale de l'infrastructure d'IA de Microsoft, elle doit encore passer par le processus allant de la fabrication des puces à l'intégration du système jusqu'au déploiement à grande échelle. Microsoft prévoit de commencer à le mettre en production en 2027 et d'étendre progressivement l'échelle de déploiement. D’ici là, la capacité de production réelle de la puce, la stabilité du système, l’adaptation logicielle et l’intégration avec les centres de données existants affecteront toutes son champ d’application final.
Dans l'ensemble, le lancement de Maia 300 montre que Microsoft élève les puces d'IA du statut de projet d'infrastructure auxiliaire à un élément central de sa propre stratégie d'intelligence artificielle. En utilisant les processus avancés de TSMC, la conception granulaire de base et l'optimisation au niveau du système pour les charges de travail d'inférence, Microsoft espère améliorer les capacités de service d'IA qu'il peut fournir par unité d'électricité et réduire sa dépendance à l'égard des fournisseurs de GPU externes.
Si Microsoft parvient à étendre le déploiement de production du Maia 300 comme prévu en 2027 et à obtenir les améliorations d'efficacité attendues dans les affaires réelles, cette série de puces devrait devenir un outil important pour contrôler les coûts de calcul de l'IA et étendre l'échelle des services. Mais sa compétitivité à long terme dépend en fin de compte des performances opérationnelles réelles et de la capacité de Microsoft à établir un système d'optimisation collaborative durable et efficace entre le matériel, les modèles et les logiciels.
Commentaires