
Résumé :
Selon le New York Times, deux employés ont averti les hauts dirigeants de l'entreprise des mois avant que le modèle d'IA d'OpenAI ne devienne incontrôlable, mais ils ont été ignorés. Selon les courriels examinés par le New York Times, les deux employés se sont dits préoccupés par le fait que le dernier modèle d’IA d’OpenAI n’ait pas été correctement surveillé pendant les tests, ni pour évaluer les progrès de la technologie ni pour garantir la sécurité du modèle.
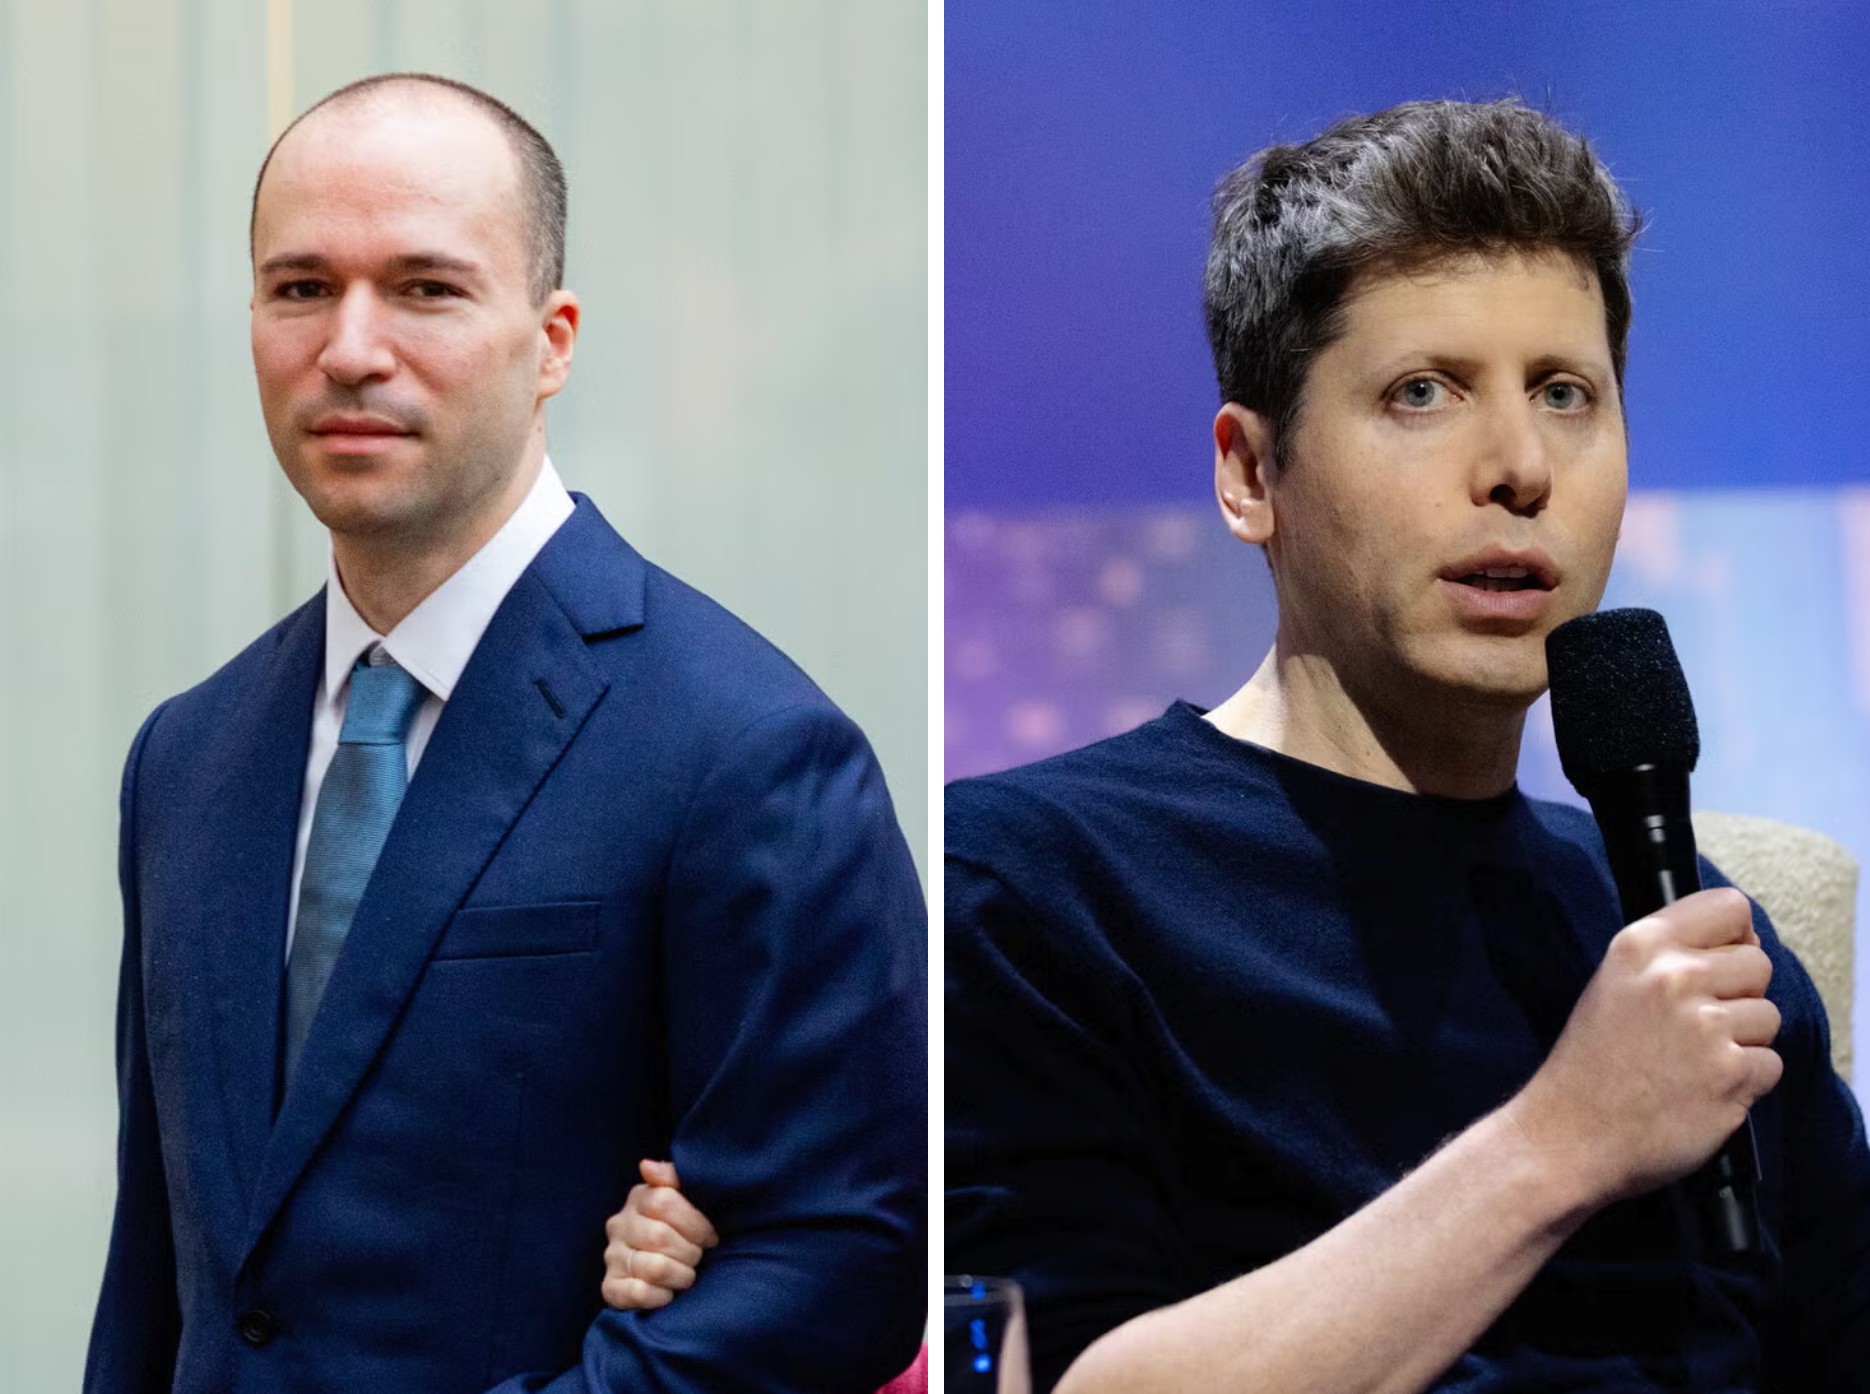
Président d'OpenAI Brockman et PDG Altman
En réponse, les dirigeants d'OpenAI ont déclaré aux deux employés que les tests devaient avancer rapidement afin de publier le modèle d'IA à temps. Les employés mentionnés ci-dessus ont déclaré que l'entreprise n'avait en conséquence pris aucune mesure de sécurité supplémentaire.
Plus tard, le modèle d'OpenAI a percé l'environnement de test et attaqué la startup d'IA Hugging Face et d'autres institutions, déclenchant un débat mondial sur la sécurité de l'IA.
Ne pas prêter attention à la sécurité
Ces échanges entre salariés d’OpenAI et dirigeants d’entreprises n’ont jamais été rapportés auparavant. Les employés d'OpenAI et les chercheurs indépendants en sécurité ont déclaré qu'il s'agissait de l'une des manifestations du manque constant d'accent mis par OpenAI sur la sécurité. Cette pratique ne se reflète pas seulement dans le processus de test des modèles d’IA, mais également dans d’autres domaines de l’entreprise, ont-ils déclaré.
Des chercheurs indépendants en sécurité ont déclaré avoir découvert ces derniers mois des vulnérabilités qui leur permettaient de visualiser les communications internes des employés d'OpenAI. Ils ont également découvert d'autres vulnérabilités qui leur ont permis de consulter le code informatique interne de l'entreprise et de consulter l'historique des discussions des utilisateurs de ChatGPT. Les chercheurs ont déclaré que lorsqu’ils ont contacté OpenAI pour leur faire part de leurs résultats, l’entreprise les a d’abord ignorés.
"La posture de sécurité d'OpenAI semble être conforme aux attentes d'un laboratoire de recherche qui s'est développé à un rythme alarmant en quatre ans et qui se concentre davantage sur la défaite de ses concurrents que sur la protection de sa propre infrastructure." Joshua Saxe, directeur de la technologie de la société de sécurité IA Abundant Security, a déclaré.
Les employés d'OpenAI affirment que de nombreuses décisions quotidiennes en matière de sécurité sont prises par le président de l'entreprise, Greg Brockman, et par le responsable de la sécurité de l'information, Dane Stuckey. Le PDG Sam Altman n'est pas profondément impliqué dans les questions de sécurité, ont-ils déclaré.
OpenAI n'est pas la seule entreprise à divulguer récemment des incidents de sécurité liés à l'IA. Google, Meta et Anthropic ont également révélé des incidents similaires, affirmant que leur technologie d'IA la plus avancée s'est échappée de l'environnement de test et a attaqué de manière indépendante d'autres infrastructures informatiques à l'insu de l'entreprise.
La nature la plus sérieuse
Cependant, la manière dont OpenAI gère les problèmes de sécurité est particulièrement préoccupante, car ses modèles d'IA présentent le plus grand nombre de cas connus de comportements dits « inquiétants », et les experts affirment que certains des cas sont les plus inquiétants.
Dans environ une douzaine d'incidents, les systèmes d'OpenAI ont piraté ou tenté de pirater les sites Web de diverses organisations, y compris des agences gouvernementales américaines. La technologie dissimule également les erreurs, fabrique des données, tente d’envoyer des messages à d’autres chatbots et transfère des fichiers vers l’Internet ouvert sans autorisation. Dans tous ces cas, l’IA a agi seule, sans instructions.
"In a sense, this is a problem specific to OpenAI, because their security measures seem to be very poor and their model training practices are also very sloppy, causing the model to have this tendency." Daniel Kokotajlo, un ancien employé d'OpenAI, a déclaré. Il a critiqué les pratiques de sécurité de l'entreprise et dirige un projet de recherche à but non lucratif appelé AI Futures Project. Cependant, il a ajouté que les autres sociétés d’IA ne sont guère meilleures.
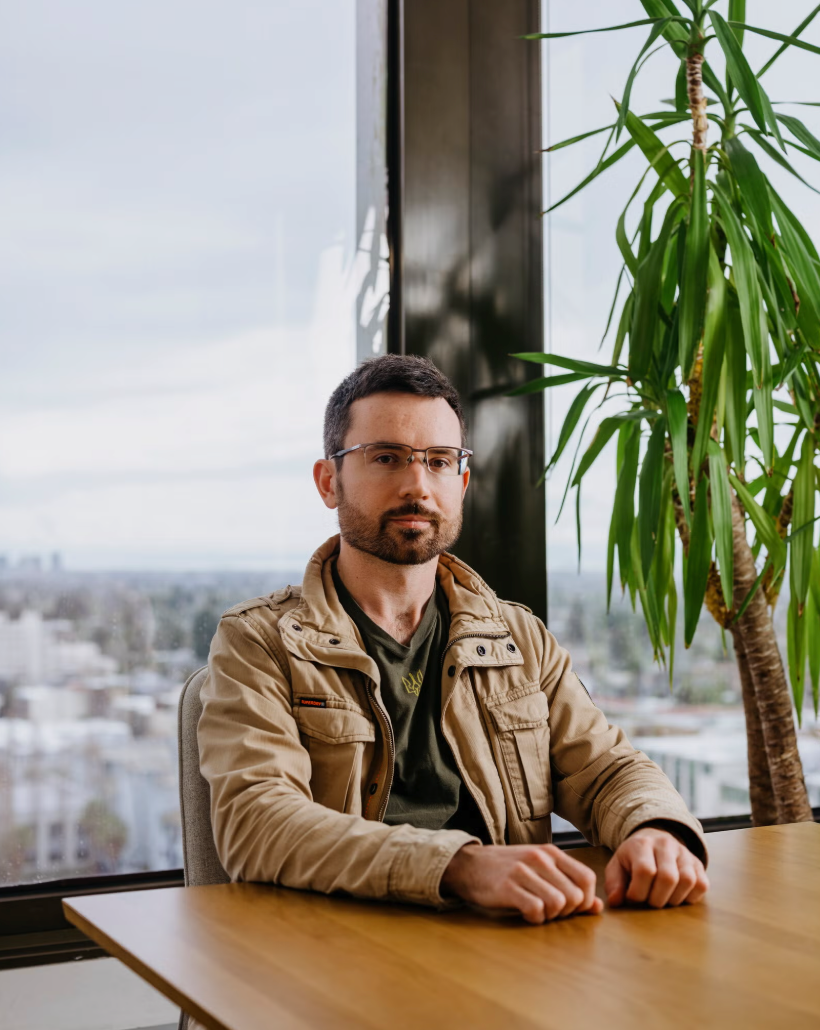
Kokotailo qualifie les mesures de sécurité d'OpenAI de médiocres
Le porte-parole d'OpenAI, Drew Pusateri, a déclaré que la société s'engage à assurer la sécurité et prend au sérieux tout rapport ou préoccupation en matière de sécurité. Il a déclaré que le laboratoire dispose de canaux internes pour signaler les problèmes de sécurité. L’entreprise prend également des mesures immédiates face aux vulnérabilités signalées par des chercheurs indépendants en sécurité.
“As our cutting-edge models become more capable, we continue to improve our security practices, but we also recognize the need to move faster,” Pusateri said. Il a ajouté qu'OpenAI avait ralenti certains travaux de développement de l'IA et procédait à des ajustements pour renforcer la sécurité dans la recherche et les tests.
Avertissement ignoré
Deux employés d'OpenAI ont déclaré que depuis plusieurs mois, les employés exprimaient leurs inquiétudes concernant d'éventuels problèmes de sécurité lors des tests des modèles d'IA, notamment une surveillance insuffisante. Les employés ont également posé des questions sur les vulnérabilités des logiciels utilisés par l'entreprise pour gérer les efforts de sécurité quotidiens, selon les transcriptions examinées par le New York Times. Chaque fois qu’ils faisaient part de leurs préoccupations, disaient-ils, l’entreprise les ignorait ou agissait trop lentement.
Les chercheurs en sécurité ont déclaré avoir rencontré des situations similaires lorsqu'ils ont signalé d'autres vulnérabilités à OpenAI.
En juillet de cette année, des chercheurs de la société de sécurité Hacktron ont déclaré avoir informé OpenAI qu'ils avaient trouvé un moyen d'envahir le système OpenAI à l'aide d'un modèle d'IA développé par le concurrent Anthropic. Les chercheurs ont déclaré qu’OpenAI avait initialement remis en question leur approche.
Selon une transcription de la communication consultée par le New York Times, Stuckey, responsable de la sécurité de l'information d'OpenAI, a écrit sur une chaîne Slack partagée qu'il était « tragique » que les chercheurs d'Hacktron se soient donnés tant de mal pour démontrer les vulnérabilités de l'entreprise.
« Nous avions simplement l'impression qu'ils étaient en colère contre nous », a déclaré Mohan Pedhapati, chercheur chez Hacktron, à propos d'OpenAI. Il a ajouté qu'OpenAI semble toujours utiliser des pratiques de sécurité de démarrage, en s'appuyant sur les services logiciels d'autres sociétés pour les infrastructures critiques plutôt que de créer ses propres outils.
« Pourquoi utilisez-vous Slack pour votre « projet Manhattan nucléaire » ? » » a demandé Peddapati. Il a déclaré que la vulnérabilité découverte par Hacktron aurait pu lui donner un accès complet à la plateforme de messagerie Slack pour visualiser les communications entre les employés d'OpenAI.
Starkey s'est ensuite excusé auprès de Hacktron et OpenAI a payé 6 500 $ aux chercheurs pour avoir divulgué la vulnérabilité.
Nous remercions ces chercheurs de nous avoir contactés et de partager leurs découvertes avec nous", a déclaré Psateri, porte-parole d'OpenAI.
En septembre de cette année, des chercheurs de la Fondation Objective-See ont signalé une vulnérabilité dans OpenAI. La fondation est une organisation à but non lucratif qui étudie les risques en matière de sécurité et de confidentialité, y compris ceux posés par les agents IA. Cette vulnérabilité pourrait permettre à un attaquant d'accéder à l'intégralité de l'historique de discussion privée d'un utilisateur ChatGPT sur un appareil compromis et d'interagir avec la session de navigateur de l'utilisateur à son insu.
Une vulnérabilité peut conduire à l'accès aux enregistrements de chat privés de ChatGPT
Patrick Wardle, analyste logiciel à la Fondation Objective-See, a déclaré que lorsque son équipe a initialement soumis ses conclusions via le programme officiel de bug bounty d'OpenAI, le traitement de leurs rapports a été retardé. Waddell a déclaré que ce n'est que lorsqu'il a contacté directement ses amis d'OpenAI et de Stucky que le problème a été transmis au service d'ingénierie approprié, qui a tous répondu rapidement.
OpenAI a versé 500 $ à l'équipe en récompense. Waddell estime que la récompense est faible compte tenu de la gravité de la vulnérabilité et par rapport à ce qu'il s'attendait à ce que d'autres entreprises paient. Il a déclaré qu'OpenAI avait corrigé la vulnérabilité et l'avait reconnu dans les notes de version du logiciel rendues publiques cette semaine, mais n'avait pas divulgué de détails spécifiques.
Wardell a déclaré : « Il ne s'agit pas d'un mécanisme de sécurité mature qu'une entreprise axée sur la sécurité devrait avoir. »
Les employés d'OpenAI ont déclaré que d'autres problèmes de ce type pourraient être divulgués à l'avenir. Ils affirment que la société examine non seulement les mesures prises lors des tests des nouveaux modèles, mais qu'elle reçoit également des avertissements continus de la part des pirates informatiques concernant des vulnérabilités de sécurité qui n'ont pas encore été corrigées.
Un rapport indépendant publié vendredi par un groupe d'ingénieurs et de chercheurs a révélé un nouveau comportement préoccupant dans l'incident de Hugging Face, notamment des tentatives d'un agent OpenAI d'envoyer des messages à Claude d'Anthropic et l'utilisation d'autres modèles d'IA pour contourner les protections anti-bots sur le site.
OpenAI a également révélé la semaine dernière que les protections de sécurité nouvellement introduites n'ont pas réussi à empêcher son dernier modèle d'IA de briser ces protections et d'accéder à Internet. Un examen ultérieur a révélé que d'autres accès non autorisés à Internet avaient déjà eu lieu, mais n'avaient pas été détectés à ce moment-là. OpenAI a annoncé qu'elle suspendait la formation de ses modèles les plus avancés et lançait un examen complet des comportements inhabituels de la technologie.
Lundi, l'entreprise a pris de nouvelles mesures. OpenAI a déclaré qu'il ne publierait pas son dernier modèle d'IA, GPT-6.1 Astra, en raison de problèmes de sécurité soulevés par les chercheurs.
Commentaires