
Résumé :
La PlayStation 5 de Sony a été conçue à l'origine comme une console de jeux vidéo, mais un projet de développement open source tente de trouver une autre utilisation à cet appareil de jeu : exécuter de grands modèles de langage d'intelligence artificielle locale. En éliminant les limitations du système de la PS5, les développeurs ont transplanté le moteur d'inférence open source llama.cpp sur la console et ont ensuite utilisé son GPU pour exécuter de grands modèles. La dernière démonstration montre qu'une PS5 ordinaire crackée peut déjà exécuter le modèle Qwen 3.8 avec 27 milliards de paramètres. Grâce à la quantification à bits faibles, la vitesse de génération de texte atteint environ 20 jetons par seconde.
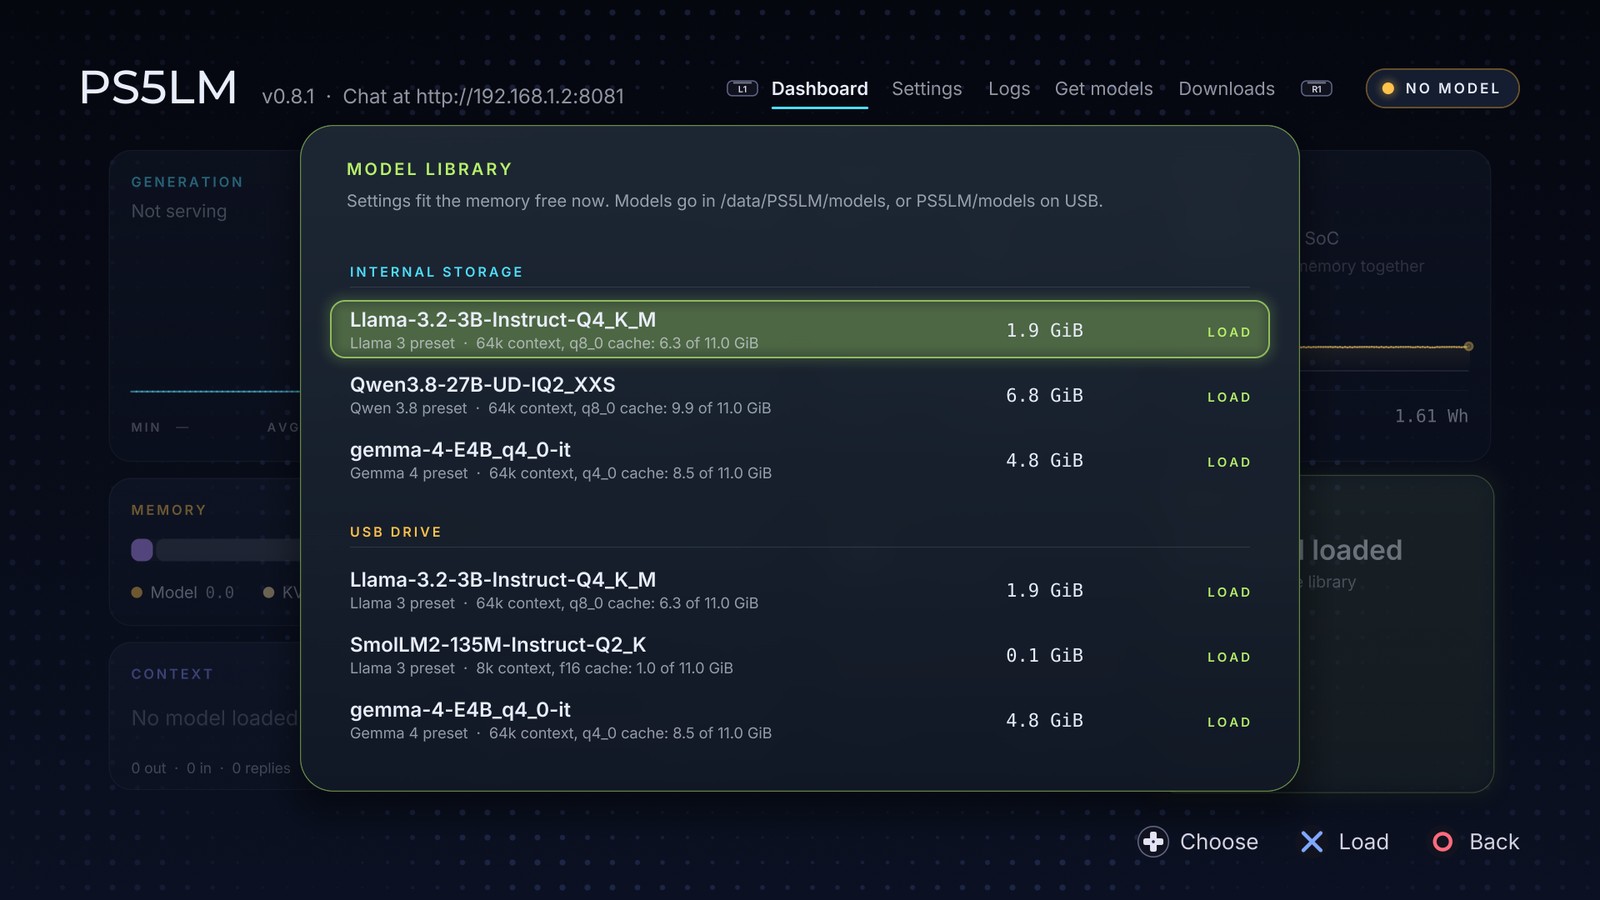
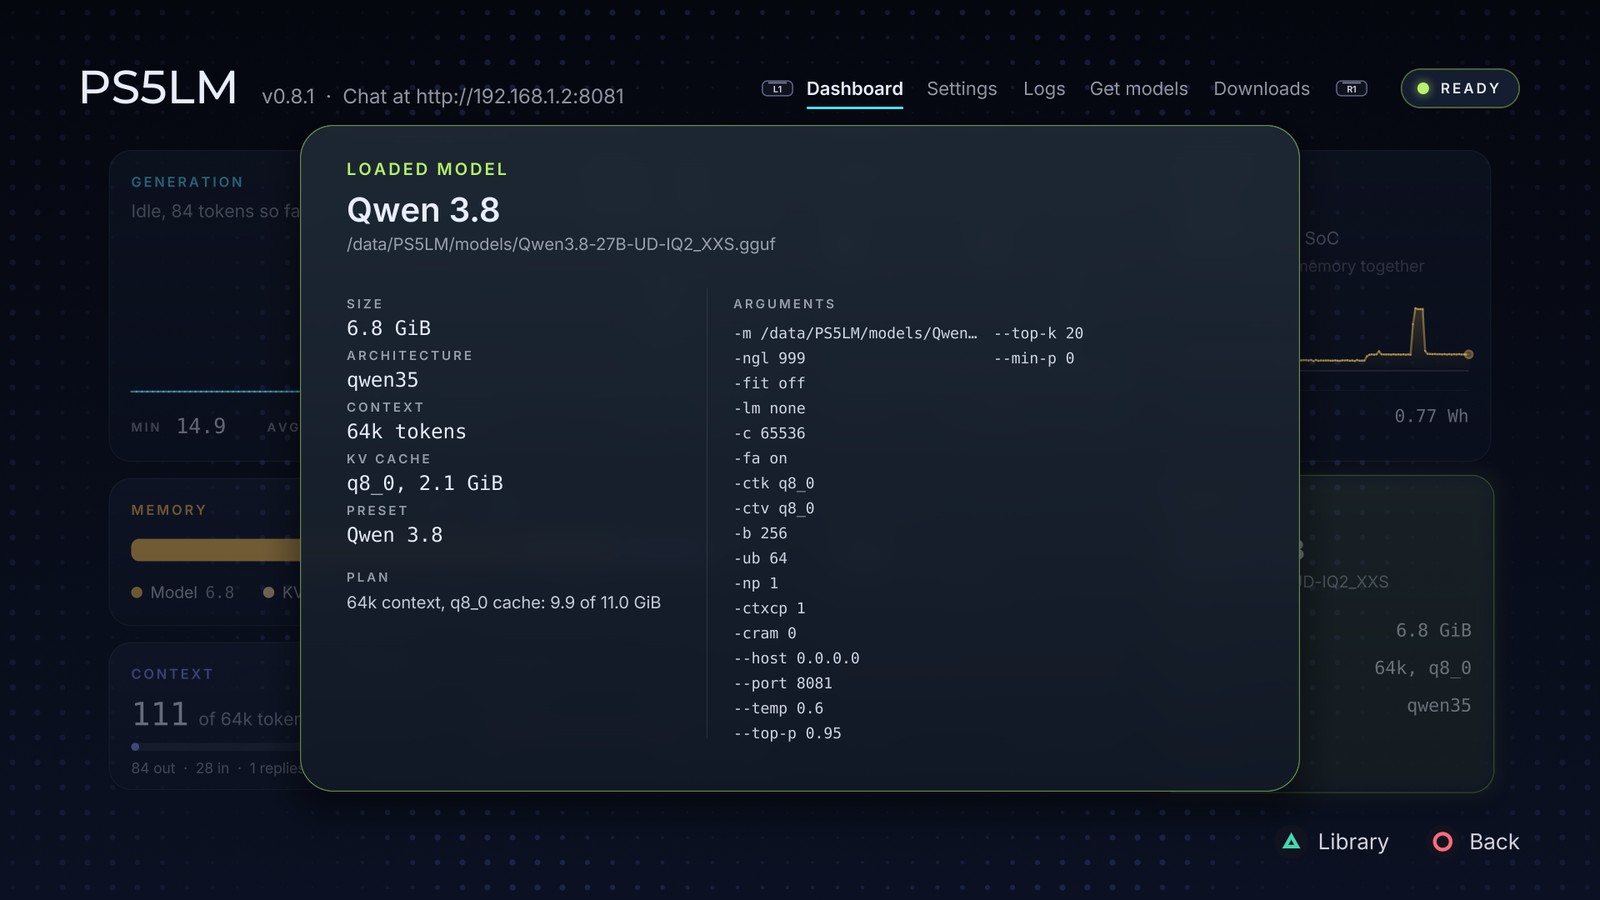
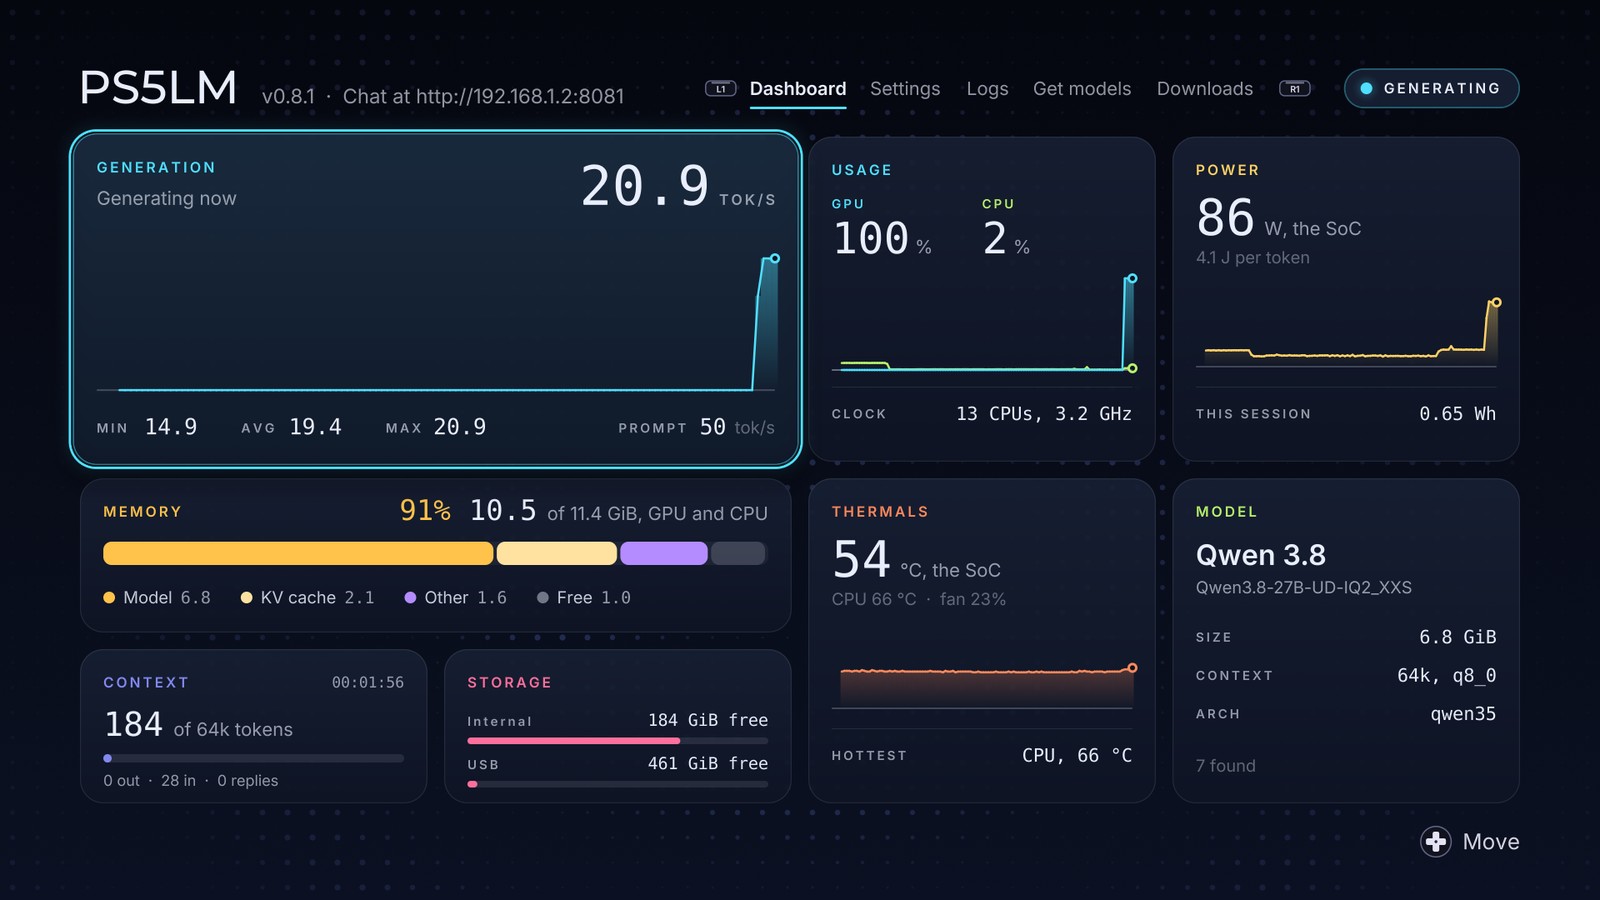
Cela signifie qu'un hôte initialement utilisé pour exécuter des jeux peut également agir comme un grand serveur local de modèles de langage sans recourir aux services d'IA cloud. Les utilisateurs peuvent accéder aux services sur l'hôte via un ordinateur ou un téléphone mobile dans le même réseau local et parler au modèle. Cependant, il ne s'agit pas d'une fonctionnalité officiellement fournie par Sony, mais d'une application expérimentale qui s'appuie sur les vulnérabilités du système, des logiciels non officiels et les résultats du développement de la communauté.
Le projet s'appelle PS5LM et a été initié par le développeur GitHub cobanov. L'idée principale du projet n'est pas d'écrire un nouveau cadre de raisonnement d'intelligence artificielle à partir de zéro, mais de transplanter l'outil open source llama.cpp, largement utilisé pour exécuter de grands modèles locaux, sur la plate-forme PS5, puis de résoudre progressivement les problèmes de compatibilité du système d'exploitation hôte, de l'allocation de mémoire et de l'interface de calcul GPU.
La PS5 utilise le processeur personnalisé d'AMD. Le processeur utilise l'architecture Zen 2 et dispose de 8 cœurs ; le GPU est basé sur l'architecture AMD RDNA. L'hôte est équipé de 16 Go de mémoire unifiée GDDR6, et le CPU et le GPU doivent partager ces ressources. Bien que la PS5 ne soit pas un appareil spécifiquement conçu pour l’inférence de l’intelligence artificielle, son GPU et sa mémoire vidéo à large bande passante constituent la base matérielle pour exécuter des modèles de langue locale.
La PS5LM a initialement adopté un mode de fonctionnement relativement simple, permettant au modèle de langage d'effectuer des inférences via le processeur hôte et d'utiliser le propre navigateur de la PS5 pour fournir une interface de discussion. Les utilisateurs peuvent télécharger le modèle sur l'hôte, saisir des questions via le contrôleur DualSense et le clavier à l'écran, puis afficher les réponses générées par le modèle.
Cette première version a démontré la capacité de la PS5 à exécuter de grands modèles de langage, mais s'est rapidement heurtée à des limitations de performances et de mémoire. Étant donné que le programme s'exécute sous la forme d'une charge utile, la mémoire pouvant être utilisée est limitée par l'environnement système. Au départ, seuls les modèles plus petits peuvent fonctionner de manière stable. Les documents du projet montrent que la première version prend principalement en charge des modèles avec des tailles de paramètres d'environ 0,8B et 2B, la vitesse de génération du modèle 2B étant d'environ 9 jetons par seconde.
Pour les développeurs qui souhaitent exécuter des modèles plus grands sur PS5, laisser simplement le programme s'exécuter sur le processeur ne suffit pas. Pour utiliser pleinement les performances matérielles de l'hôte, le moteur d'inférence doit être capable d'appeler le GPU et d'obtenir suffisamment d'espace mémoire pour stocker les paramètres du modèle, le cache et d'autres données en cours d'exécution.
La véritable avancée vient de l'accélération GPU. Les développeurs ont en outre implémenté un environnement d'exécution d'applications natif sur PS5, et grâce au pilote graphique et à l'interface informatique Vulkan développés par la communauté, lama.cpp peut appeler le GPU hôte pour effectuer des calculs de réseau neuronal. Par rapport à la solution précédente qui ne pouvait s'appuyer que sur le processeur, ce changement améliore non seulement la vitesse d'inférence, mais permet également au programme d'obtenir plus de mémoire disponible pour essayer d'exécuter des modèles plus grands.
Lors de la dernière démonstration, la PS5 a exécuté avec succès le modèle Qwen 3.8 27B lancé par l'équipe Alibaba Tongyi Qianwen. Le modèle comporte 27 milliards de paramètres et utilise une architecture d’attention hybride. L'objectif de conception est de fournir de solides capacités de compréhension du langage, de raisonnement et de génération de code sur des ressources matérielles relativement limitées.
Cependant, la PS5 ne charge pas 27 milliards de paramètres directement en mémoire avec une précision totale. Afin d'adapter le modèle aux conditions matérielles de l'hôte, les développeurs ont utilisé une technologie de quantification low-bit pour compresser les paramètres du modèle dans un espace de stockage plus petit. La démonstration utilise des versions quantifiées telles que IQ2_XXS, et le fichier modèle fait environ plusieurs Go à 7 Go, et la taille spécifique dépend du schéma de quantification.
La quantification est une technologie clé dans l'exécution de grands modèles locaux. En règle générale, les paramètres du modèle sont stockés dans un format de données de plus grande précision, mais cela consomme beaucoup de mémoire. En compressant les paramètres dans des valeurs de largeur de bits inférieures, vous pouvez réduire considérablement les besoins en mémoire et réduire la quantité de données transférées pendant l'inférence. Le coût est la perte de certaines informations précises, ce qui peut affecter la qualité des réponses du modèle, sa capacité de raisonnement ou l'exécution de tâches spécifiques. Par conséquent, être capable d’exécuter un modèle de 27 milliards de paramètres ne signifie pas que la PS5 peut exécuter un modèle de même taille avec une précision totale.
Les données de test publiées par le développeur montrent que lors de l'utilisation du GPU pour effectuer une inférence, la vitesse de génération de texte de Qwen 3.8 27B peut atteindre environ 20 jetons par seconde. Le jeton est l'unité de base des grands modèles de langage permettant de traiter le texte. Ce n'est pas strictement équivalent à un caractère chinois ou à un mot anglais. Par conséquent, 20 jetons par seconde ne peuvent pas être simplement compris comme générant 20 caractères chinois par seconde. Pourtant, c'est assez rapide pour que les conversations interactives aient un certain sens pratique, plutôt que d'être simplement une démonstration technique pour prouver qu'un modèle peut décoller.
En plus du modèle Qwen, le même projet a également annoncé les résultats des tests d'autres modèles. Gemma 4 E4B génère environ 61 jetons par seconde, tandis que Llama 3.2 3B atteint environ 124 jetons par seconde. Les petits modèles ont moins de paramètres, nécessitent moins de calculs et de lectures de données et atteignent donc généralement des vitesses de génération plus élevées.
Ces résultats doivent toujours être considérés comme des résultats de tests publiés par les développeurs sous des configurations logicielles et matérielles spécifiques, plutôt que comme des références industrielles vérifiées par une plate-forme de test unifiée. Différents modèles ont différentes échelles de paramètres, méthodes de quantification, longueurs de contexte et tâches informatiques. Leurs capacités globales ne peuvent pas être jugées uniquement sur la base du nombre de jetons générés par seconde.
Le projet démontre également la possibilité de transformer la PS5 en un serveur LAN AI. En exécutant une interface de service compatible avec l'API OpenAI sur l'hôte, d'autres appareils peuvent envoyer des requêtes sur le même réseau et obtenir des réponses générées par le modèle. De cette façon, les utilisateurs n'ont pas toujours besoin de faire face à l'écran du téléviseur pour faire fonctionner la console, et peuvent également appeler le modèle local sur la PS5 via un ordinateur ou un téléphone portable.
Cette approche est intéressante pour les utilisateurs qui souhaitent déployer des services d'IA locaux dans leurs réseaux domestiques. Lorsque le modèle s'exécute localement, le contenu des conversations quotidiennes n'a en principe pas besoin d'être envoyé à des services d'IA cloud tiers, et les utilisateurs n'ont pas à payer de frais d'inférence cloud en fonction du nombre d'appels. Cependant, la protection réelle de la confidentialité dépend toujours du logiciel installé, de la configuration du réseau et du fait que l'appareil ait d'autres comportements de transmission de données. Le système ne peut pas être considéré comme absolument sûr simplement en « fonctionnant localement ».
Dans le même temps, le développement du PS5LM repose toujours sur une série de technologies non officielles. Les utilisateurs doivent disposer d’une PS5 capable d’exécuter le programme de craquage approprié et d’utiliser un micrologiciel système et des outils de chargement de charge utile compatibles. La plage de micrologiciels applicables répertoriée dans le document de projet est de 7h00 à 13h60, mais les fonctions spécifiques, les performances et la compatibilité peuvent varier en fonction du modèle d'hôte et de la version du logiciel.
Cracker la console ne signifie pas que tous les utilisateurs de PS5 peuvent installer directement le programme. La version commerciale ordinaire de la PS5 ne peut pas télécharger et exécuter la PS5LM via le PlayStation Store comme les jeux classiques. Les utilisateurs doivent d'abord résoudre des problèmes tels que les autorisations d'accès au système, le chargement de programmes non officiels et l'environnement d'exploitation, ce qui pose encore un certain seuil pour les utilisateurs qui ne sont pas familiers avec le piratage d'hôtes et le développement de logiciels.
En outre, la modification du système hôte peut entraîner des risques en matière de sécurité et de stabilité, peut également affecter l'utilisation des services en ligne et impliquer les conditions de service pertinentes de Sony. Les développeurs recommandent d'effectuer des recherches uniquement sur les appareils qu'ils possèdent ou qu'ils ont autorisés. Pour les utilisateurs de console qui l'utilisent principalement pour jouer normalement, en particulier ceux qui se connectent fréquemment au PlayStation Network, il n'est pas nécessaire de pirater imprudemment l'appareil juste pour exécuter l'IA locale.
D'un point de vue matériel, l'importance de cette expérience n'est pas seulement de permettre à la console de jeu de répondre à des questions. Cela illustre en outre que le GPU et la mémoire vidéo à haute vitesse installés dans les équipements de jeux grand public peuvent également effectuer une partie du travail normalement effectué par les équipements informatiques dédiés à l'IA après une adaptation logicielle appropriée.
L'inférence de modèles de langage volumineux est souvent affectée de manière significative par la capacité de mémoire et la bande passante. Lorsque le modèle génère du texte, il doit lire en permanence un grand nombre de paramètres et maintenir des caches contextuels. L'architecture de mémoire unifiée de la PS5 permet au CPU et au GPU de partager des ressources mémoire à haute vitesse, mais le système lui-même doit également en occuper une partie, de sorte que l'espace disponible pour les modèles est bien inférieur à la capacité nominale de 16 Go.
C'est pourquoi les développeurs doivent résoudre simultanément des problèmes tels que la quantification, la gestion de la mémoire et les interfaces informatiques GPU. Le simple fait de disposer d’un GPU suffisamment puissant ne garantit pas le bon fonctionnement d’un modèle ; si l'architecture du modèle est prise en charge, si le pilote peut effectuer les opérations de calcul requises et si le système peut fournir suffisamment de mémoire pour le programme d'inférence, tout cela affectera le résultat final.
Ce résultat fournit également une référence intéressante pour la sélection du matériel d'IA local. Traditionnellement, les utilisateurs souhaitant exécuter des modèles linguistiques plus volumineux à la maison devaient souvent acheter un ordinateur doté d'une carte graphique discrète et payer un supplément pour la capacité de mémoire et le coût global de la machine. La PS5 dispose déjà d'un GPU relativement puissant et d'une mémoire à haute vitesse, les développeurs espèrent donc prouver que le matériel de jeu existant peut également être réutilisé sans avoir à acheter une station de travail IA dédiée.
Mais cela ne signifie pas que la PS5 peut remplacer complètement les ordinateurs IA. Ses ressources matérielles sont encore limitées par des configurations fixes, l'encombrement du système et des environnements logiciels non officiels. Par rapport aux ordinateurs dotés d'une mémoire graphique plus grande, de pilotes matures et d'outils de développement riches, la PS5 nécessite un travail d'adaptation sous-jacent plus important pour exécuter de grands modèles, et les utilisateurs ne peuvent pas librement mettre à niveau la carte graphique ou étendre la mémoire graphique comme les ordinateurs IA ordinaires.
D'un point de vue pratique, ce type de projet est actuellement plus adapté aux passionnés de technologie, aux développeurs open source et aux utilisateurs intéressés par l'IA locale pour étudier le raisonnement modèle, le calcul GPU et les environnements d'exploitation embarqués. Pour les entreprises qui ont besoin d’exécuter de manière stable des services d’IA au niveau de la production, les serveurs GPU dédiés ou les ordinateurs optimisés par des piles logicielles matures sont encore plus adaptés.
Le développement de PS5LM reflète également une tendance dans l'écosystème de l'IA open source : les cadres d'inférence de modèles et les modèles de pondération ouverts ont progressivement abaissé le seuil d'exécution de l'intelligence artificielle, tandis que les développeurs de la communauté continuent d'essayer de porter ces outils sur différentes plates-formes matérielles. Dans le passé, les consoles de jeux étaient principalement considérées comme des appareils de divertissement fermés ; Aujourd’hui, grâce aux efforts des communautés de cracking et d’ingénierie inverse, ils sont également devenus des plateformes d’exploration du calcul GPU et des applications natives d’intelligence artificielle.
En général, il s'agit d'une tentative technique représentative permettant à une PS5 crackée d'exécuter un grand modèle de langage avec 27 milliards de paramètres à une vitesse d'environ 20 jetons par seconde. Il démontre l'utilisation potentielle du matériel des consoles de jeux et prouve également que grâce à l'adaptation logicielle et à la compression des modèles, des modèles de langage d'une certaine échelle peuvent être exécutés sur des appareils d'IA non traditionnels. Cependant, cette réalisation reste un projet communautaire qui s'appuie sur un environnement cracké, et il y a encore une distance considérable entre elle et les fonctions officielles que les utilisateurs ordinaires peuvent utiliser sans opérations compliquées.
Commentaires