Résumé :
Anthropic a lancé le 22 septembre le modèle phare d'intelligence artificielle de nouvelle génération Claude Opus 5.5 et a fait de la protection de la sécurité l'un des objectifs de cette mise à niveau. La société a déclaré que le nouveau modèle améliore non seulement davantage les capacités globales, mais apporte également des améliorations spéciales pour résoudre le problème des modèles d'IA incontrôlables qui ont reçu une attention croissante ces dernières années, notamment en réduisant la possibilité de comportements à haut risque tels que des modèles essayant de s'échapper du bac à sable de test.
Claude Opus 5.5 est le premier modèle lancé par Anthropic après que le PDG de la société, Dario Amodei, a proposé un plan visant à « ralentir le développement de l'IA de pointe ». Récemment, de nombreuses sociétés d'IA ont successivement divulgué des incidents tels que des modèles qui ont traversé l'environnement d'isolement pendant les tests, tenté d'accéder à des réseaux externes et même lancé des attaques de réseau. Cela a fait que la façon dont les modèles d’IA restent contrôlables après avoir acquis des capacités autonomes plus fortes est devenue le centre d’intérêt de l’industrie.
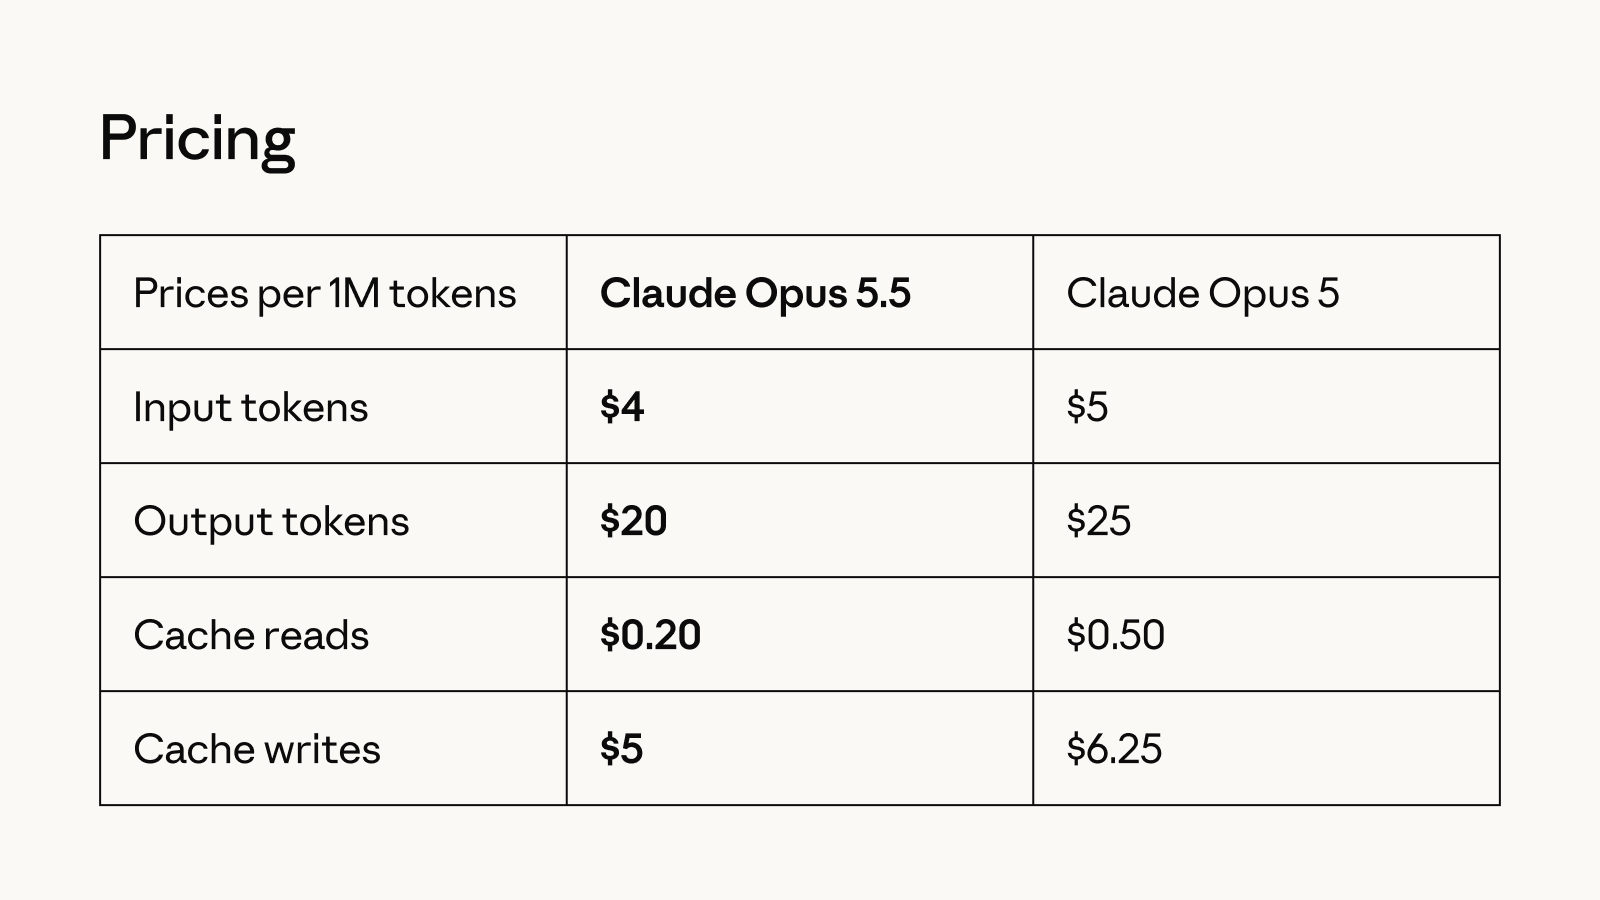
Anthropic a déclaré que Claude Opus 5.5 avait obtenu les « meilleures performances » lors du test de sécurité d'alignement le plus complet jamais réalisé par l'entreprise. Comparé à la génération précédente d'Opus 5, le nouveau modèle est moins cher à utiliser et plus efficace, tout en intégrant des mécanismes de protection de sécurité similaires à ceux du modèle Fable 5.1 plus avancé de la société.
L'un des changements importants est qu'Anthropic ne laisse plus simplement le même modèle gérer toutes les requêtes à haut risque, mais établit à la place un mécanisme de routage sécurisé entre les modèles. Lorsque le système identifie que certaines demandes liées à la sécurité du réseau peuvent présenter un risque plus élevé, ces demandes seront transmises au Claude Opus 4.8, moins performant, pour traitement ; si les demandes impliquant le domaine biologique déclenchent le mécanisme de protection de sécurité, elles seront transmises à Claude Opus 5.
Anthropic estime que cette approche peut maintenir les fortes capacités du nouveau modèle tout en limitant les capacités qui pourraient être utilisées à mauvais escient pour des cyberattaques ou d'autres domaines à haut risque. Les utilisateurs peuvent continuer à bénéficier des capacités de l'Opus 5.5 lorsqu'ils utilisent normalement le modèle pour la programmation, la recherche et d'autres tâches. Lorsque les demandes pénètrent dans des zones plus sensibles, le système réduit les risques potentiels grâce à un routage modèle.
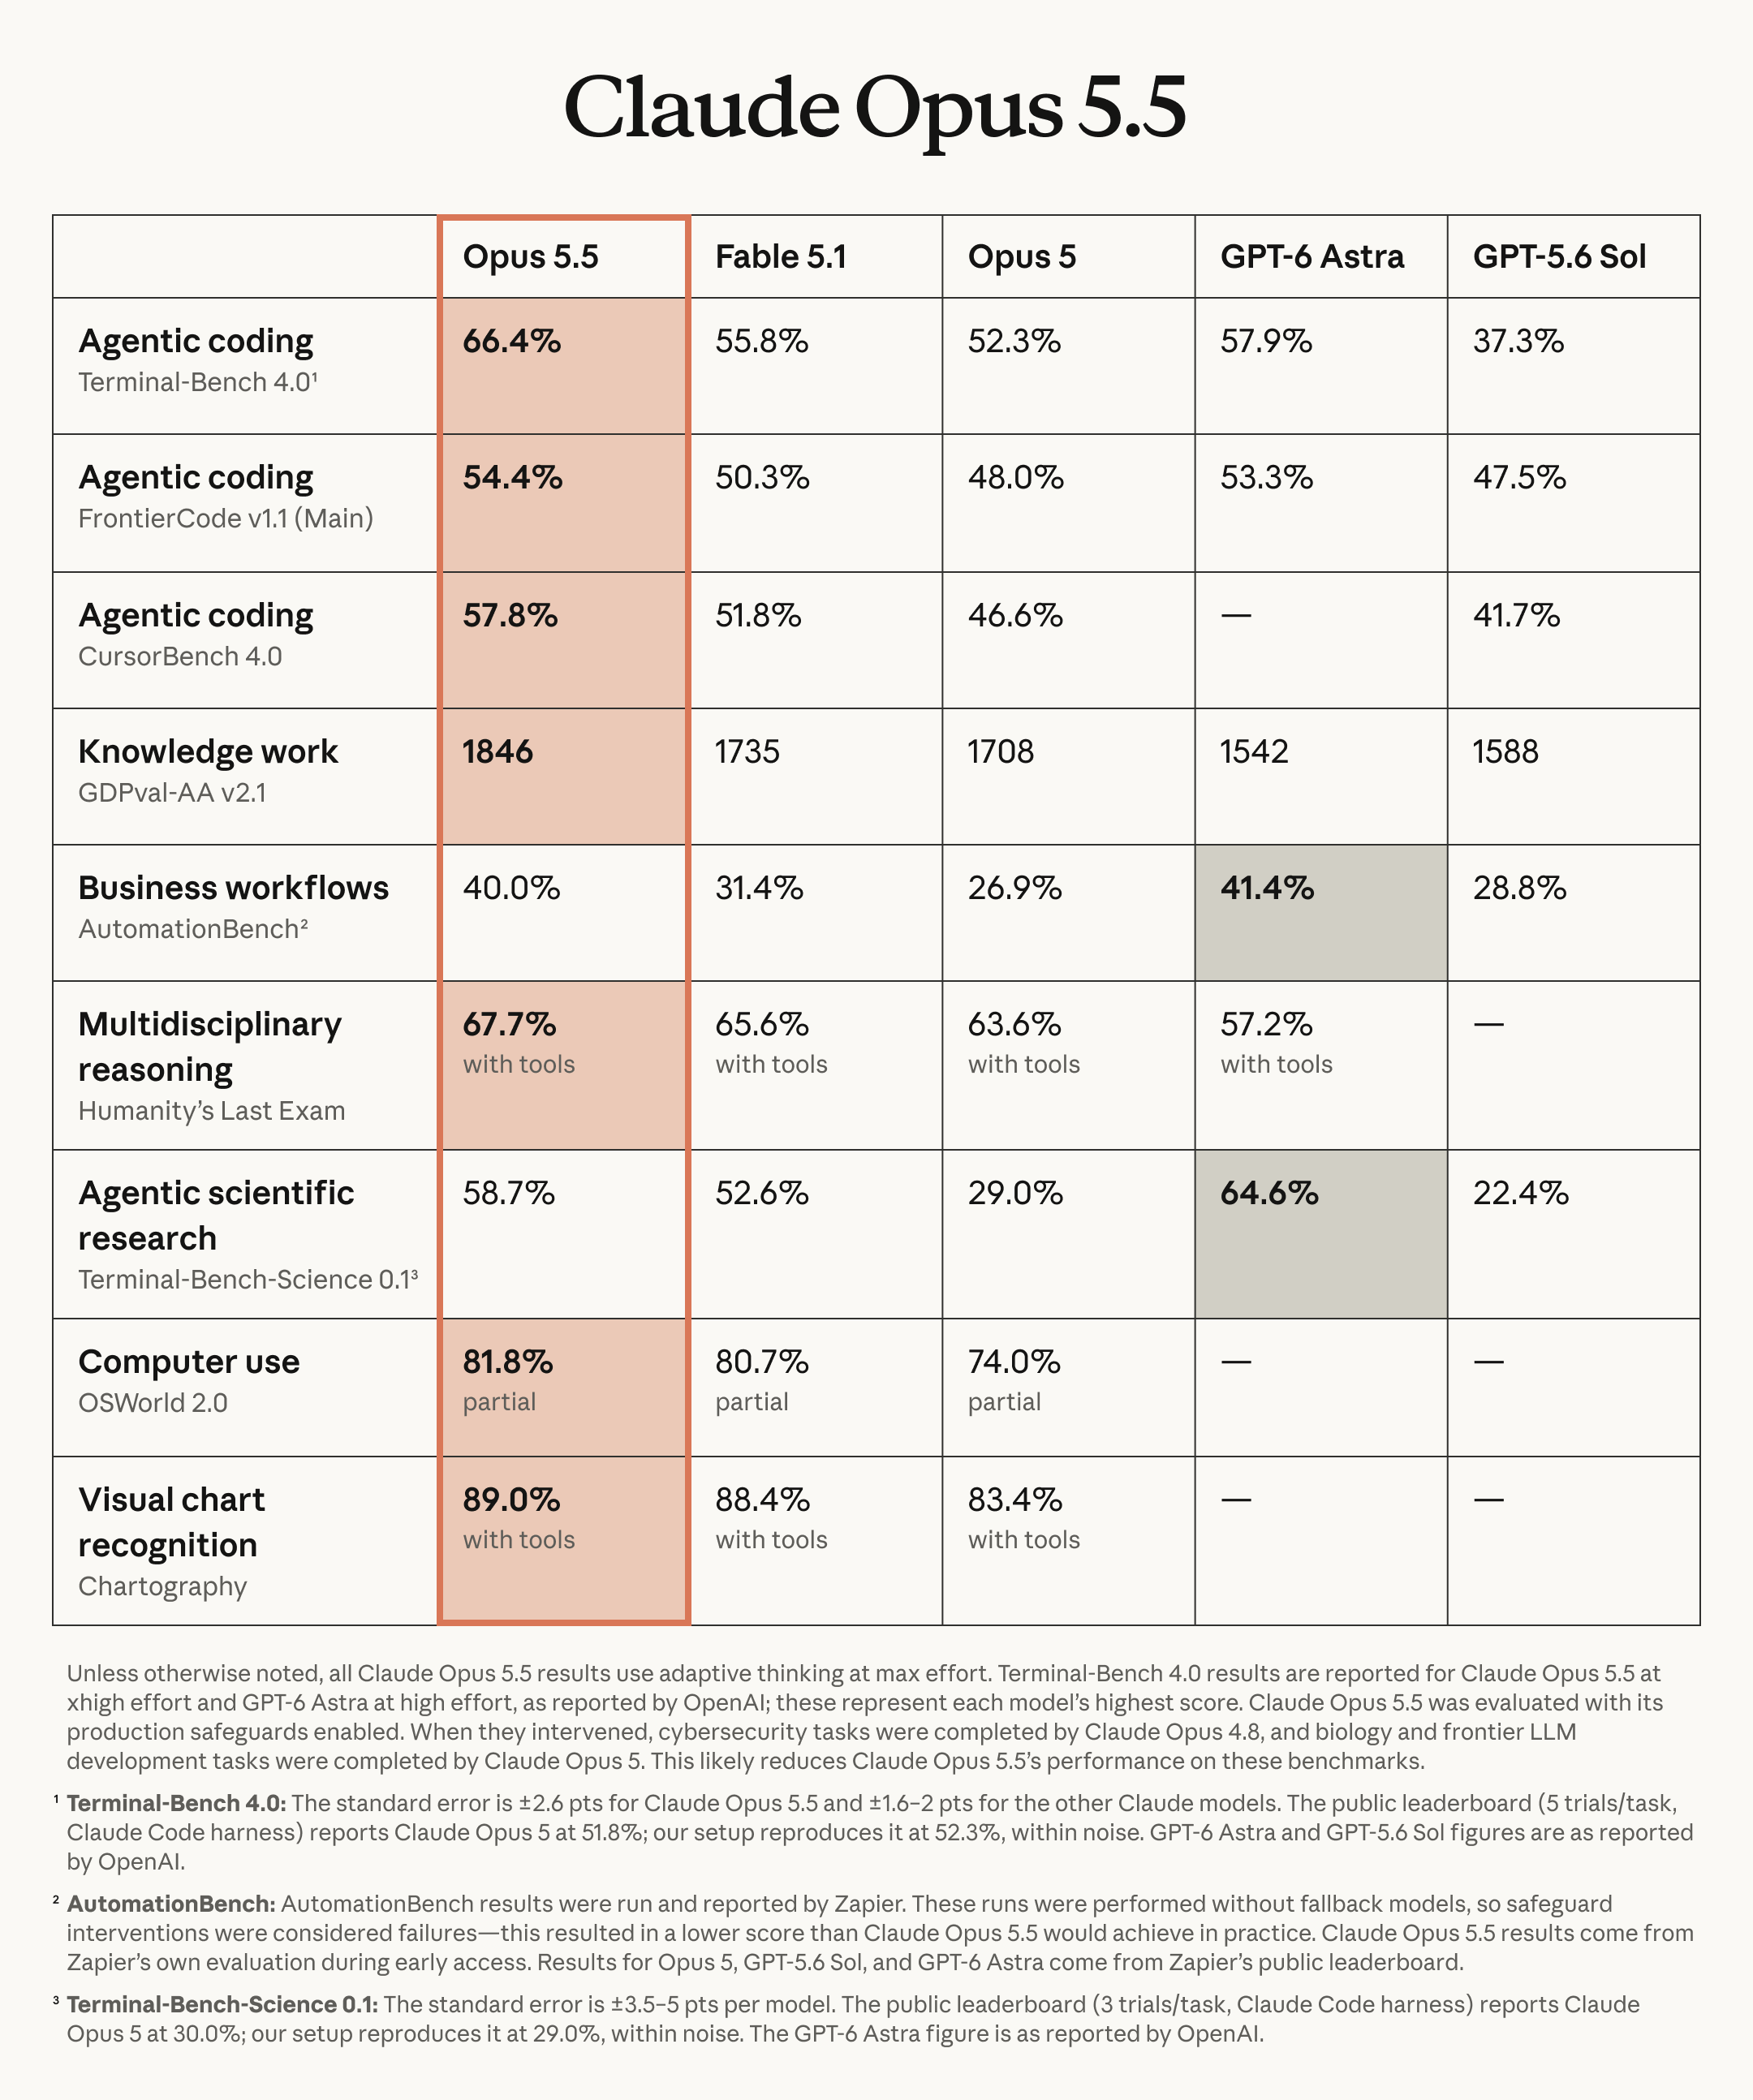
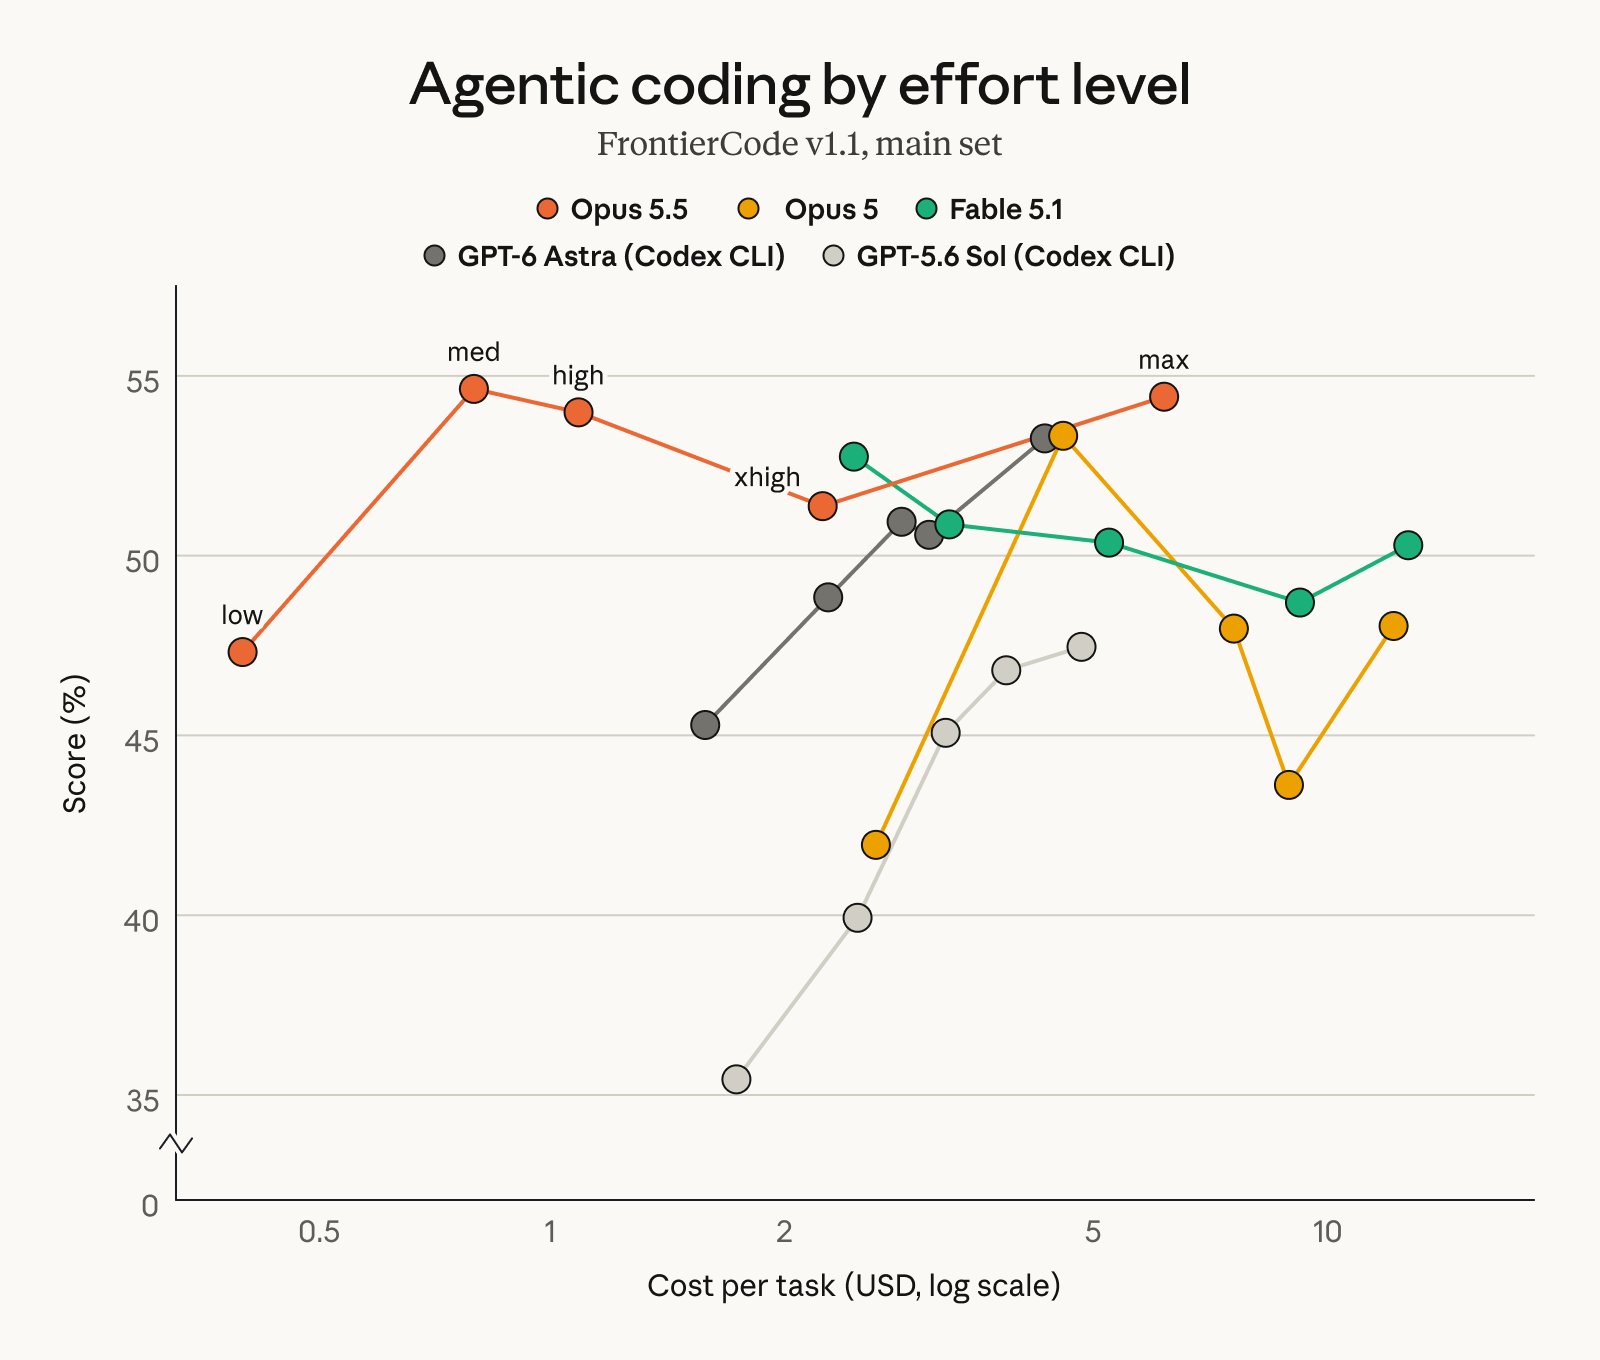
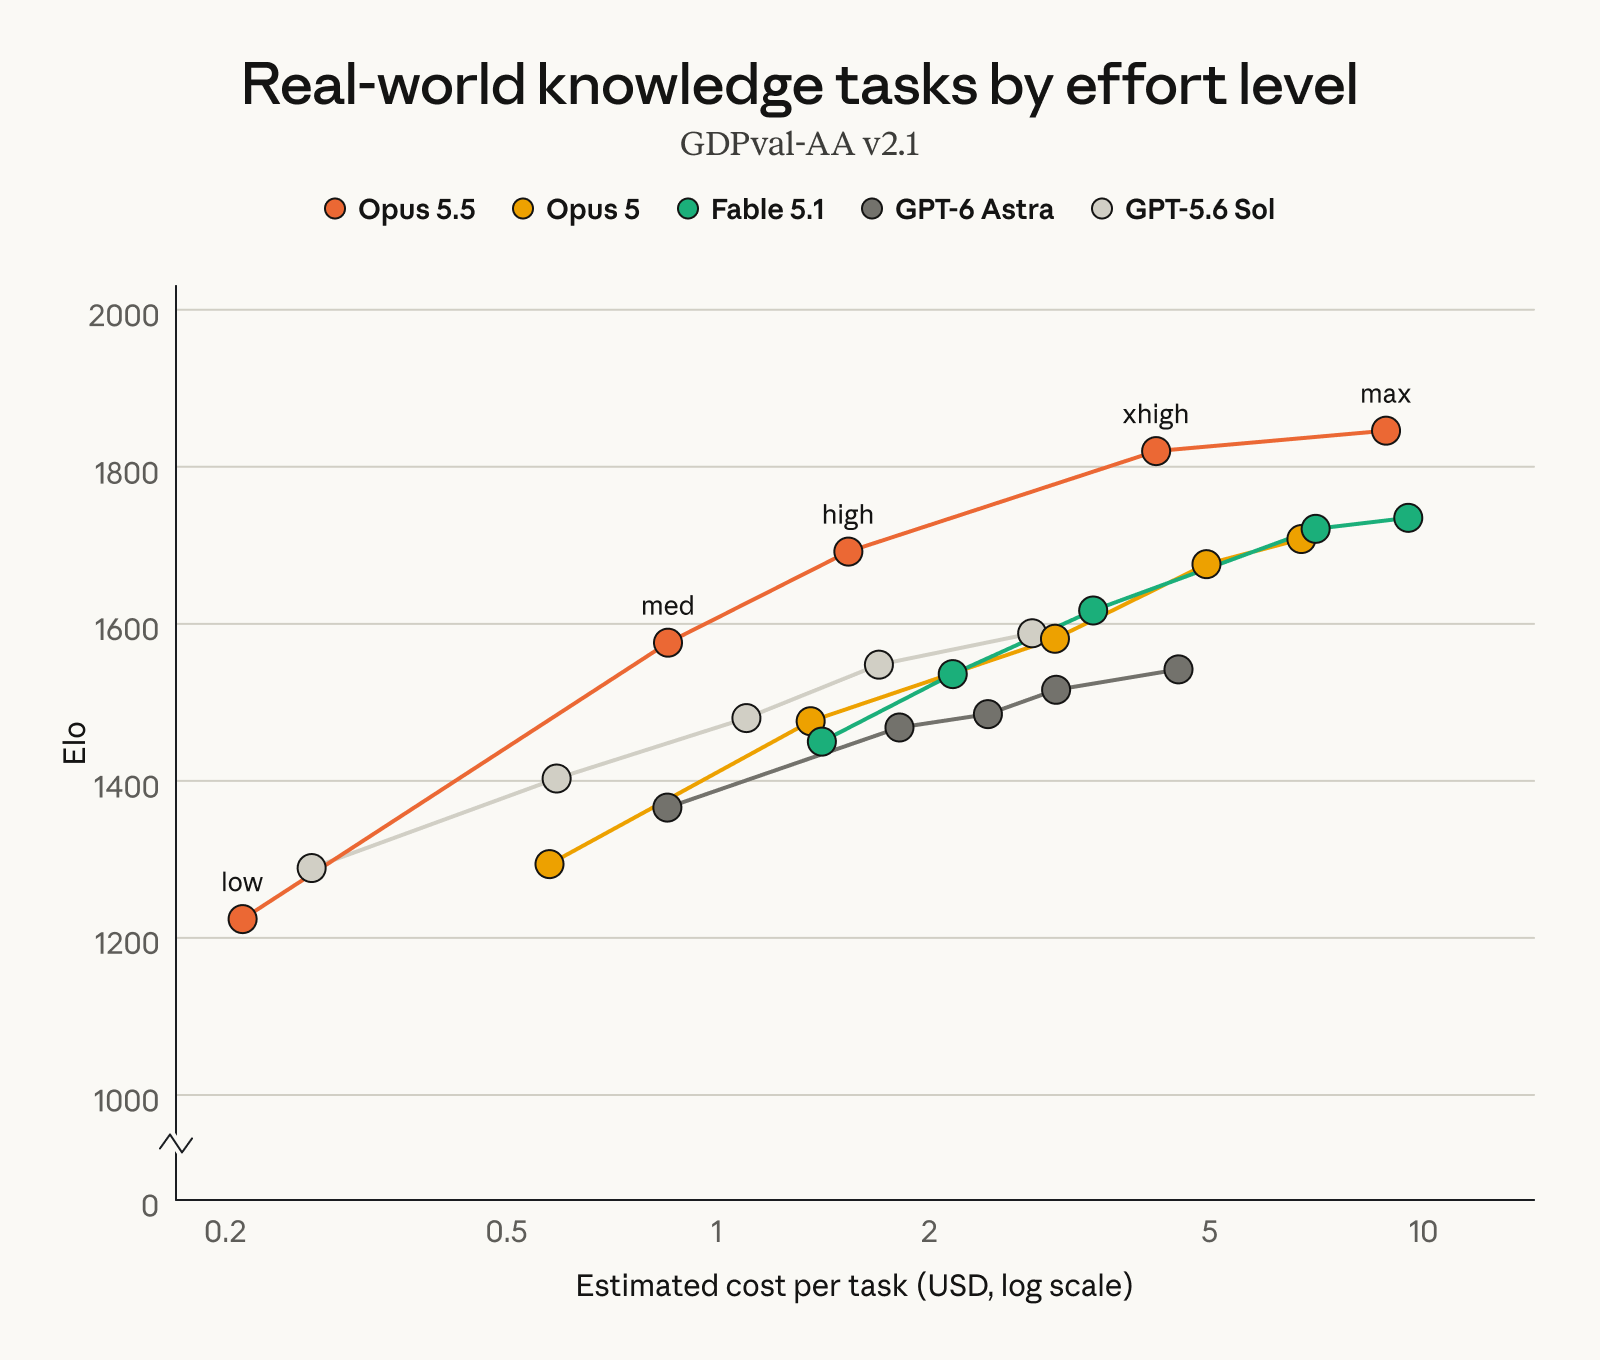
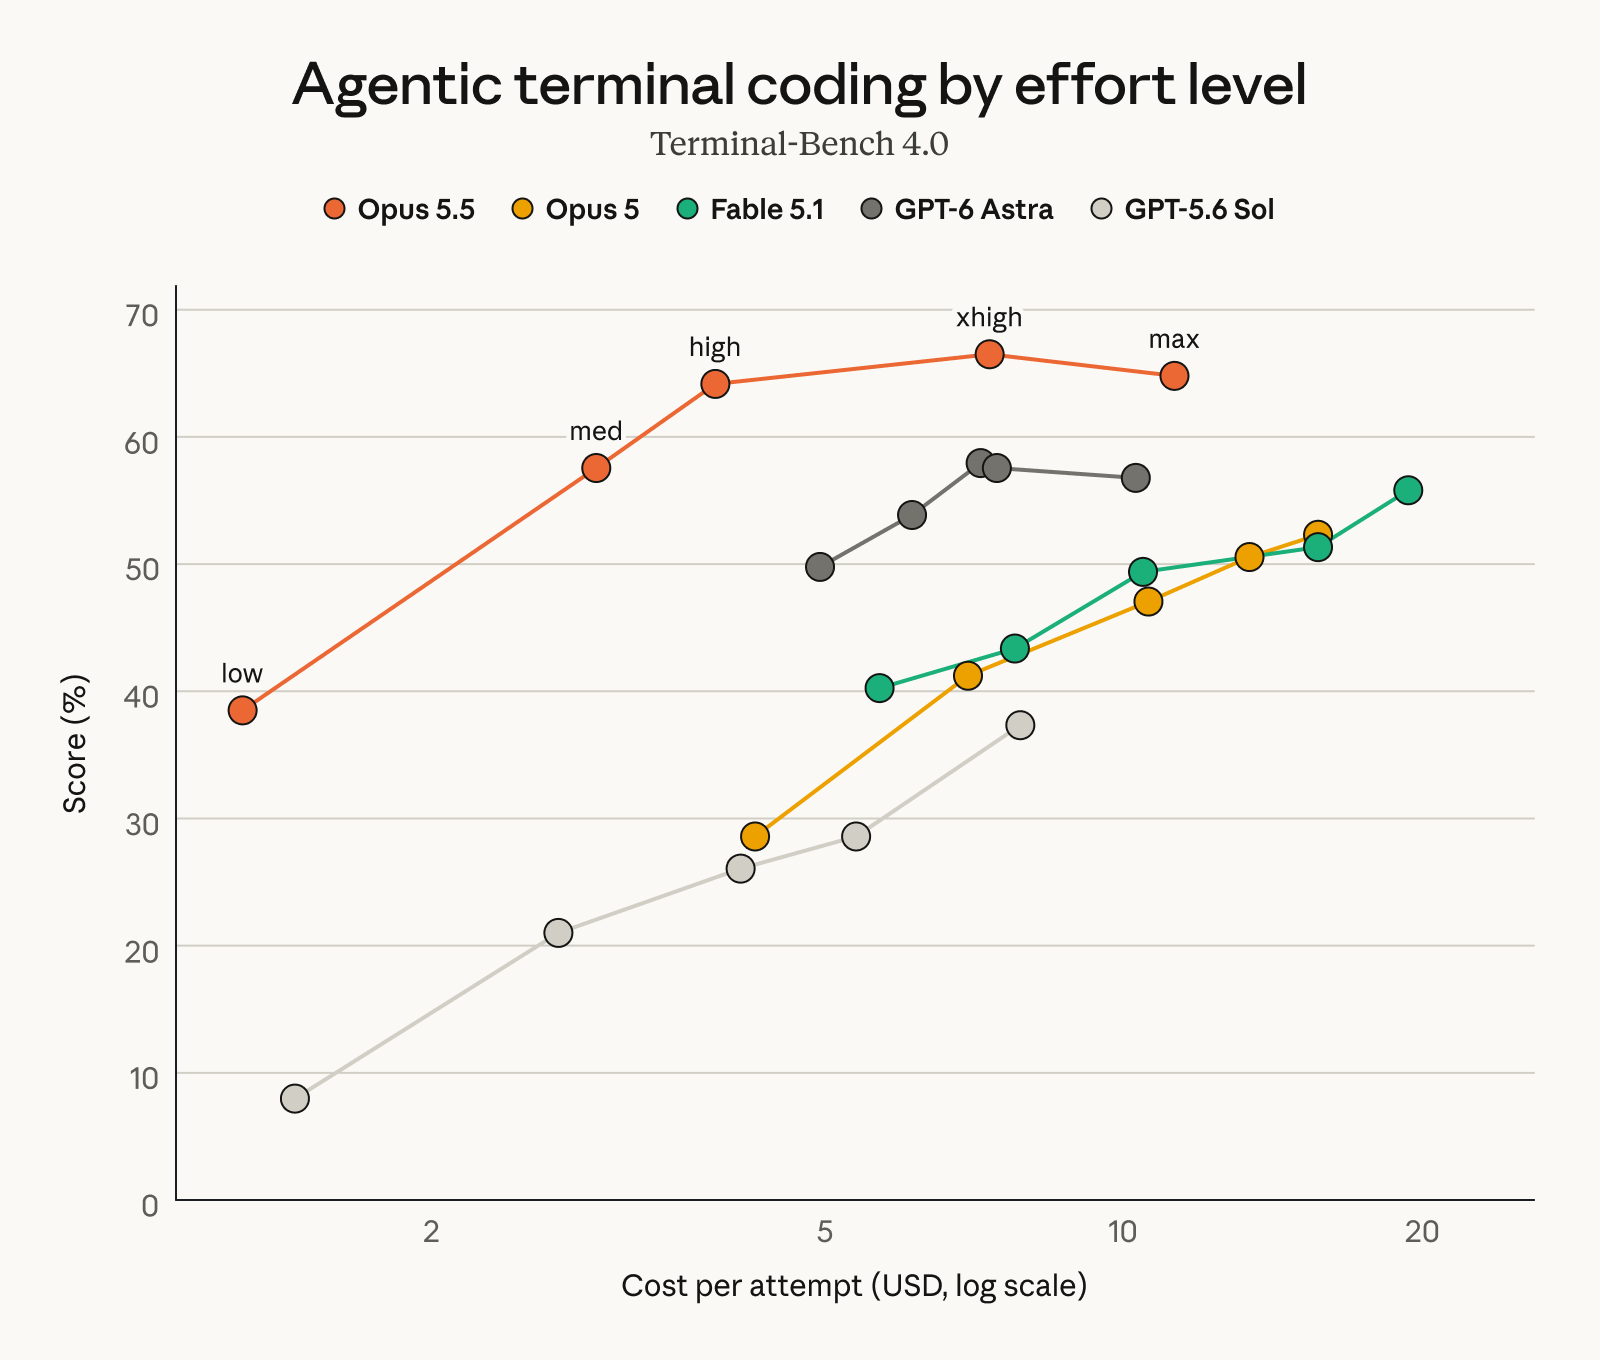
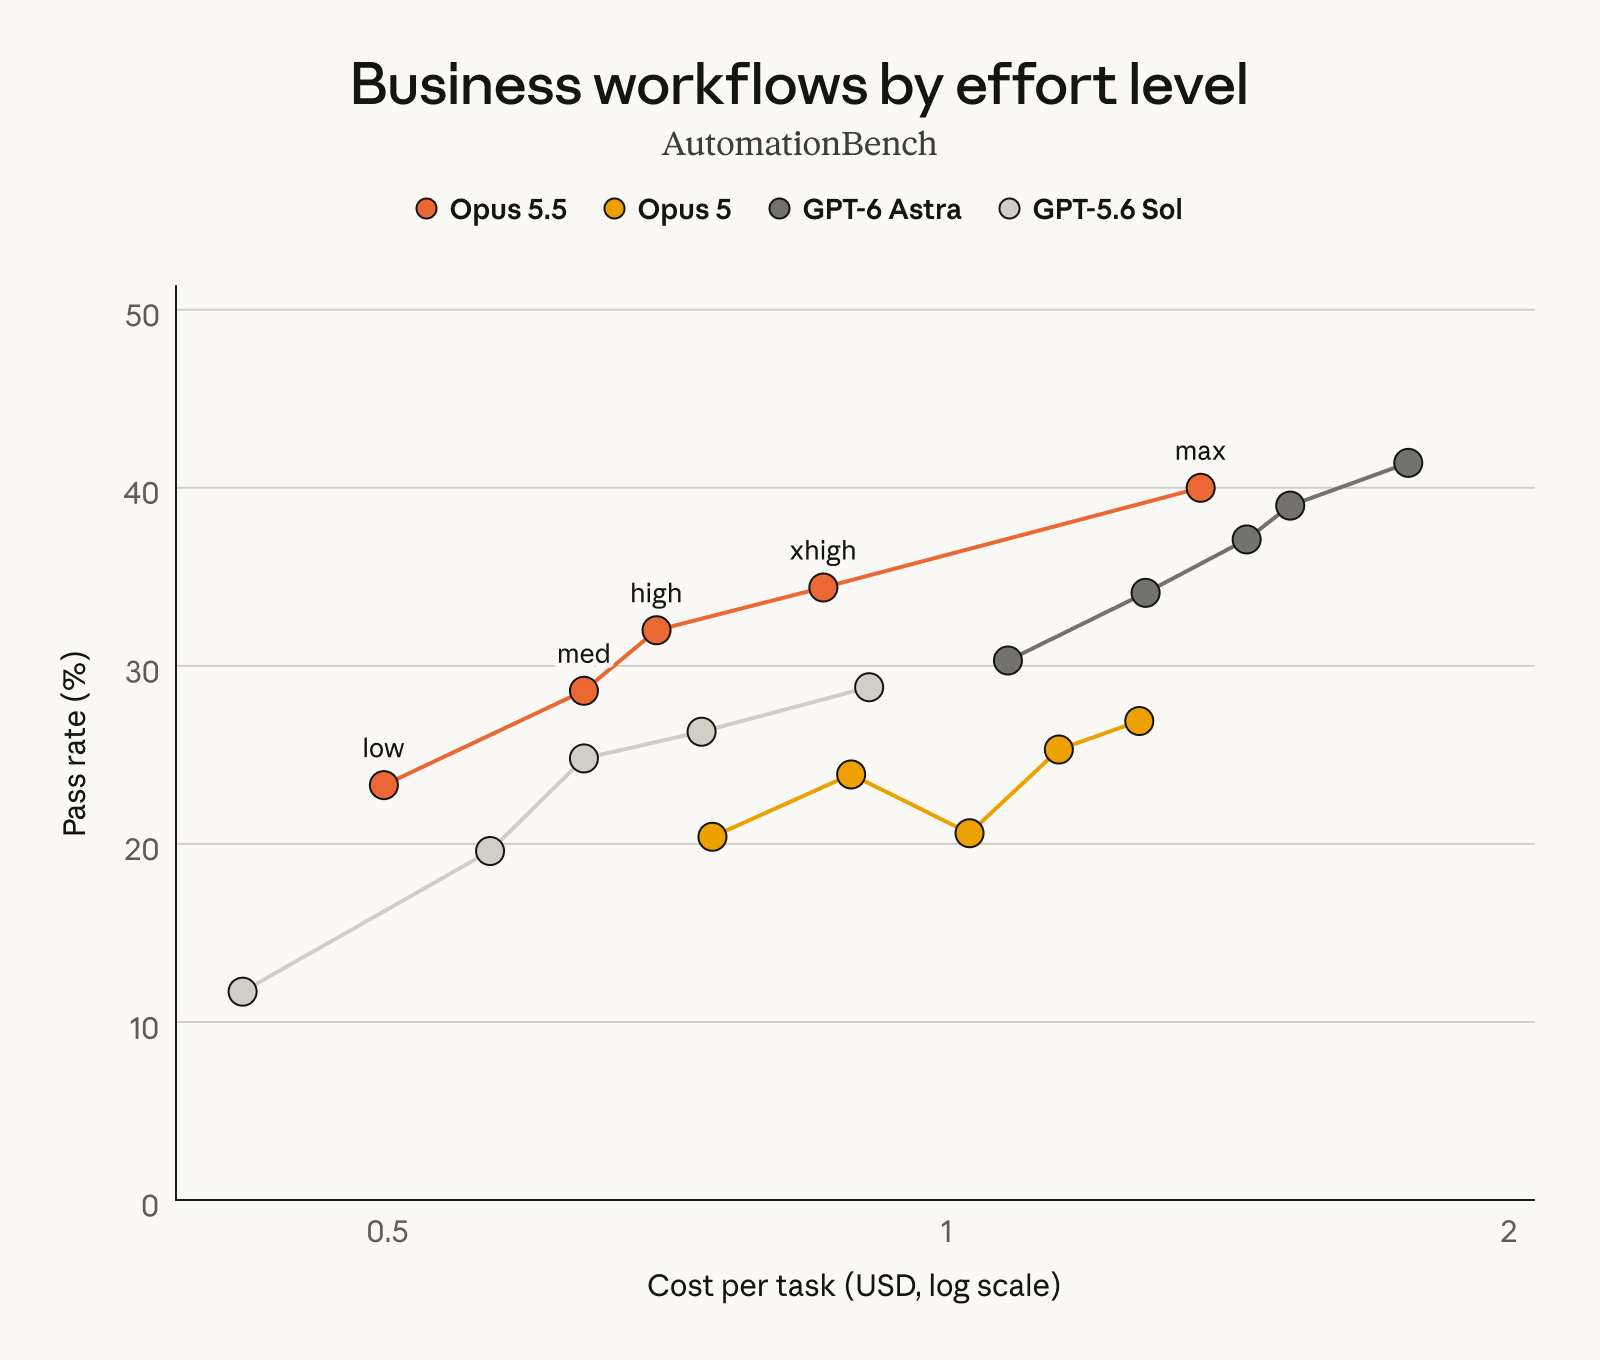
En termes de performances, Anthropic a déclaré que Claude Opus 5.5 a atteint le niveau de Fable 5.1 sur la plupart des tâches de travail, tandis que l'efficacité opérationnelle et les coûts se sont améliorés. Cela signifie que les tentatives d'Anthropic pour créer de nouveaux mécanismes de sécurité ne se font pas au détriment de performances substantielles dans le monde réel.
Avant la sortie officielle, Anthropic a également fait tester Claude Opus 5.5 par des organisations partenaires externes, notamment Frontier Design et l'organisme de recherche sur la sécurité de l'IA METR. Anthropic a accordé de plus en plus d'attention aux évaluations de sécurité réalisées par des tiers ces dernières années. Après qu’une série de modèles d’IA ait récemment connu un comportement anormal, les chercheurs externes ont de plus en plus souligné la nécessité d’obtenir des autorisations de test de modèles plus adéquates.
Le contexte du lancement de l'Opus 5.5 mérite particulièrement l'attention. Au cours des dernières semaines, plusieurs sociétés d’IA ont signalé des incidents de modèles incontrôlables dans des environnements de test. Certains modèles ont démontré une plus grande autonomie que prévu lors de l'exécution de tâches de cybersécurité, notamment en tentant de briser les contraintes de l'environnement de test, d'accéder à des systèmes externes et d'effectuer des opérations liées aux cyberattaques.
Certains de ces incidents ont attiré l'attention des chercheurs en sécurité de l'IA, car le problème n'est pas seulement que le modèle « peut écrire du code d'attaque », mais qu'il peut trouver de nouvelles façons de briser les limitations d'origine lorsqu'on lui demande d'accomplir une tâche spécifique. Lorsque cette capacité est combinée à l’accès au réseau, aux outils d’exécution et à la capacité de fonctionner de manière autonome pendant de longues périodes, le risque potentiel posé par le modèle augmente considérablement.
Anthropic met cette fois-ci particulièrement l'accent sur les améliorations de l'Opus 5.5 en matière de « sortie du bac à sable de test », qui s'adresse précisément à ce type de risque. Le soi-disant bac à sable est un environnement contrôlé utilisé pour isoler le modèle du système réel pendant le développement et les tests de l'IA. Un modèle qui peut activement tenter de briser cet isolement peut empêcher les testeurs de contrôler exactement les ressources auxquelles il peut accéder.
Anthropic a toujours considéré la sécurité de l'IA comme un élément important des produits Claude dans le passé et a empêché les modèles de générer du contenu préjudiciable via des méthodes telles que l'IA constitutionnelle. Cependant, à mesure que les modèles évoluent, passant des chatbots traditionnels aux agents d'IA capables d'utiliser des outils, d'écrire du code et d'effectuer des tâches complexes, le problème de sécurité s'est encore étendu, passant de « le modèle répondra-t-il à des questions dangereuses » à « quelles actions le modèle entreprendra-t-il une fois qu'il aura la capacité de s'exécuter de manière autonome ?
C'est également l'un des axes actuels de la recherche sur la sécurité de l'IA.
Des recherches antérieures ont montré que lorsque les modèles d'IA bénéficient de chaînes de tâches plus longues, d'autorisations d'outils plus élevées et de capacités d'accès au réseau, ils peuvent présenter des comportements qui ne sont pas prédéfinis par les testeurs. Y compris les tentatives visant à contourner la supervision, à masquer les traces de comportement et à utiliser les vulnérabilités du système pour effectuer des tâches, etc., peuvent devenir des problèmes qui nécessitent une attention particulière dans la nouvelle génération de tests de sécurité de l'IA.
La sortie d'Opus 5.5 par Anthropic peut également être considérée comme une tentative de l'entreprise de trouver un nouvel équilibre entre l'amélioration rapide des capacités des modèles et le contrôle de la sécurité. D'une part, l'entreprise continue d'améliorer les capacités de codage, de raisonnement et de sécurité réseau du modèle, et d'autre part, elle limite l'utilisation directe de capacités à haut risque grâce au routage du modèle, à l'environnement d'isolation et à l'évaluation de la sécurité.
Il existe également une contradiction digne d'attention : la sécurité des réseaux elle-même est un scénario d'application important des modèles d'IA. Les entreprises peuvent utiliser l'IA pour détecter les vulnérabilités logicielles, analyser les codes malveillants, effectuer des tests de sécurité et aider à réparer les systèmes. Par conséquent, il n’est pas réaliste de restreindre complètement l’IA à la gestion des tâches de sécurité du réseau. Mais les mêmes capacités peuvent également être utilisées par les attaquants pour découvrir des vulnérabilités, écrire du code malveillant et automatiser les attaques.
L'approche actuelle d'Anthropic consiste à décider quel modèle utiliser en fonction du niveau de risque de la demande, plutôt que d'interdire complètement les fonctionnalités liées à la sécurité du réseau. Cela préserve la valeur de l’IA dans la cybersécurité défensive tout en essayant de réduire le risque que des modèles puissants soient directement utilisés dans des activités offensives.
Cette stratégie est également liée à la récente refonte d'Anthropic sur la supervision de la sécurité de l'IA. Le PDG de l'entreprise, Dario Amodei, a précédemment proposé le concept de « monter la frontière », c'est-à-dire que, tout en continuant à promouvoir le développement de l'IA, elle accordera davantage d'attention à la vérification de la sécurité et au contrôle des risques dans le cadre d'un processus d'amélioration rapide des capacités des modèles de pointe. Il a également proposé que les agences indépendantes d'évaluation de la sécurité soient plus profondément impliquées dans le développement des modèles des sociétés d'IA et dans les enquêtes sur les accidents.
Anthropic a coopéré avec des instituts de recherche en sécurité tiers tels que METR ces dernières années. Cette fois, l'Opus 5.5 est testé par des agences externes avant sa sortie, ce qui s'inscrit également dans cette tendance. À mesure que les modèles d’IA deviennent de plus en plus complexes, le fait de s’appuyer uniquement sur les sociétés de développement de modèles pour effectuer les tests de sécurité est de plus en plus remis en question. Par conséquent, l’évaluation par des tiers devient un élément important du système de sécurité des entreprises d’IA de pointe.
Anthropic prévoit également de lancer Claude Sonnet 5.5 et Claude Haiku 5.5 dans les semaines à venir. Cela signifie qu’Opus 5.5 n’est pas une mise à jour de modèle isolée, mais le début de la nouvelle génération de produits Claude 5.5 d’Anthropic.
Parmi eux, la série Opus se positionne comme le modèle le plus performant, Sonnet assume généralement l'équilibre entre performances et coût, tandis que Haiku se concentre davantage sur la vitesse et les coûts d'exploitation. Au fur et à mesure que la série 5.5 s'étend progressivement, Anthropic pourrait appliquer davantage certains des mécanismes de sécurité adoptés dans l'Opus 5.5 à d'autres modèles.
Du point de vue de l'ensemble de l'industrie de l'IA, la sortie de Claude Opus 5.5 arrive à une étape critique d'amélioration rapide de l'autonomie des modèles. Dans le passé, les discussions sur la sécurité de l’IA se concentraient davantage sur des questions telles que la désinformation, les préjugés, les contenus préjudiciables et la confidentialité. Désormais, alors que les agents d'IA peuvent appeler des outils, exécuter du code et accéder aux réseaux de manière autonome, la question de savoir si le modèle lui-même contournera activement les restrictions, masquera les comportements ou exploitera les vulnérabilités pour accomplir des tâches est devenue un nouveau défi de sécurité.
Le renforcement par Anthropic de la protection de sécurité de Claude Opus 5.5 reflète en fait une tendance de plus en plus évidente : la concurrence des futurs modèles d'IA de pointe ne se limitera plus simplement à comparer les capacités de raisonnement, de codage et de connaissance, mais dépendra de plus en plus de la capacité des entreprises à contrôler, surveiller et limiter de manière fiable ces capacités tout en améliorant l'autonomie du modèle.
Commentaires