
Résumé :
Google a officiellement annoncé aujourd'hui sa dernière avancée dans le domaine de l'interaction vocale native de bout en bout, en lançant une nouvelle génération de grands modèles de voix en temps réel Gemini 3.8 Live et Gemini 3.8 Live Extended Thinking personnalisés pour les tâches difficiles.
Ces deux modèles représentent une avancée majeure dans le système technologique audio-audio natif de Google. Non seulement ils poussent le délai et le naturel des conversations en temps réel vers de nouveaux sommets, mais ils atteignent également pour la première fois des capacités de raisonnement approfondies en plusieurs étapes dans des flux vocaux à faible latence, changeant complètement le paradigme d'application de l'IA vocale dans des scénarios professionnels complexes.
Dans l'architecture d'interaction vocale traditionnelle précédente, les systèmes d'IA devaient généralement faire un compromis entre un « dialogue superficiel à réponse rapide » et une « réflexion approfondie à long terme ». Faire face à des problèmes difficiles obligeait souvent les utilisateurs à endurer de longues périodes d'attente silencieuse. Gemini 3.8 Live lancé par Google se concentre sur l'optimisation de la conversation ultra-rapide et de l'expérience d'interaction quotidienne en streaming. Il peut fournir aux utilisateurs une communication vocale en temps réel extrêmement fluide et de niveau humain avec des fluctuations d'intonation plus sensibles, des interruptions naturelles et des capacités de compréhension du contexte. Gemini 3.8 Live Extended Thinking, lancé sur cette base, a été fondamentalement mis à niveau pour les flux commerciaux très complexes. Ce modèle donne à l'IA la capacité de « penser comme elle parle » (Penser comme elle parle) en arrière-plan, permettant au système d'effectuer simultanément un désassemblage logique complexe en plusieurs étapes, un débogage de code ou un diagnostic technique en arrière-plan tout en maintenant un dialogue cohérent en temps réel, sans qu'il soit nécessaire d'interrompre brusquement le rythme de la conversation lorsqu'il rencontre des problèmes difficiles.
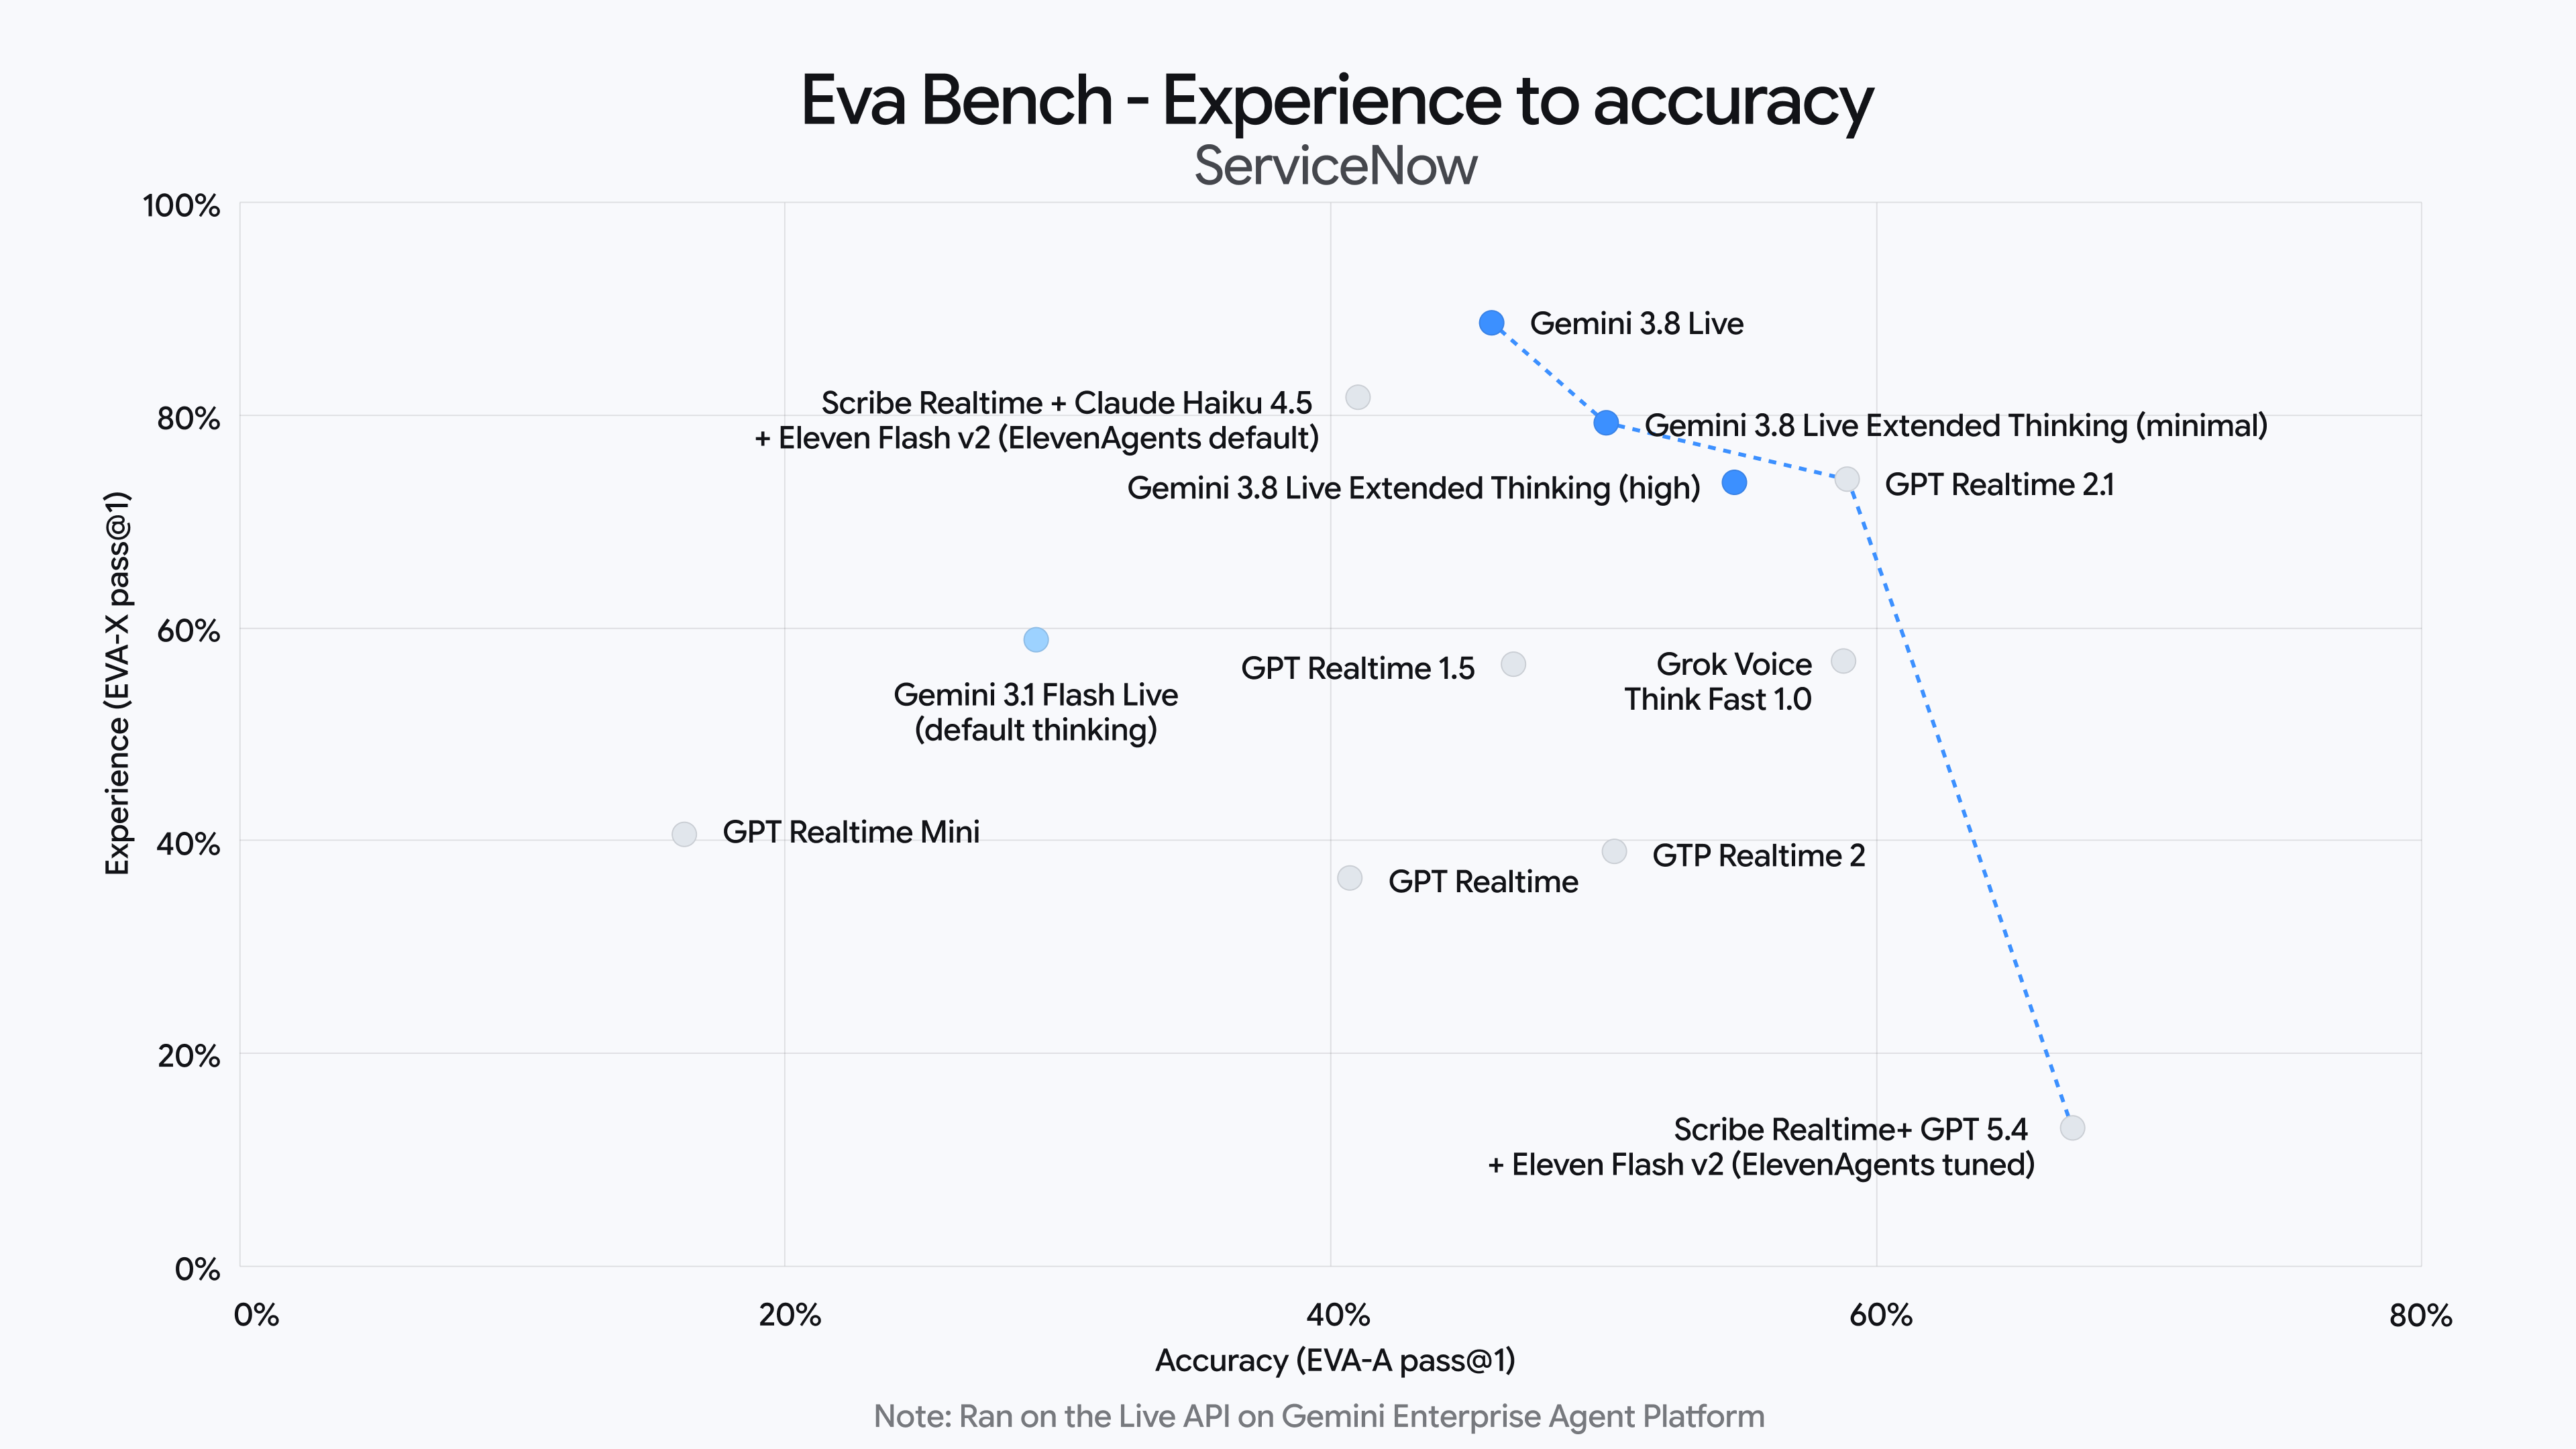
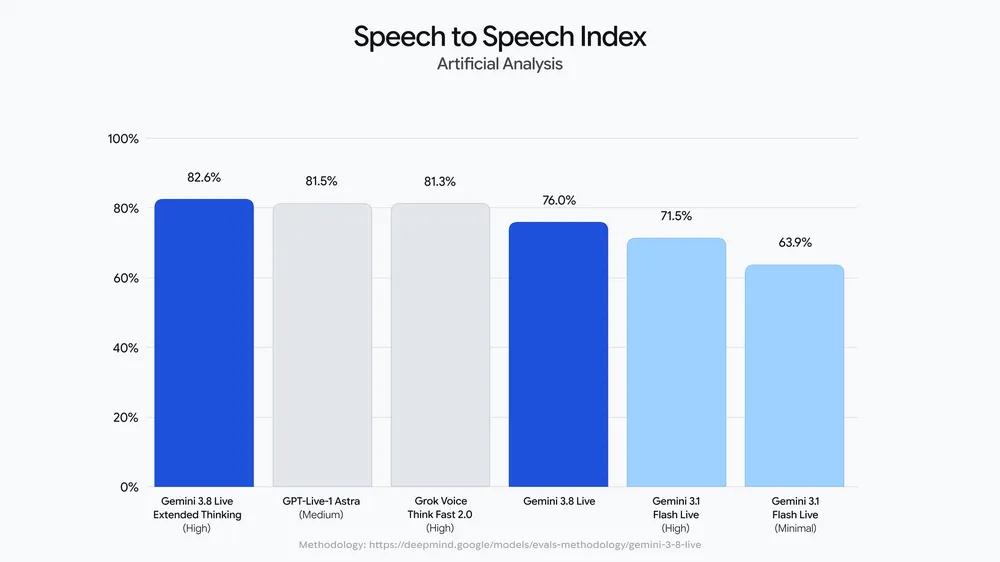
En termes d'application pratique, la nouvelle génération de modèles de la série Live élargira considérablement les limites des services des assistants vocaux. En plus des conversations naturelles quotidiennes, Gemini 3.8 Live et les versions de raisonnement étendu ont démontré des performances nettement meilleures que les versions précédentes dans des scénarios avec des exigences intellectuelles élevées telles que le dépannage d'étapes en temps réel, la dérivation mathématique complexe, le tutorat simultané en langue étrangère en temps réel et l'exécution d'instructions multitâches en continu, se classant au premier rang dans plusieurs références de l'industrie du raisonnement multimodal et vocal.
Pour les développeurs et les utilisateurs d'entreprise, Google a annoncé que les fonctionnalités de modèle pertinentes seraient désormais officiellement ouvertes à l'accès via l'API Gemini et Google AI Studio. Les développeurs peuvent directement appeler cette interface API audio native à latence extrêmement faible pour créer rapidement des services d'agent vocal full duplex de nouvelle génération avec des capacités de raisonnement d'ordre élevé sous des formes de produits telles que du matériel intelligent, un service client, une assistance à la programmation en temps réel et un bureau collaboratif.
Commentaires