
Résumé :
Le fondateur de Linux, Linus Torvalds, explore plus en détail l'application des outils de programmation d'intelligence artificielle dans le développement du noyau. Après avoir récemment développé un correctif d'optimisation des performances du noyau Linux à l'aide de Claude Code d'Anthropic, Torvalds a utilisé un grand modèle de langage (LLM) pour analyser un morceau de code du noyau qui avait longtemps été difficile à comprendre. Il a non seulement confirmé une faille précédemment signalée par le développeur, mais a également découvert trois autres vulnérabilités dormantes depuis plus de dix ans. Ces problèmes sont tous liés à l'implémentation d'Associative Array dans le noyau Linux.
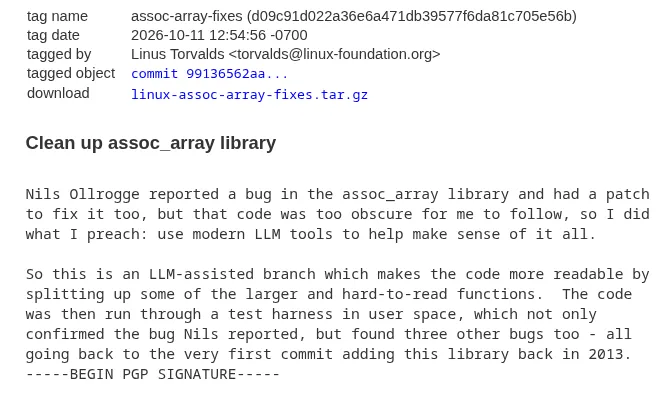
Selon un rapport publié par Phoronix le 12 octobre, Torvalds a récemment ajouté une balise Git appelée "assoc-array-fixes" à son référentiel de code du noyau Linux pour organiser et marquer une série de réparations sur le code du tableau associatif. Ce travail est indépendant de son projet précédent consistant à utiliser Claude Code pour optimiser les performances de lecture de fichiers, mais tous deux reflètent ses tentatives d'introduire des outils d'IA dans le processus complexe de développement du noyau.
La cause de ce travail était que le développeur Nils Ollrogge a signalé un bug dans la bibliothèque de tableaux associatifs et a soumis un correctif correspondant. Cependant, lorsque Torvalds a examiné le correctif, il a constaté que l'implémentation du code concerné était trop obscure pour comprendre directement sa logique spécifique, et qu'il était donc impossible de juger facilement si le correctif résolvait correctement le problème.
Face à cette situation, Torvalds a choisi d'utiliser des modèles linguistiques modernes à grande échelle pour faciliter l'analyse. Il a écrit dans la description de la balise Git que cette fois, il avait adopté l'approche qu'il préconisait auparavant, qui consiste à utiliser des outils LLM modernes pour aider à comprendre du code complexe.
Torvalds a ensuite organisé un ensemble de correctifs avec des modifications assistées par l'IA pour diviser certaines fonctions volumineuses et difficiles à lire en une structure plus claire, rendant la logique du code plus facile à comprendre et à réviser. Il convient de noter que l’objectif de ce travail n’est pas simplement de laisser l’IA réécrire l’intégralité de l’implémentation du tableau associatif, mais d’abord d’améliorer la lisibilité du code existant, puis de vérifier par des tests si son comportement est celui attendu.
Une fois la modification terminée, le code correspondant a également été placé dans le cadre de test de l'espace utilisateur pour être exécuté. Les tests ont non seulement confirmé que le bug initialement signalé par Olrog était bien présent, mais ont également découvert trois problèmes supplémentaires.
Plus inquiétant encore, ces failles ne constituent pas de nouveaux problèmes introduits récemment. Selon Torvalds, les trois autres vulnérabilités découvertes remontent à 2013, lorsque la bibliothèque de tableaux associatifs a été introduite pour la première fois dans le noyau Linux. En d’autres termes, ils se cachent dans le code depuis plus d’une décennie, sans être entièrement détectés par des tests pertinents.
Le tableau associatif du noyau Linux est une structure de données utilisée pour organiser et récupérer des données par valeur clé. Contrairement aux tableaux ordinaires qui accèdent aux éléments via des indices entiers, les tableaux associatifs peuvent trouver les données correspondantes en fonction de clés spécifiques, ils conviennent donc aux scénarios nécessitant une indexation et une gestion flexibles des objets.
L'implémentation du tableau associatif dans le noyau Linux répond aux besoins de gestion des données au sein du noyau. Étant donné que le code du noyau doit s'exécuter dans des conditions strictes de performances, de sécurité de la mémoire et d'accès simultané, l'implémentation de ces composants de base est souvent plus complexe que celle d'un code similaire dans des applications ordinaires. Même si une fonction effectue apparemment uniquement l'insertion, la suppression ou la recherche de données, elle peut impliquer un ajustement de la structure arborescente, la gestion du cycle de vie des nœuds et diverses conditions limites.
Le manque de structure claire dans ce type de code rend plus difficile pour les responsables de comprendre son comportement. Les développeurs doivent non seulement confirmer la logique de fonctionnement dans des circonstances normales, mais également analyser les entrées anormales, les états particuliers de la structure des données et les problèmes pouvant survenir lorsque plusieurs opérations sont effectuées en continu.
À mesure que le code continue d'évoluer, des défauts qui ne se déclenchent pas facilement lors des premières implémentations peuvent persister pendant une longue période. En particulier dans les structures de données complexes, certaines erreurs ne seront révélées que dans des séquences d'opérations spécifiques ou des états structurels particuliers, et les tests ordinaires ne couvrent pas nécessairement toutes les situations.
L'idée adoptée dans ce travail assisté par l'IA est d'abord de diviser les grandes fonctions difficiles à comprendre en parties plus faciles à analyser, puis de vérifier la logique pertinente via un programme de test indépendant. Une structure de code plus claire aide les développeurs à identifier la relation entre les différentes opérations et permet également aux outils de test de créer plus facilement des conditions de vérification pour des comportements spécifiques.
Cependant, les trois vulnérabilités découvertes cette fois ne peuvent pas simplement être attribuées à la capacité de l'IA à comprendre des programmes au-delà des humains. Plus précisément, la refactorisation du code assistée par l'IA, les évaluations des développeurs et les frameworks de test fonctionnent tous ensemble. Les grands modèles de langage peuvent aider à organiser la logique du code et à identifier les problèmes potentiels, mais en fin de compte, il est toujours nécessaire de confirmer si les défauts sont réels grâce à une exécution réelle et des tests reproductibles.
La particularité de ce cas est que l'IA a non seulement participé à l'analyse du code, mais a également aidé Torvalds à surmonter les obstacles à la compréhension pendant le processus de révision des correctifs. Pour les développeurs qui gèrent de grands projets open source, cela peut être une méthode de travail utile : lorsque le code est trop complexe et qu'il est difficile pour les responsables de juger rapidement si le plan de réparation est correct, l'IA peut être utilisée pour aider à trier la structure du code, puis les conclusions peuvent être vérifiées par des tests et une révision manuelle.
Actuellement, cet ensemble de correctifs pour les tableaux associatifs n'a pas encore été fusionné dans la ligne principale du noyau Linux. Selon les rapports de Phoronix, les travaux associés devraient être encore avancés au cours de la prochaine fenêtre de fusion Linux 7.4, mais la question de savoir si la fusion finale dépendra toujours des résultats des révisions et des tests de code ultérieurs.
Il convient de noter que ce n'est pas la première fois que Torvalds démontre récemment publiquement l'utilisation de l'IA dans le développement du noyau Linux.
Auparavant, il utilisait Claude Code pour réaliser un autre travail d'optimisation du noyau. L'objectif était de résoudre le problème de concurrence provoqué par l'opération de comptage de références de pages mémoire lorsque plusieurs threads lisaient le même fichier en même temps. Le correctif correspondant tente de réduire les opérations inutiles de comptage de références en ajustant le chemin de lecture du fichier, améliorant ainsi les performances de lecture sous des charges de travail spécifiques.
Dans ce travail, AI a participé à l'écriture initiale du code, au développement du programme de test, à la révision du code et à la rédaction des documents de notes de mise à jour. Torvalds est chargé de déterminer les orientations d'optimisation, de superviser le processus de développement et d'effectuer des mesures de performances sur son propre ordinateur.
Les objectifs techniques des deux tâches sont différents, mais elles incarnent un modèle de développement similaire : des ingénieurs familiers avec le noyau déterminent le problème, puis utilisent l'IA pour comprendre des implémentations complexes, écrivent ou ajustent le code et enfin vérifient les résultats via des tests.
Ce modèle peut être particulièrement utile pour les projets open source avec des cycles de maintenance à grande échelle et longs comme Linux. Le code du noyau a continué d'évoluer au fil des décennies et contient un historique de mise en œuvre complet et des exigences de compatibilité complexes. Même les responsables expérimentés ne peuvent pas toujours connaître tous les détails de chaque sous-système.
La révision de code traditionnelle repose principalement sur les développeurs pour lire le code, analyser la logique et concevoir des tests. Les outils d'IA ont la possibilité d'aider les responsables à trier plus rapidement le code inconnu, à expliquer la relation entre les fonctions, à proposer des conditions limites possibles et à générer des cas de test. Ils ne remplacent pas l’examen professionnel, mais devraient réduire le temps nécessaire à la compréhension d’un code complexe.
Dans le même temps, le code généré par l'IA présente également des limites. Les grands modèles de langage peuvent mal comprendre des flux de contrôle complexes, ignorer des conditions aux limites rares ou proposer des modifications qui semblent raisonnables mais ne garantissent pas réellement l'exactitude. Pour les noyaux du système d'exploitation, ces problèmes sont particulièrement importants car les erreurs de code peuvent affecter la stabilité du système, la sécurité de la mémoire et même le fonctionnement fiable de l'ensemble du système.
Par conséquent, la participation d'AI au développement du noyau ne signifie pas que les exigences de révision peuvent être assouplies. Au lieu de cela, la refactorisation du code, les tests automatisés, l'examen des correctifs et la vérification réelle restent essentiels pour garantir la qualité des modifications. Le projet de réseau associatif a permis de découvrir des problèmes de longue date, ce qui montre simplement que les outils d'IA doivent être combinés à des processus de vérification technique stricts pour être efficaces.
Torvalds a toujours eu une attitude pragmatique à l'égard des outils de programmation d'IA. Il a reconnu la valeur de l’IA pour faciliter le processus de développement, mais n’a pas préconisé que les développeurs acceptent le code généré par la machine sans examen. Cette fois, il a déclaré publiquement qu'il utilisait LLM pour analyser le code, ce qui montre en outre que l'IA est en train de devenir une option auxiliaire dans la boîte à outils de développement du noyau.
Plus largement, l'incident met également en lumière une difficulté de longue date dans la maintenance des grands projets logiciels : le code doit non seulement fonctionner correctement, mais doit également être compréhensible pour les futurs développeurs. Pour les logiciels de base maintenus depuis plus de dix ans, voire plusieurs décennies, la lisibilité elle-même est un facteur important affectant la fiabilité.
Cette modification améliore la structure du code en divisant les fonctions complexes et utilise des tests pour découvrir des problèmes précédemment manqués, démontrant le lien étroit entre la lisibilité du code et le dépannage des défauts. Lorsque la logique du programme est plus claire, il est plus facile pour les développeurs d'identifier les chemins d'erreur potentiels et de créer des tests couvrant les comportements pertinents.
Si cet ensemble de correctifs finit par intégrer la ligne principale de Linux, son importance résoudra non seulement les quatre problèmes identifiés, mais fournira également une base de code plus claire pour la maintenance ultérieure.
À mesure que les outils de programmation d'IA continuent de se développer, il pourrait y avoir davantage de cas similaires dans les grands projets open source à l'avenir. Cependant, pour les logiciels de base clés tels que le noyau Linux, ce qui détermine réellement si le développement assisté par l'IA peut être reconnu à long terme est de savoir si le correctif peut passer un examen strict, si le test peut reproduire le problème et si le code final est suffisamment fiable.
Cette fois, l'IA n'a pas remplacé le fondateur de Linux dans le jugement final, mais l'a aidé à comprendre le code qui était à l'origine difficile à réviser et à découvrir davantage les défauts cachés depuis de nombreuses années. Pour le génie logiciel mature, il s’agit peut-être de l’une des directions d’application les plus pratiques de l’intelligence artificielle.
Commentaires