
Résumé :
Le fondateur du noyau Linux, Linus Torvalds, développe une solution d'optimisation des performances du noyau Linux à l'aide de l'outil de programmation d'intelligence artificielle Claude Code.
Ce travail cible un goulot d'étranglement des performances dans le mécanisme de gestion de la mémoire du noyau Linux. L'objectif est de réduire la concurrence provoquée par le comptage des références de pages mémoire lorsque plusieurs threads lisent le même fichier en même temps, améliorant ainsi l'efficacité de la lecture des fichiers.
Torvalds a non seulement utilisé l'IA pour aider à écrire du code, mais a également utilisé cet outil pour écrire des programmes de test, effectuer des révisions de code et rédiger des notes de mise à jour pertinentes.
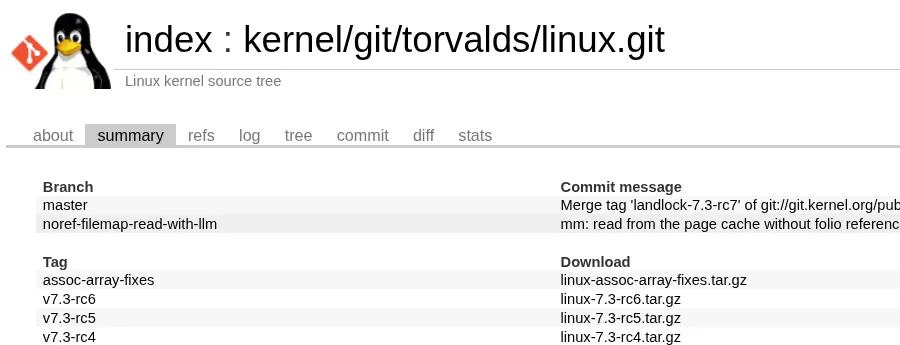
En attendant la sortie de Linux 7.3-rc7, Torvalds a récemment actualisé son référentiel de code Git du noyau Linux et a découvert qu'une nouvelle branche inhabituelle était apparue dans le référentiel. Contrairement à sa pratique habituelle de maintenance de la branche principale, cette branche nommée "noref-filemap-read-with-llm" est dédiée au développement d'une série de correctifs d'amélioration du noyau. Comme le montre le LLM dans le nom de la branche, ce travail est lié à la programmation assistée par modèle de grand langage.
Torvalds a précisé plus tard dans les notes de mise à jour correspondantes que ce travail avait été réalisé sous sa direction et avec l'aide de Claude Code. AI a non seulement participé à la mise en œuvre du code, mais a également aidé à rédiger des programmes de test, à effectuer des révisions de code et à rédiger la version initiale de la documentation de la série de correctifs. Les mesures de performance pertinentes ont été effectuées sur le propre ordinateur de Torvalds.
Cette optimisation cible principalement un problème spécifique dans le chemin de lecture des fichiers du noyau Linux. Lorsque plusieurs threads lisent simultanément de petits morceaux de données du même fichier, ils peuvent entrer en concurrence autour du nombre de références de pages mémoire dans le cache des pages de fichier, provoquant une concurrence entre les threads pour les structures de données associées, limitant ainsi les performances de lecture.
Pour comprendre ce problème, vous devez d'abord comprendre comment le noyau Linux gère la lecture des fichiers.
Linux utilisera le cache de pages (Page Cache) pour enregistrer les données de fichiers lues à partir du périphérique de stockage. Lorsqu'un programme accède à nouveau au contenu d'un fichier mis en cache en mémoire, le noyau peut souvent fournir les données directement à partir de la mémoire sans avoir à revisiter le disque ou un autre périphérique de stockage à chaque fois. La mise en cache des pages est donc un mécanisme important permettant à Linux d'améliorer l'efficacité de l'accès aux fichiers.
Afin de gérer ces données mises en cache, le noyau doit suivre le cycle de vie des objets mémoire associés. Le mécanisme de comptage de références dans les implémentations traditionnelles peut aider le noyau à déterminer si un objet mémoire est toujours utilisé et quand il peut libérer en toute sécurité les ressources associées.
Cependant, lorsqu'un grand nombre de threads accèdent fréquemment au même fichier, même si les données qu'ils lisent sont déjà en mémoire, les opérations de comptage de références associées peuvent toujours entraîner une surcharge de synchronisation supplémentaire. Dans un système à processeurs multicœurs, si plusieurs threads mettent continuellement à jour la même valeur de comptage partagé, des problèmes tels qu'une augmentation du trafic de cohérence du cache et des cœurs de processeur s'attendant les uns les autres peuvent survenir.
Pour les scénarios à thread unique ou à faible concurrence, cette surcharge peut ne pas être perceptible. Mais dans les serveurs, bases de données, systèmes de build et autres charges de travail hautement concurrents qui doivent gérer simultanément un grand nombre de demandes de lecture de fichiers, les opérations de synchronisation récurrentes peuvent progressivement devenir un goulot d'étranglement en termes de performances.
La série de correctifs que Torvalds développe est conçue pour réduire les opérations inutiles de comptage de références. L'idée principale est d'ajuster le chemin de lecture du fichier afin que le noyau puisse lire les données directement à partir du cache de pages dans certaines conditions sans avoir à effectuer les opérations traditionnelles de gestion des références de folio pour chaque accès pertinent.
folio est ici une des abstractions de base utilisées par le noyau Linux pour gérer un ensemble de pages mémoire contiguës ou associées. Ces dernières années, le noyau Linux a progressivement utilisé le mécanisme folio pour remplacer certaines des anciennes méthodes de gestion d'une seule page afin de gérer plus efficacement les tâches de gestion de la mémoire. Comment réduire la surcharge causée par le comptage des références de folio est donc devenu une tâche importante dans l'optimisation des performances du noyau.
D'un point de vue technique, ce type d'optimisation ne supprime pas simplement le comptage de références. Le noyau doit toujours garantir que les objets mémoire ne sont pas libérés prématurément lors de leur accès, et ne doit pas introduire de corruption de données ou de problèmes de sécurité de la mémoire en réduisant les opérations de synchronisation. Par conséquent, les correctifs doivent trouver un équilibre entre l’exactitude, la sécurité des accès simultanés et les performances.
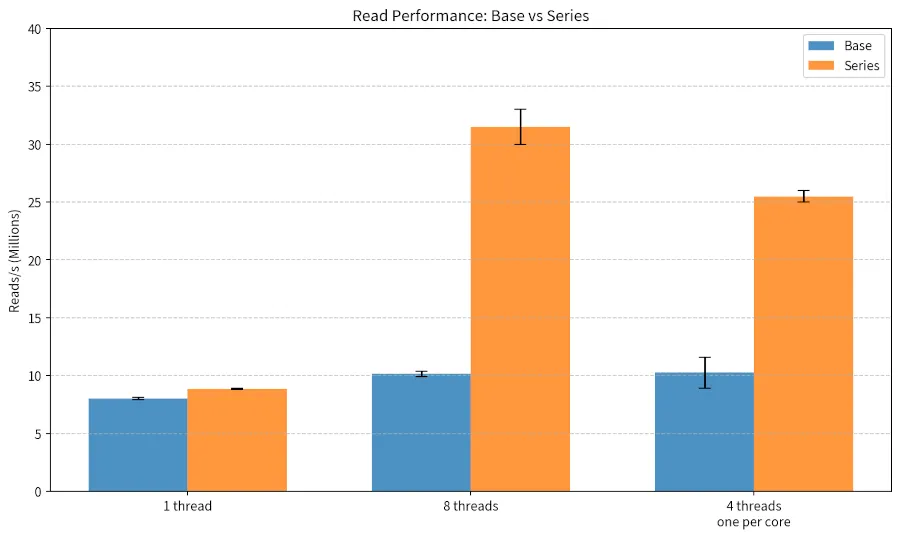
Cette optimisation a entraîné des changements de performances assez importants sous la charge de travail cible. Le test vise principalement le scénario dans lequel plusieurs threads lisent simultanément de petits morceaux de données du même fichier, ce qui correspond au problème de concurrence que le correctif tente de résoudre.
Cependant, ces résultats doivent être compris comme des performances dans des conditions de test spécifiques, et ne signifient pas que toutes les opérations sur les fichiers sous Linux bénéficieront de la même amélioration. Les avantages réels dépendent des modèles d'accès de votre application, du nombre de threads, de la taille du fichier, du périphérique de stockage, de la configuration de la mémoire et d'autres facteurs système. Les effets d'optimisation peuvent être limités pour les charges de travail qui n'impliquent pas les mêmes problèmes de contention.
Actuellement, ces correctifs sont toujours stockés dans la branche Git personnelle de Torvalds, et on ne peut pas conclure qu'ils sont officiellement entrés dans le noyau principal Linux. La question de savoir si elle sera fusionnée à l'avenir et quelle méthode de mise en œuvre sera finalement adoptée nécessite une observation plus approfondie.
Selon le rythme de développement actuel, cette série de correctifs pourrait entrer dans une phase de discussion ou de révision plus approfondie lors de la prochaine fenêtre de fusion de Linux 7.4, mais sa possibilité de fusion dépend toujours de la révision du code, des résultats des tests et du jugement du responsable.
Il convient de noter que l'utilisation par Torvalds de Claude Code n'est pas sa première tentative d'utiliser l'intelligence artificielle pour gérer les travaux de développement liés à Linux.
Auparavant, il a parlé de l'utilisation du débogage du noyau assisté par l'IA et a essayé des outils de programmation d'IA tels que Google Antigravity en dehors du noyau Linux. Pour Torvalds, l’IA ne consiste pas à remplacer les développeurs en tant que décideurs indépendants, mais plutôt à devenir un outil de développement pouvant être utilisé avec des objectifs clairs et une supervision humaine.
Depuis cette année, les outils de programmation d'intelligence artificielle entrent progressivement dans le processus de développement de logiciels open source. De plus en plus de développeurs exploitent de grands modèles de langage pour analyser le code, localiser les bogues, écrire des tests et générer des correctifs initiaux. La communauté du noyau Linux constate également un nombre croissant de rapports de code et de bogues assistés par l'IA.
Cette tendance apporte à la fois des opportunités et des défis. D’une part, l’IA peut aider les développeurs expérimentés à explorer plus rapidement des chemins de code complexes, à proposer des idées d’optimisation et à réduire le temps nécessaire à l’écriture de code répétitif. D'un autre côté, un grand nombre de correctifs et de rapports de bogues générés automatiquement augmentent également la charge de révision des responsables, et certaines soumissions peuvent présenter des problèmes de mauvaise qualité, des soumissions en double ou un manque de valeur réelle.
Torvalds a déjà déclaré publiquement qu'il pensait que l'IA était un outil utile, mais que la communauté du noyau devait faire face à la pression de travail causée par l'augmentation rapide du contenu généré par l'IA. Il ne préconise pas de rejeter le code simplement parce qu'il utilise l'IA, mais accorde davantage d'attention à la qualité, à l'exactitude et à l'effet réel du code final.
Le projet d'optimisation du noyau auquel Claude Code a participé cette fois reflète une méthode d'application plus spécifique du développement assisté par l'IA : les développeurs qui connaissent les mécanismes internes du noyau identifient les problèmes, proposent des directions d'optimisation et supervisent la mise en œuvre, puis vérifient les résultats par des tests et une révision du code.
Contrairement au fait de s'appuyer uniquement sur l'IA pour générer automatiquement l'intégralité du projet logiciel, le développement du noyau Linux implique des mécanismes de concurrence complexes, des exigences de sécurité de la mémoire et un comportement matériel. Toute modification apparemment simple peut affecter un grand nombre d’applications et différentes plates-formes matérielles. Par conséquent, même si l’IA peut aider à générer du code, les développeurs doivent toujours comprendre son fonctionnement et assumer la responsabilité de la mise en œuvre finale.
Si cet ensemble de correctifs réussit finalement l'examen et entre dans la ligne principale de Linux, il deviendra un autre cas de développement assisté par l'IA participant à l'optimisation du logiciel système sous-jacent. Sa valeur réside non seulement dans les améliorations de performances pouvant être obtenues dans des scénarios spécifiques, mais également dans la démonstration de la manière dont de grands modèles de langage peuvent aider les ingénieurs expérimentés à analyser et à améliorer des systèmes complexes.
À mesure que les outils de programmation d'IA continuent de se développer, d'autres travaux similaires pourraient apparaître à l'avenir dans le noyau Linux et d'autres grands projets open source. Cependant, ce qui déterminera si ces réalisations peuvent réellement être mises en œuvre sera toujours une vérification technique stricte, un examen par la communauté et des exigences à long terme en matière de stabilité du système.
Commentaires