
Résumé :
Bien qu'il ait déjà été rapporté sur le marché que NVIDIA prévoyait de réduire la configuration HBM de l'accélérateur Rubin AI de nouvelle génération d'une pile à 12 couches à une pile à 8 couches, les dernières nouvelles de la chaîne d'approvisionnement montrent que les produits de la série Rubin devraient toujours être dominés par des solutions HBM4 à 12 couches, et le marché de la mémoire à large bande passante pourrait être confronté à une nouvelle série d'augmentations de prix substantielles.
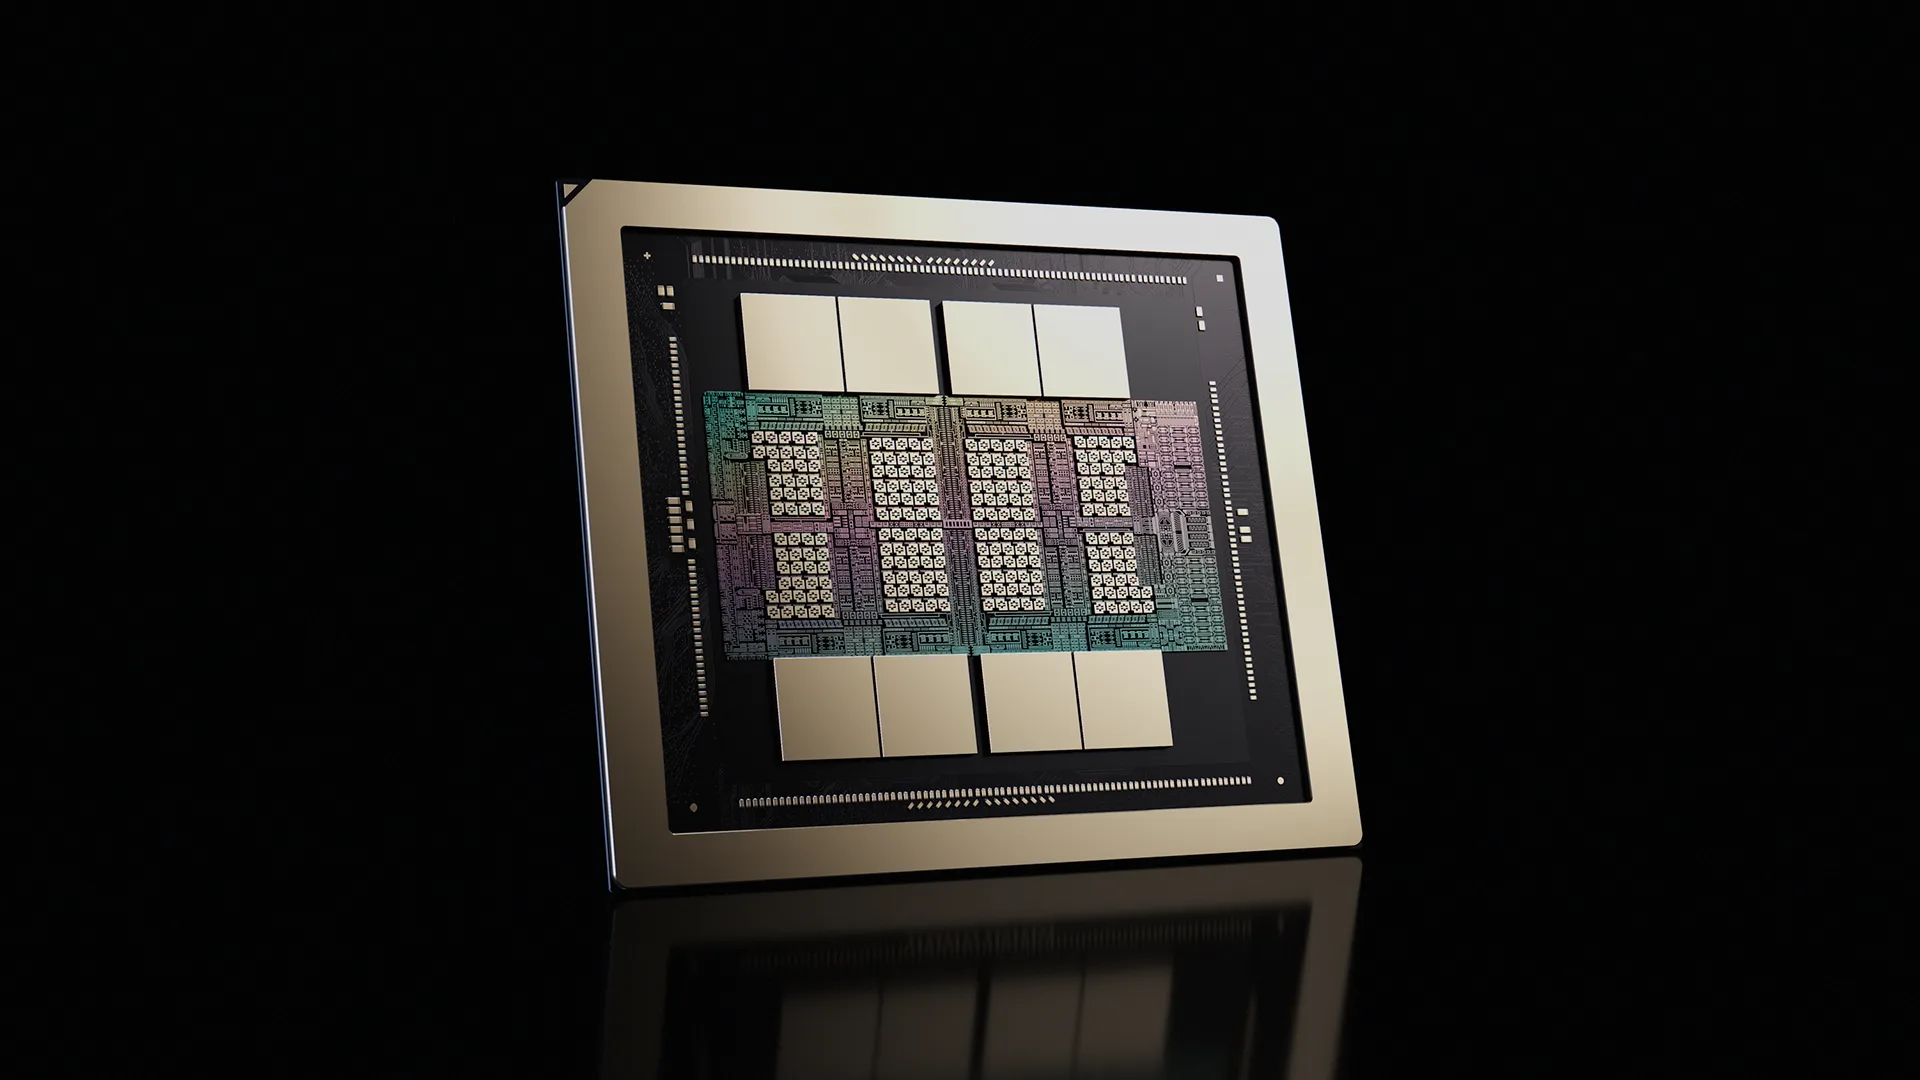
Selon les résultats d'une enquête sur la chaîne industrielle cités par Counterpoint Research, la grande majorité des produits d'architecture Rubin conserveront toujours la conception HBM4 empilée à 12 couches initialement prévue. Ceci est différent des rumeurs précédentes selon lesquelles Nvidia se préparerait à passer à grande échelle à une configuration HBM4 à 8 couches.
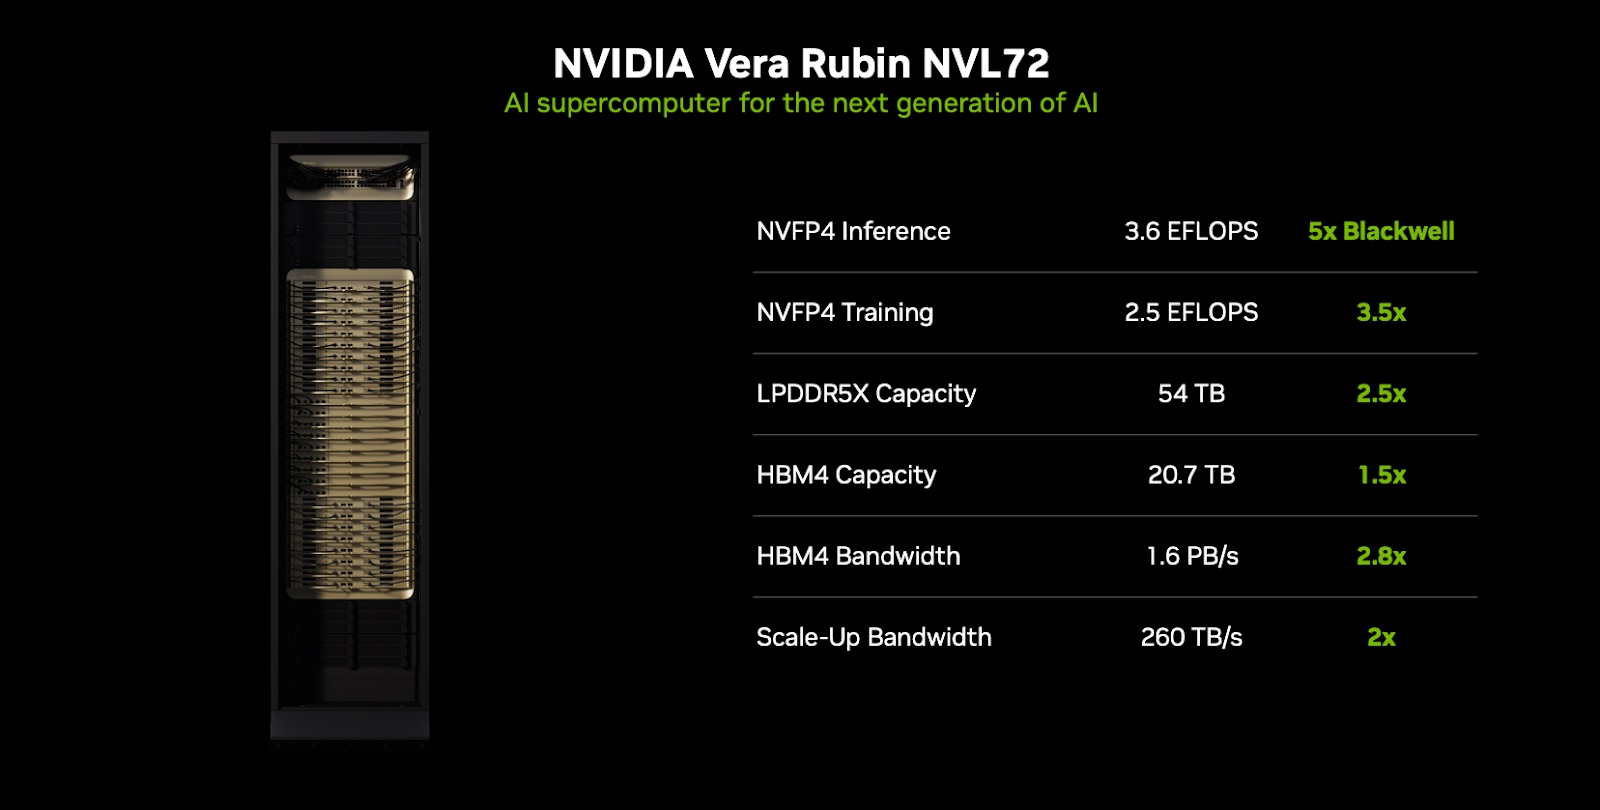
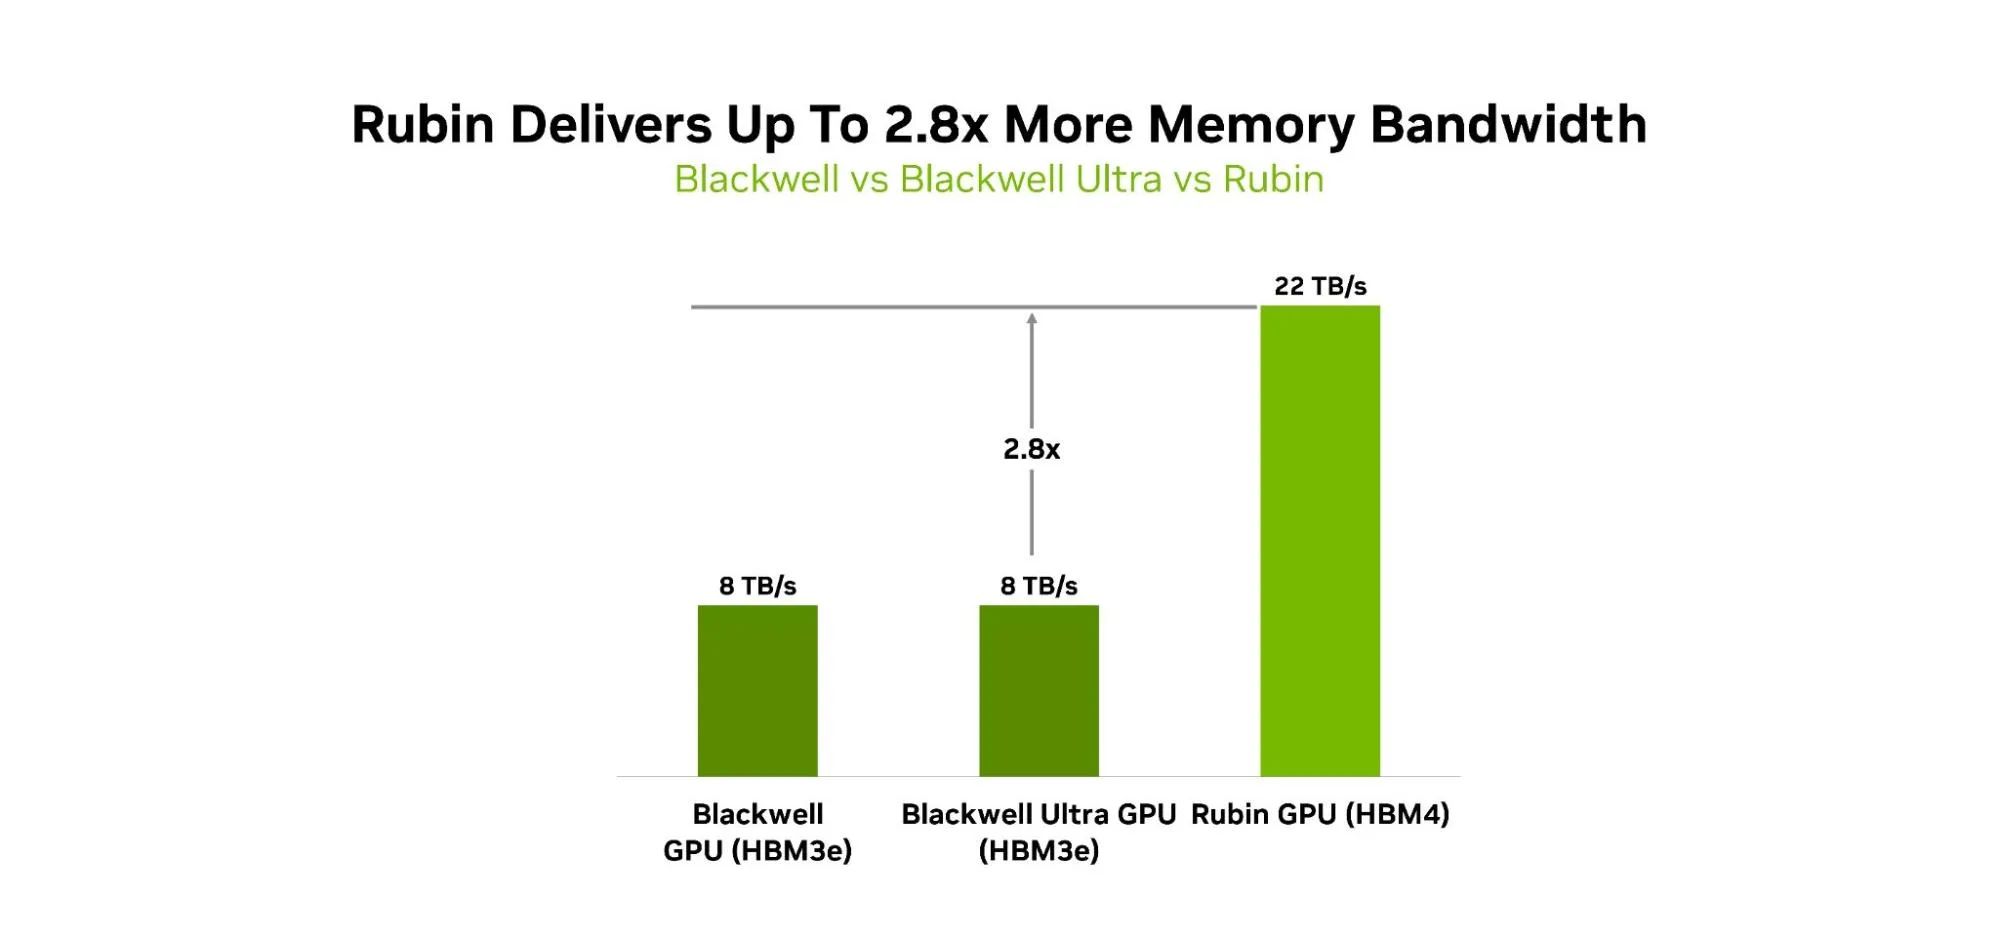
Selon la feuille de route technique officielle de NVIDIA, le GPU Rubin sera équipé de 12 couches de mémoire HBM4 empilée. Un seul GPU a une capacité de mémoire maximale de 288 Go et peut atteindre une bande passante mémoire allant jusqu'à 22 To/s. Pour les tâches actuelles de formation et d’inférence de modèles de langage à grande échelle, la capacité de mémoire et la bande passante restent des indicateurs clés qui déterminent les performances. Par conséquent, l’industrie estime que Nvidia n’est guère incité à faire des compromis sur les spécifications de base.
Les médias coréens ont précédemment rapporté que Nvidia avait demandé à Samsung Electronics et SK Hynix d'augmenter la fourniture de produits HBM4 à 8 couches. Les principales raisons incluent le rendement de fabrication, le contrôle de la dissipation thermique et la pression sur la chaîne d’approvisionnement. Étant donné que HBM4 augmente la largeur de l'interface mémoire à 2 048 bits et nécessite un empilement vertical de 12 couches de puces DRAM, sa complexité de fabrication est bien supérieure à celle des générations de produits précédentes.
Cependant, les dernières nouvelles soulignent que ces deux affirmations ne sont pas nécessairement contradictoires. Les initiés de l'industrie pensent que Nvidia pourrait utiliser le HBM4 à 8 couches dans certains produits pour atténuer la pression sur la capacité de production, mais le principal produit Rubin destiné au marché de l'IA haut de gamme conservera toujours la configuration HBM4 à 12 couches.
Dans le même temps, des défis plus importants proviennent de la situation de l'offre et de la demande sur le marché HBM. Alors que l’infrastructure de l’intelligence artificielle continue de se développer, HBM est devenue l’une des ressources les plus rares de l’industrie mondiale des semi-conducteurs.
Le cabinet d'études de marché TrendForce prédit que d'ici 2027, le prix de vente moyen des produits de mémoire à large bande passante pourrait augmenter de 121 % sur un an. La principale raison de la hausse des prix n’est pas la pénurie d’offre au sens traditionnel du terme, mais l’amélioration de la structure des produits. À mesure que le HBM4, plus cher, remplacera progressivement le HBM3E et que les produits HBM4E ultérieurs entreront sur le marché, le prix de vente moyen global augmentera considérablement.
L'institut de recherche a en outre souligné que même si NVIDIA étendait l'utilisation du HBM4 à 8 couches, il ne serait peut-être pas en mesure de réduire les coûts de mémoire. Étant donné que chaque pile HBM nécessite la configuration de puces logiques de base coûteuses (Base Dies), lorsque le nombre de couches d'empilement est réduit de 12 à 8, le coût des mêmes puces de base doit être réparti sur moins de couches de stockage, ce qui peut entraîner une augmentation des coûts de capacité unitaire.
Les données montrent que d'ici 2027, le prix par Go de capacité des produits HBM à 8 couches pourrait même être de 10 à 20 % plus élevé que celui des produits HBM à 12 couches. Cela signifie que le principal avantage de la réduction du nombre de couches d’empilage pourrait être d’améliorer la capacité d’approvisionnement et l’efficacité de la production, plutôt que de réduire directement les coûts d’approvisionnement.
Les analystes estiment qu'à mesure que l'intelligence artificielle générative, la formation de grands modèles et la construction de centres de données IA entrent dans une nouvelle étape, la demande du marché en mémoire à large bande passante continue de croître rapidement. Pour NVIDIA, le maintien de la configuration HBM4 à 12 couches signifie des difficultés de fabrication et des coûts d'approvisionnement plus élevés, mais cela peut garantir que la plate-forme Rubin continue de bénéficier d'avantages en matière de bande passante et de capacité mémoire de pointe.
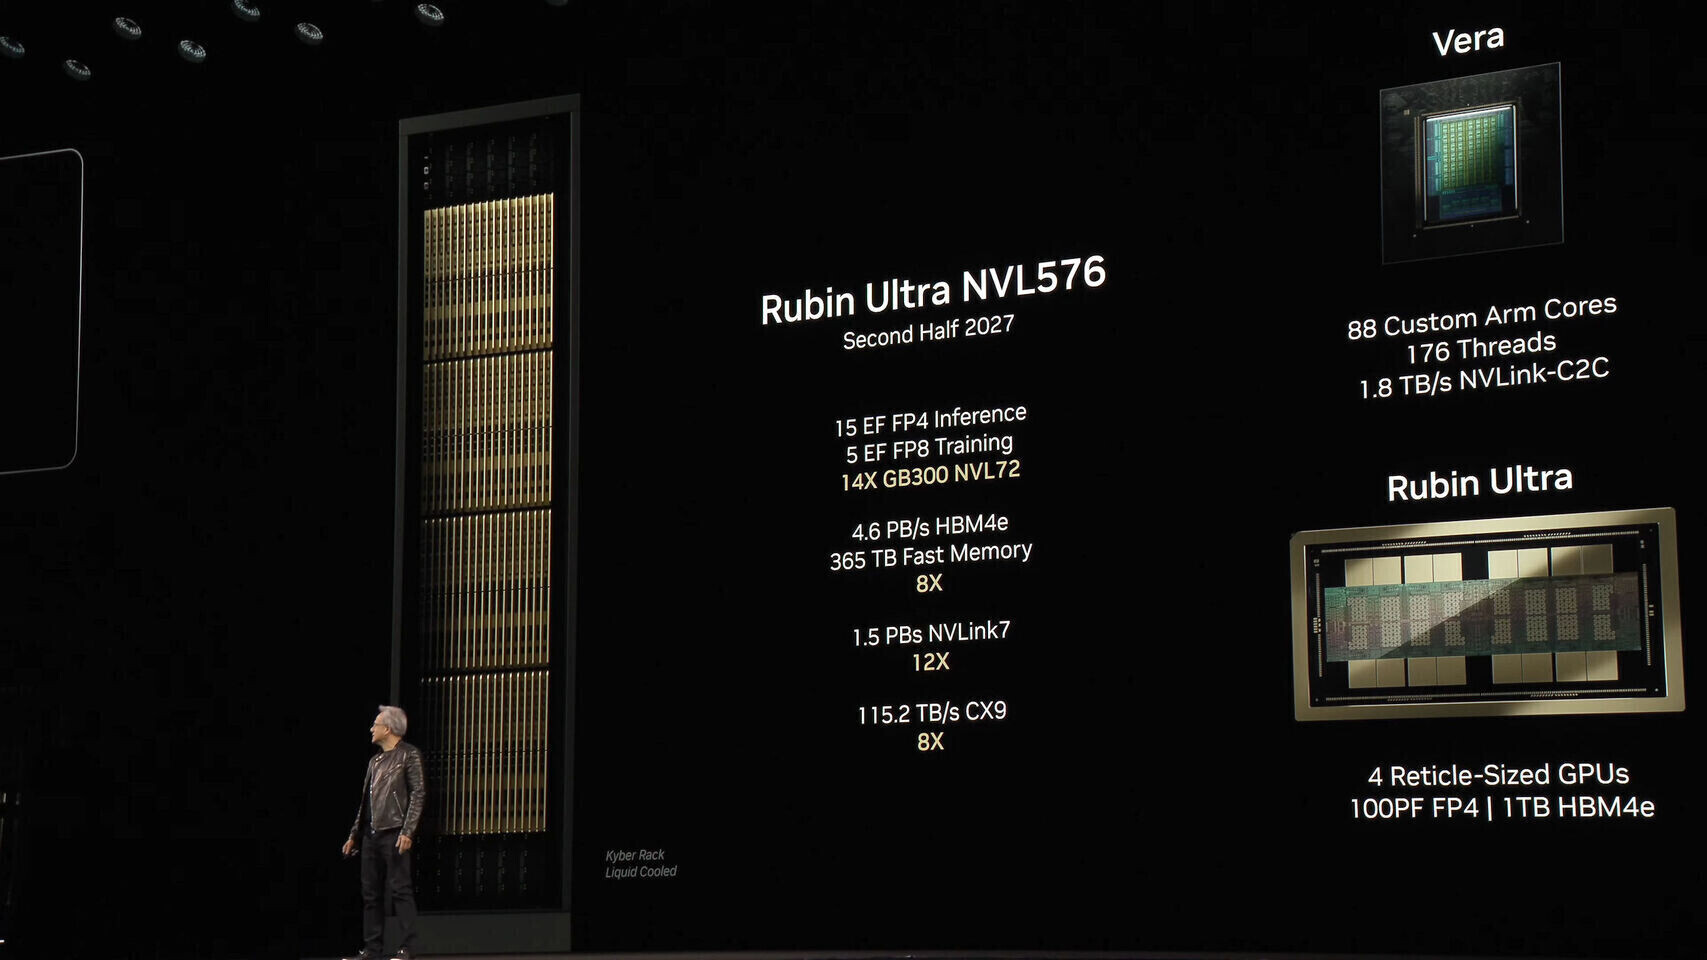
Alors que la plate-forme Rubin devrait entrer sur le marché en 2027, la concurrence entre les puces d'IA hautes performances et la chaîne d'approvisionnement HBM pourrait encore s'intensifier, et la mémoire à large bande passante devient l'un des facteurs clés affectant le coût de l'infrastructure d'IA de nouvelle génération.
Commentaires