
Résumé :
Récemment, un étrange problème de contrôle des risques est survenu dans la recherche Google. Lorsque les utilisateurs cliquent sur une entrée de résultat de recherche, ils peuvent accéder automatiquement à la page « Vérification de votre demande ». Cette page devra peut-être attendre plusieurs secondes, voire dix secondes, pour se terminer. Une fois la vérification terminée, vous pouvez accéder à la page finale. Il existe d'autres utilisateurs qui ont rencontré de tels problèmes dans la communauté officielle de Google.
Depuis que Google a commencé à chiffrer l'adresse des résultats de recherche et à la remplacer par /goto/ jump page, les utilisateurs ne peuvent qu'attendre avant que Google termine la vérification. Auparavant, comme Google ne chiffrait pas le lien, le clic sautait sans aucune attente.
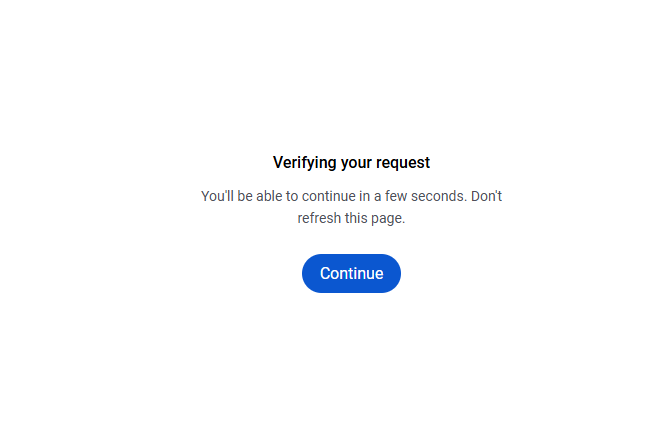
Cliquer sur les résultats de recherche doit d'abord être vérifié par le serveur Google :
À en juger par les commentaires des utilisateurs, le contrôle des risques actuellement mis en œuvre par Google prendra différentes mesures en fonction du comportement des utilisateurs. Par exemple, lorsqu'un utilisateur utilise Chrome et n'est pas connecté à un compte Google, il rencontre fréquemment une page de vérification lorsqu'il clique sur les résultats de recherche. La page de vérification est la page du milieu /goto/. La vérification est parfois rapide mais nécessite parfois une longue attente.
D'autres utilisateurs ont signalé que le contrôle des risques ne serait pas déclenché en cliquant sur un petit nombre de résultats de recherche, mais le contrôle des risques a commencé à apparaître lorsque plusieurs résultats de recherche étaient rapidement cliqués, et la page intermédiaire de vérification a finalement terminé la vérification après une attente de 12 secondes. Si l’utilisateur utilise une IP proxy, ne se connecte pas à un compte Google et utilise une autre marque de navigateur, la situation de contrôle des risques rencontrée est également différente.
L'analyse montre que la vérification est fausse, mais elle attend en réalité le compte à rebours :
Resoneo, une société de technologie de recherche, a testé ce mécanisme et a découvert que la page dite intermédiaire de vérification exécute en fait un compte à rebours, puis se relâche et saute une fois le compte à rebours terminé. Bien que le texte de la page utilise le mot vérification, l'expérience réelle vécue par l'utilisateur est plus proche d'une attente forcée.
La situation réelle peut être que Google ait collecté le comportement d'accès de l'utilisateur via la page intermédiaire /goto/, puis l'ait soumis au serveur. Le serveur renvoie instantanément le temps d'attente en fonction des exigences de contrôle des risques et l'envoie à la page /goto/. La page sautera automatiquement une fois le temps d'attente écoulé.
À l'heure actuelle, Google n'a pas publié de réponse officielle à ce sujet, de sorte que la situation de contrôle des risques rencontrée par les différents utilisateurs, que la page intermédiaire soit réellement vérifiée ou que le temps d'attente obligatoire soit imposé, peut être différente. Cependant, les utilisateurs qui se connectent à un compte Google ou qui n'ouvrent pas fréquemment un grand nombre de pages sur une courte période de temps ont généralement une probabilité plus faible d'être confrontés à un contrôle des risques.
Il y a une forte probabilité que ce soit dans un but anti-IA et anti-reptile :
Auparavant, la page de résultats de recherche Google n'utilisait pas de pages intermédiaires de saut chiffrées. Autrement dit, tant que l'agent d'IA ou le robot d'exploration peut résoudre le contrôle des risques pendant la phase de lancement de la recherche Google, la page de résultats de recherche peut être explorée sur toute la page (mais elle doit à nouveau passer par le contrôle des risques en tournant la page).
Après le lancement de la page centrale /goto/, Google a transcodé l'adresse réelle des résultats de recherche via Base64, et Google aurait dû ajouter certains paramètres lors du transcodage. Par conséquent, l'adresse d'origine ne peut pas être restaurée après le décryptage direct du cryptage, les données doivent donc toujours être décryptées via le serveur Google lors de l'accès final.
L'approche de Google est plus susceptible de contrer l'IA et les anti-crawlers, ce qui rend plus difficile pour les outils d'IA d'explorer le contenu directement via la recherche Google. Bien entendu, il devient également difficile d’explorer les résultats de recherche directement via la recherche Google. Ce qui est encore plus gênant, c’est que ce mécanisme empêche également divers sites Web d’analyse de données SEO de capturer des données de manière stable, ce qui pose donc encore de nombreux problèmes.
Commentaires