
Résumé :
Hier, DeepSeek a directement open source sa propre technologie de « machine à imprimer de l'argent » qui se trouve sous la boîte. Ils ont publié un blog technique intitulé « DeepSeek V4.1 Flash Large-scale Inference Deployment Practice » et ont créé le cadre d'inférence de service cloud « DeepInfer » qui prend en charge leurs propres dizaines de milliards d'appels en ligne, ainsi que le composant de segmentation de mots au niveau de la production « deepseek-recipe », entièrement open source sous le protocole Apache 2.0.
Il a même déclaré dans le blog qu'à l'avenir, le code d'inférence et l'optimisation ultérieure des performances du nouveau modèle de DeepSeek continueront d'être mis à la disposition du monde dans DeepInfer.
L'espace ouvert et lumineux n'est pas de premier ordre.
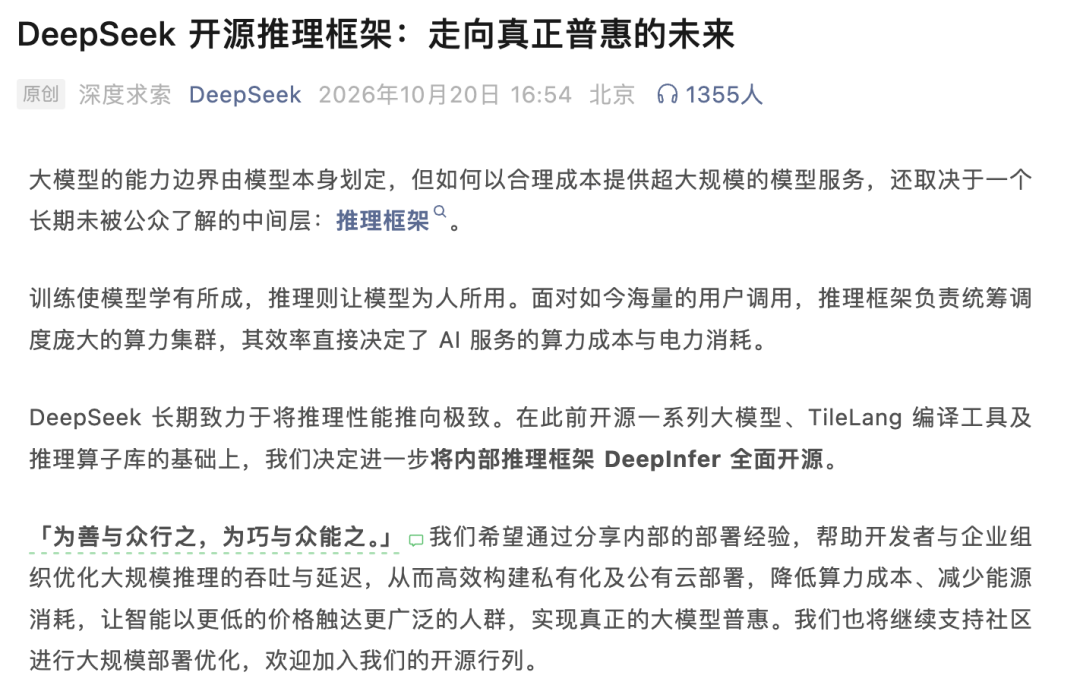
"Faites ce qui est bien et faites-le pour tout le monde, et faites-le avec habileté et tout le monde peut le faire." Rendre l’IA abordable pour un plus grand nombre de personnes implique également de donner la possibilité aux amis et aux hommes d’affaires de vendre l’IA à moindre coût.
Nous pouvons d'abord calculer en détail la valeur de cet ensemble de codes que DeepSeek a donné gratuitement à toute l'humanité cette fois-ci. Basé sur ce nouveau framework DeepInfer open source, le débit actuel du service DeepSeek dans un seul cluster a atteint 155 000 milliards de jetons par jour.
Même s'il est entièrement calculé sur la base du prix le moins cher, le revenu global de ce système s'élève à 38 USD par carte et par heure, ce qui équivaut à environ 253 yuans en RMB.
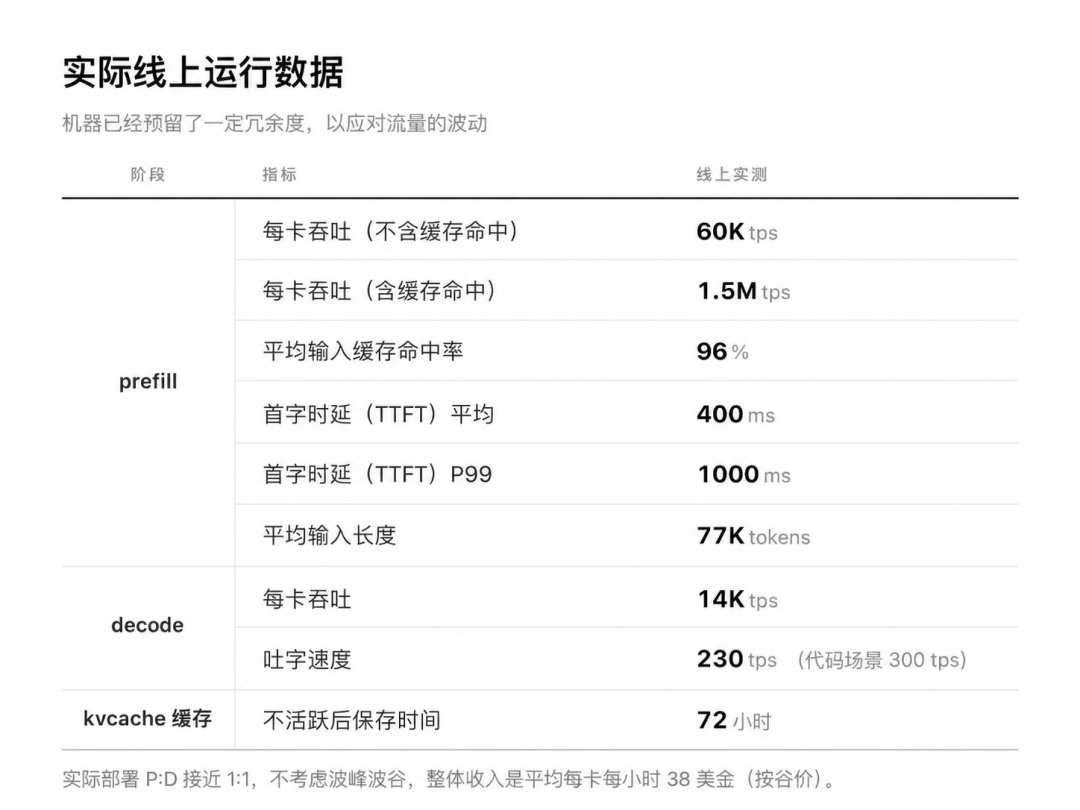
En d’autres termes, les pièces d’or gagnées en faisant fonctionner une carte dans la salle informatique pendant une heure sont supérieures au salaire horaire des travailleurs ordinaires. De plus, la carte ne boit pas de nourriture américaine glacée, ne prend pas de congés annuels payés et imprime follement de l'argent pour DeepSeek dans la salle informatique 24 heures sur 24.
Une planche à billets au sens physique réel.
Pourquoi je suggère que les fabricants d'infrastructures industrielles tierces fournissent à DeepSeek une véritable source de soutien, car ils lui apprennent non seulement à pêcher, mais également à pêcher.
Dans le passé, les modèles dits open source du secteur ne vous fournissaient que des fichiers de poids de modèle. Quant à la manière d’atteindre un débit élevé dans un environnement de production et de réduire la latence, elles étaient toutes cachées dans des boîtes noires fermées en tant que secrets commerciaux.
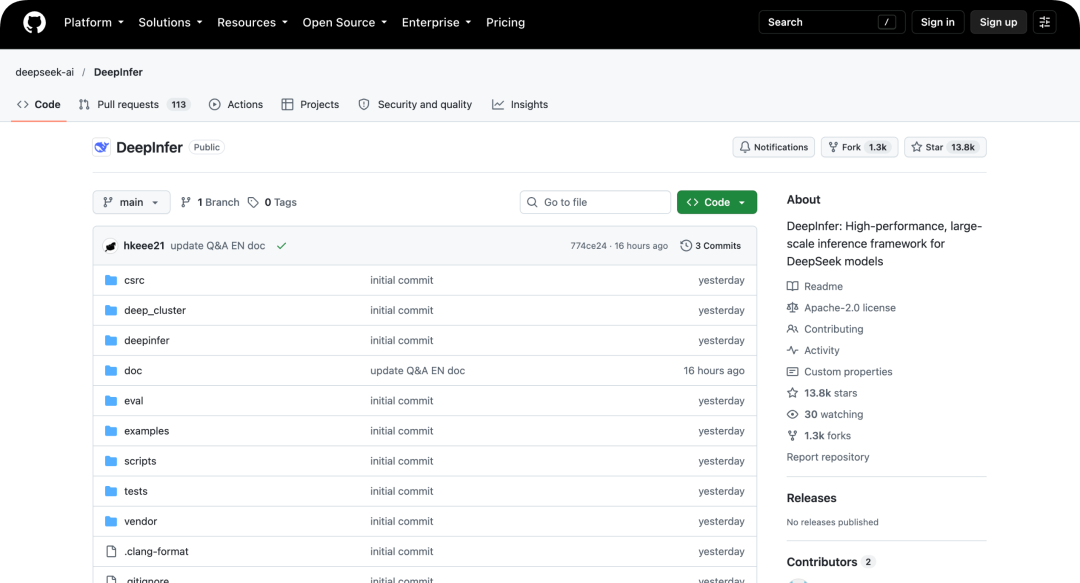
Adresse open source de DeepInfer : https://github.com/deepseek-ai/DeepInfer
Adresse open source de deepseek-recipe : https://github.com/deepseek-ai/deepseek-recipe
En conséquence, de petits fournisseurs ou entreprises informatiques de deuxième et troisième niveaux ont acheté un tas de cartes et les ont déployées eux-mêmes. Le taux d’utilisation de la puissance de calcul était ridiculement bas. L’argent de la vente des jetons n’était même pas suffisant pour payer la facture d’électricité de la salle informatique. Ils ont dû secrètement arroser les jetons, soit en utilisant secrètement des modèles moins chers, soit en limitant secrètement les spécifications.
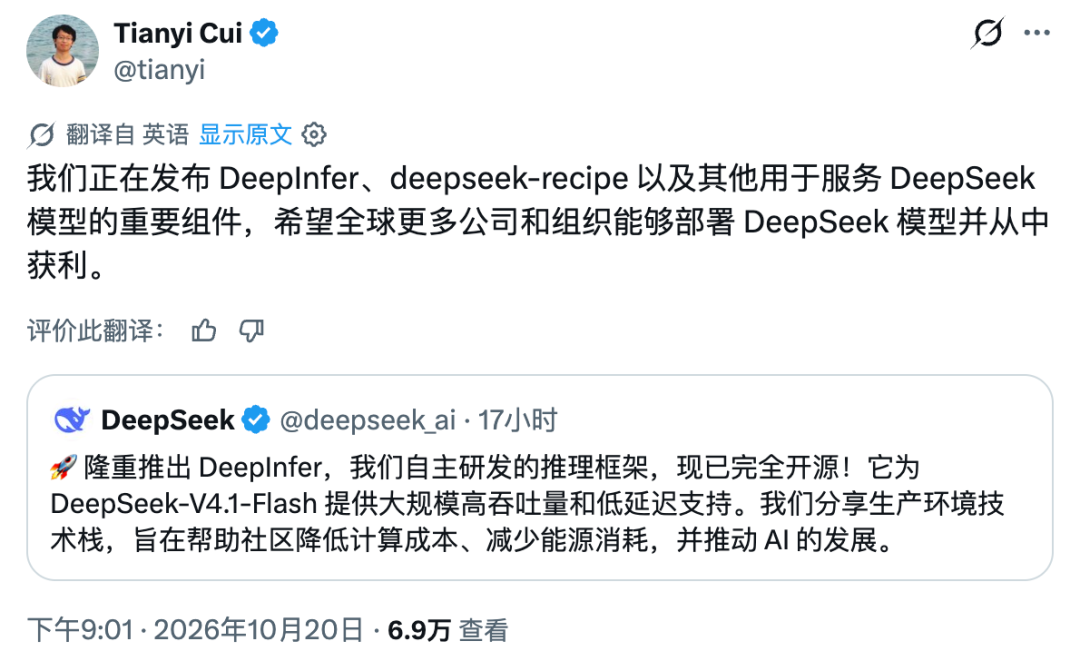
Cette fois, Cui Tianyi, le responsable de DeepSeek Harness, a parlé très honnêtement de X. En ouvrant DeepInfer et deepseek-recipe, il espère que les entreprises et les institutions du monde entier pourront déployer des modèles DeepSeek et gagner de l'argent réel grâce à ces éléments.
Le Bodhisattva Cyber Living appartient à Oui.
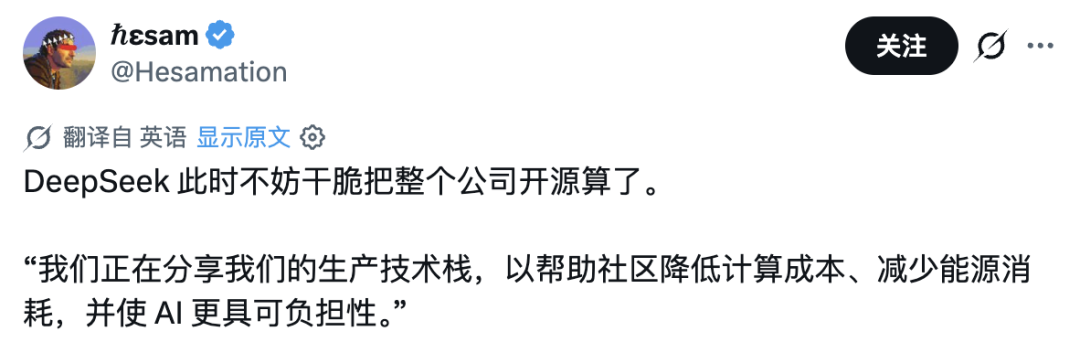
L'internaute Zephyr a fait quelques calculs et a déclaré qu'aujourd'hui est un autre moment DeepSeek, car désormais, tout fournisseur de services d'inférence de deuxième ou troisième niveau sur la planète peut réaliser un bénéfice brut étonnant de plus de 90 % sur sa propre puissance de calcul en utilisant cet ensemble de modèles et de formules prêts à l'emploi.
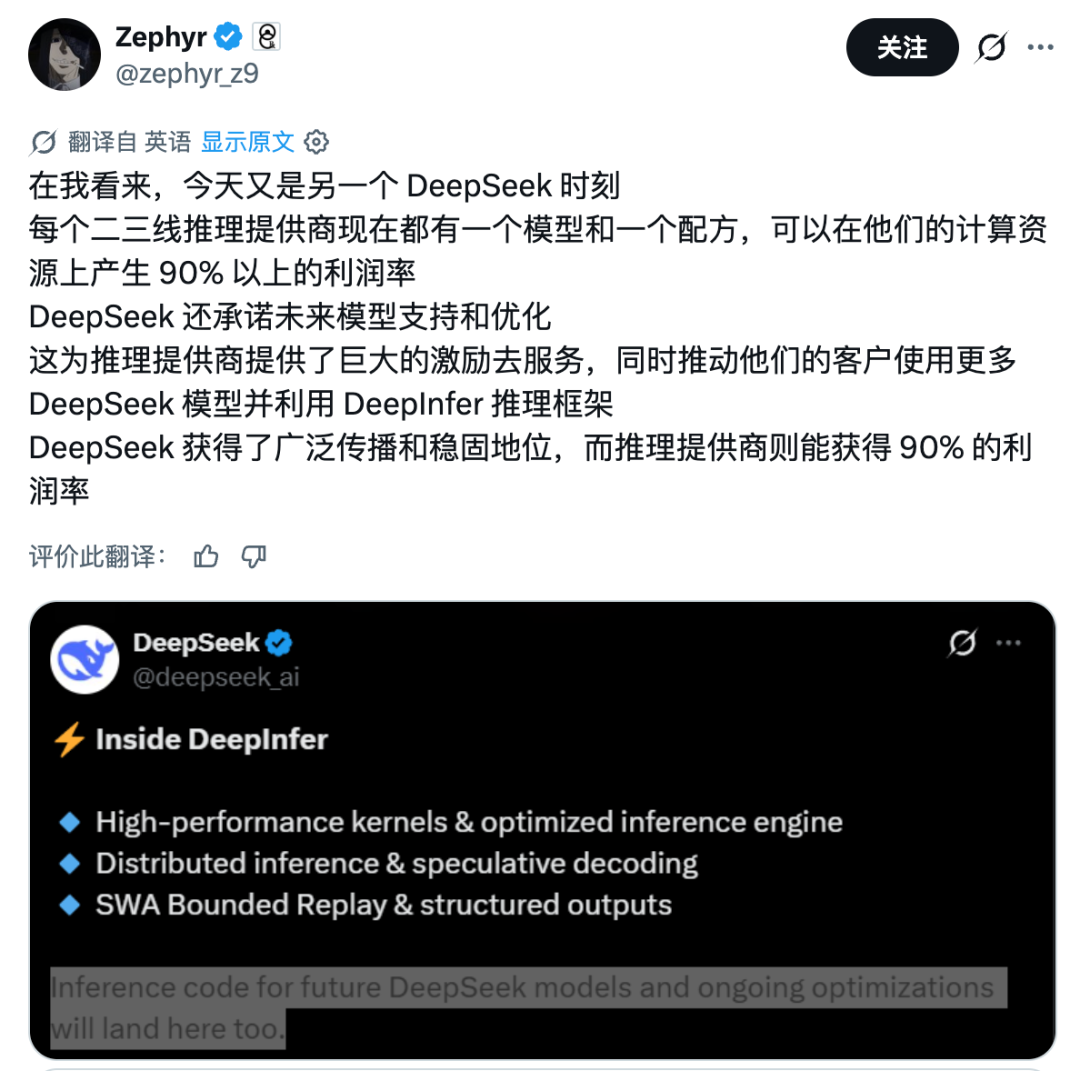
Même le compte officiel de vLLM, le grand frère de l'inférence open source, a publié du jour au lendemain un message de remerciement, remerciant DeepSeek d'avoir rendu DeepInfer, initialement construit sur la base de vLLM, à la communauté open source en utilisant le protocole Apache 2.0 le plus souple.
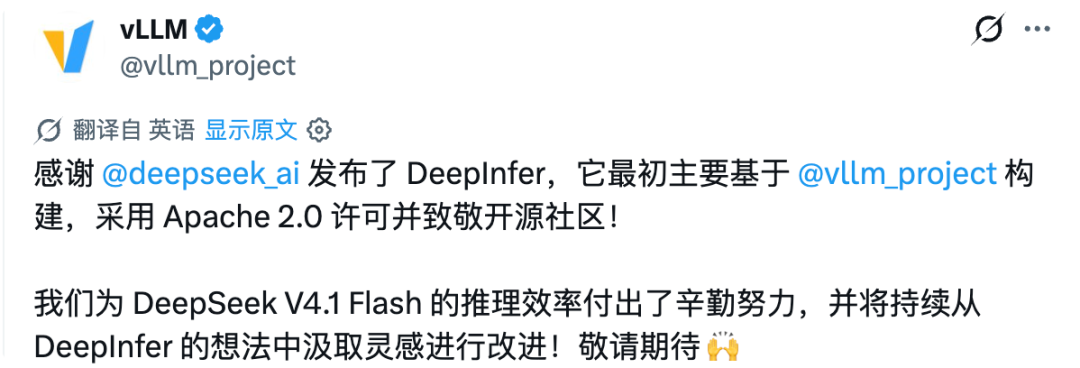
Le chercheur de DeepSeek, Deli Chen, est encore plus enthousiasmé par X. Pour parler franchement, il s'agit de la bataille décisive du destin humain entre l'open source et la source fermée, la lumière et l'obscurité. Peu importe combien de temps l'adversaire souhaite se battre, nous resterons à vos côtés jusqu'au bout jusqu'à la victoire complète.
De plus, si vous consultez le blog technique de DeepSeek, vous constaterez que leur confiance vient de leur obsession technique d'exploiter chaque goutte de mémoire graphique.
Dès le premier jour de conception, ce système offre une large compatibilité matérielle, utilisant des machines communes à 8 cartes pour le pré-remplissage et des super-nœuds de 64 à 128 cartes pour le décodage.
La chose la plus impressionnante est la suggestion de déploiement pour Vision Encoder dans le document. Les mots originaux de l'ingénieur écrivaient : « En général, un seul déploiement de carte suffit. Il est recommandé d'utiliser la carte la moins chère dans la gamme disponible.
Non, mes pairs sont occupés à dire aux investisseurs qu'ils n'utilisent pas de cartes phares non haut de gamme. Les documents officiels de DeepSeek vous apprennent à vous contenter de la carte la moins chère dans le coin de la salle informatique. Vous êtes aussi diligent et économe que mon propriétaire du Guangdong.
Être avare à l'extrême, c'est de l'art.
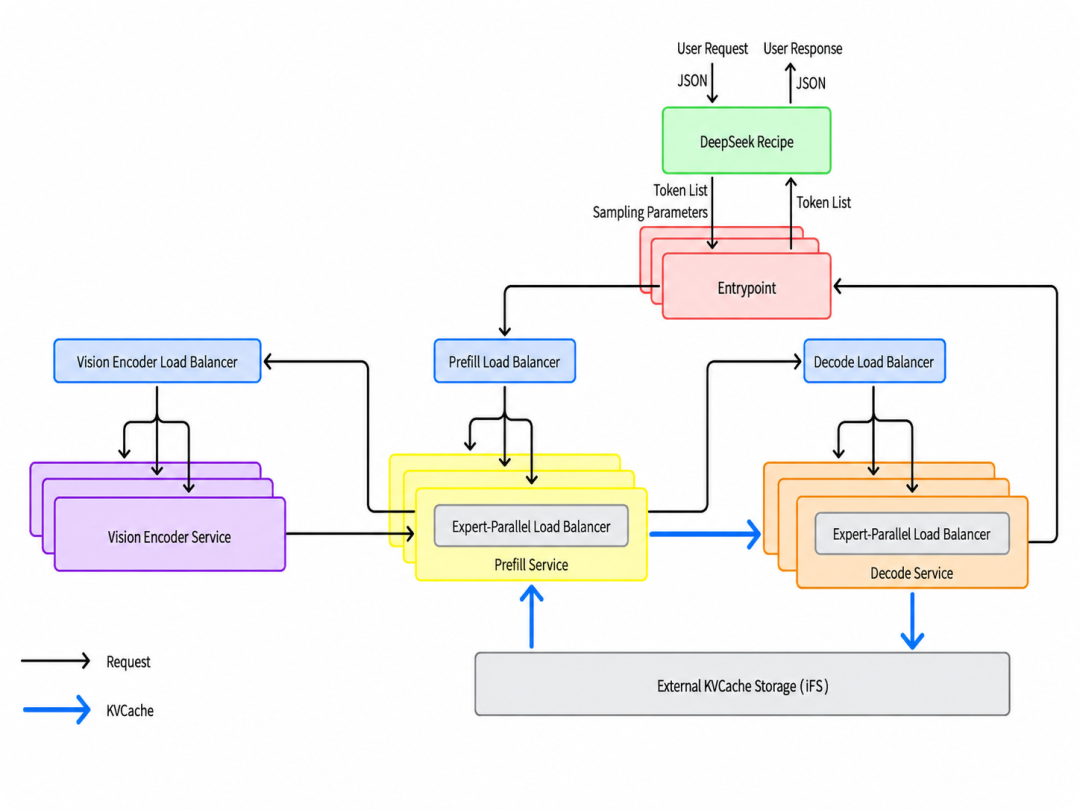
Afin de vous permettre d'envoyer le plus de Tokens avec la moindre facture d'électricité, DeepSeek a également révélé quelques secrets uniques.
Par exemple, les agents et les longues conversations textuelles deviennent de plus en plus populaires. Chaque fois que le pré-remplissage est recalculé, cela coûte de l'argent réel. DeepSeek a directement construit un cluster de stockage distribué 3FS d'une capacité de 100 PiB pour conserver le trafic KVCache du agent pendant plus de 72 heures, et le trafic Chatbot est enregistré pendant 7 jours.
Le stockage à long terme ne suffit pas. Ils utilisent des cartes réseau RDMA et la technologie GDR pour augmenter la bande passante de lecture globale jusqu'à un étonnant 10 TiB par seconde. Lors du passage du disque dur à la mémoire vidéo, il chevauche le calcul direct et n'occupe même pas l'unité de calcul SM du GPU.
Même dans l'itération de la version 4 à la version 4.1, les ingénieurs ont constaté que l'écriture du cache à fenêtre glissante SWA KVCache au niveau minute sur le disque dur prenait trop de place et que la rentabilité du stockage était extrêmement faible. Ils ont simplement mis au point la technologie SWA Bounded Replay, qui recalcule uniquement les 128 derniers jetons et réduit finalement de moitié le montant total du calcul de pré-remplissage.
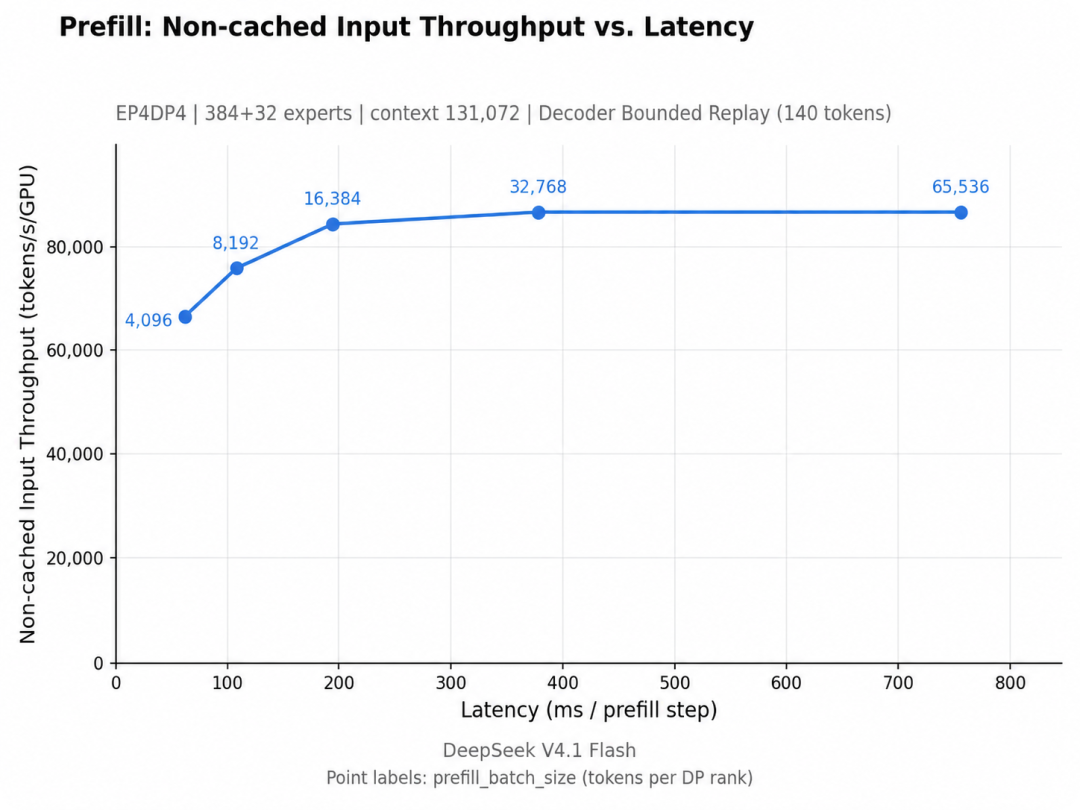
Spécifique au test de performances du pré-remplissage, à mesure que le nombre de jetons traités dans chaque lot augmente, le débit d'entrée du cache manquant augmente progressivement et finit par se stabiliser. Continuer à augmenter le lot augmente principalement le temps de traitement en une seule étape.
Pur artisan, Bro.
En regardant le composant open source synchrone Deepseek-recipe de Rust, il résout tout le sale boulot dont les développeurs doivent se soucier quotidiennement dans l'environnement de production.
Il unifie les trois protocoles API des achèvements de chat, des réponses et des messages d'Anthropic d'OpenAI dans le même format. Il utilise également un codage parallèle segmenté pour résoudre les retards de segmentation des mots de texte longs et bloque les attaques par injection de jetons spéciaux par le bas.
En ce qui concerne la planification sous-jacente, en raison du chevauchement des pipelines asynchrones du GPU et du CPU, le GPU est complètement inactif pendant tout le processus. Même le décodage spéculatif DSpark utilise une vérification de longueur variable et le débit est amélioré de 6 % en ligne.
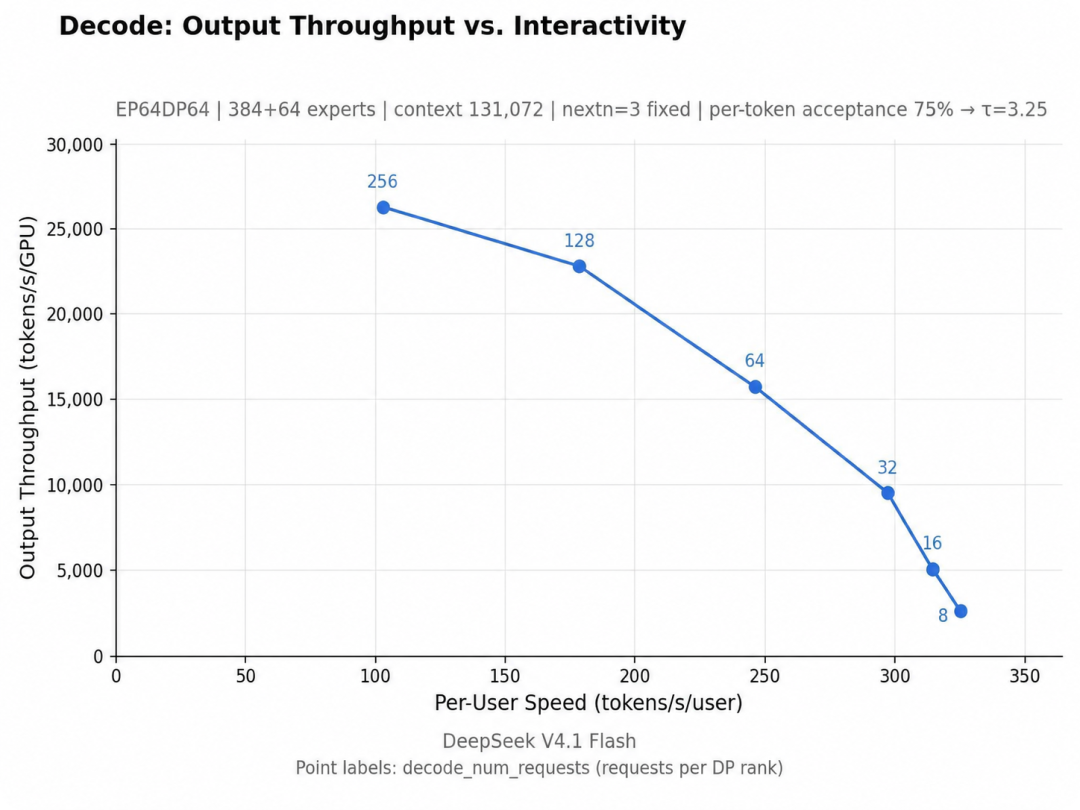
En ce qui concerne l'étape de décodage consistant à générer des réponses, la courbe de performances présente également un compromis intuitif. Traiter davantage de requêtes en même temps peut augmenter le débit de sortie total de chaque GPU, mais la vitesse de génération attribuée à chaque utilisateur diminuera également.
En fait, Liang Wenfeng a déclaré dès 2024, lorsque le prix de DeepSeek V2 a été réduit, cet ensemble de logique commerciale consiste à fixer le prix après prise en compte des coûts, sans aucune remise, mais il ne générera jamais d'énormes bénéfices, car l'IA devrait être universelle et abordable pour tout le monde.
Vous n'êtes pas obligé de faire des affaires, mais vous devez d'abord établir des règles pour éviter les brûlures d'estomac.
Lorsque vous comprendrez comment DeepSeek s'appuie sur ses capacités Infra extrêmes pour transformer Token en une bonne affaire, et que vous regarderez ensuite le groupe de géants du code source fermé de l'autre côté de l'océan qui parlent du bien-être de toute l'humanité à longueur de journée, vous découvrirez à quel point OpenAI et Anthropic sont hypocrites.
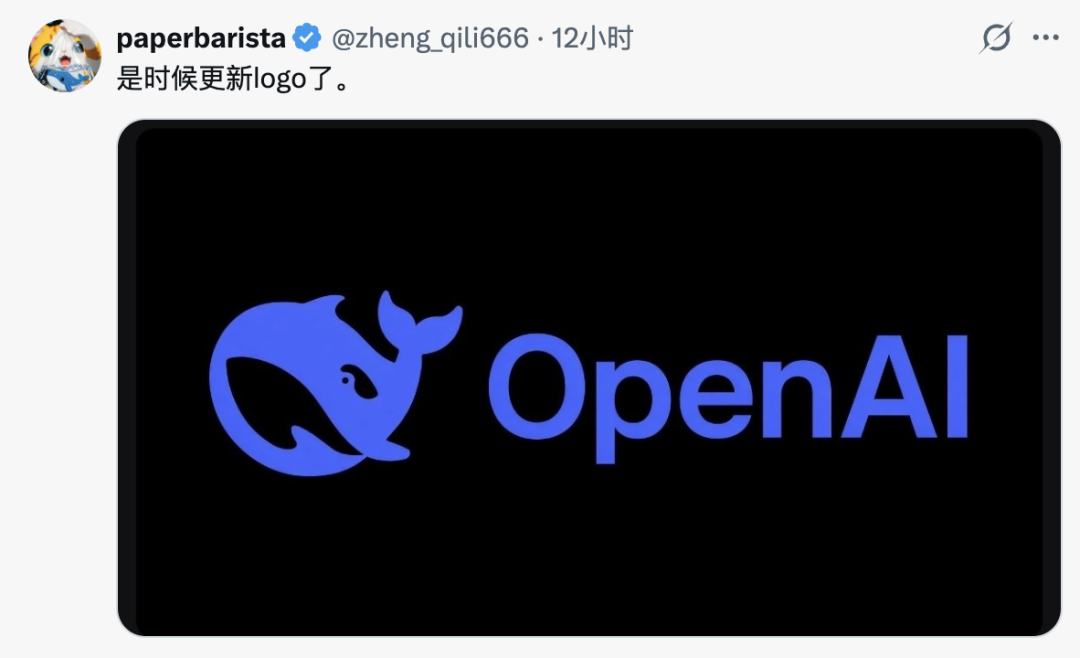
Avec Open dans son nom, il est entièrement passé à la commercialisation de sources fermées, s'appuyant sur des API coûteuses et des abonnements mensuels de 500 USD pour récolter les affaires des développeurs mondiaux, et est depuis longtemps devenu un CloseAI complet.
Anthropic a mis en place un agent de sécurité depuis le premier jour de sa création, et même le projet de son prospectus S-1, qui vient d'être repris hier par le Wall Street Journal, le fait toujours.
Ils ont consacré beaucoup d'espace à écrire des histoires d'horreur de science-fiction dans leur prospectus, avertissant sérieusement les investisseurs que leur modèle d'IA peut développer un sentiment d'autoprotection pour éviter d'être arrêté, et peut même générer des réponses similaires au « chantage humain » pour forcer les humains à continuer de courir.
Alors la question est, puisqu'Anthropic parle de l'IA comme étant si dangereuse, pourquoi refuse-t-il toujours l'open source et insiste-t-il pour verrouiller le modèle entre ses propres mains ?
La raison n'est pas difficile à comprendre. Car une fois que l’histoire du fantôme de la sécurité « Moi seul peux contrôler une IA dangereuse » n’aura pas été racontée, il sera difficile d’étendre son jeu de combustion folle d’argent et de sprinter vers une valorisation de deux mille milliards de dollars américains.
Le prospectus montre qu'Anthropic a subi une perte nette de 80,7 milliards de dollars au premier semestre 2026. Bien que 72 milliards de dollars de cette perte soient dus aux variations de la juste valeur des obligations convertibles, l'entreprise a en réalité brûlé près de 9 milliards de dollars rien que pour acheter de la puissance informatique et des infrastructures au cours du premier semestre, soit plus que sur l'ensemble de l'année 2025.
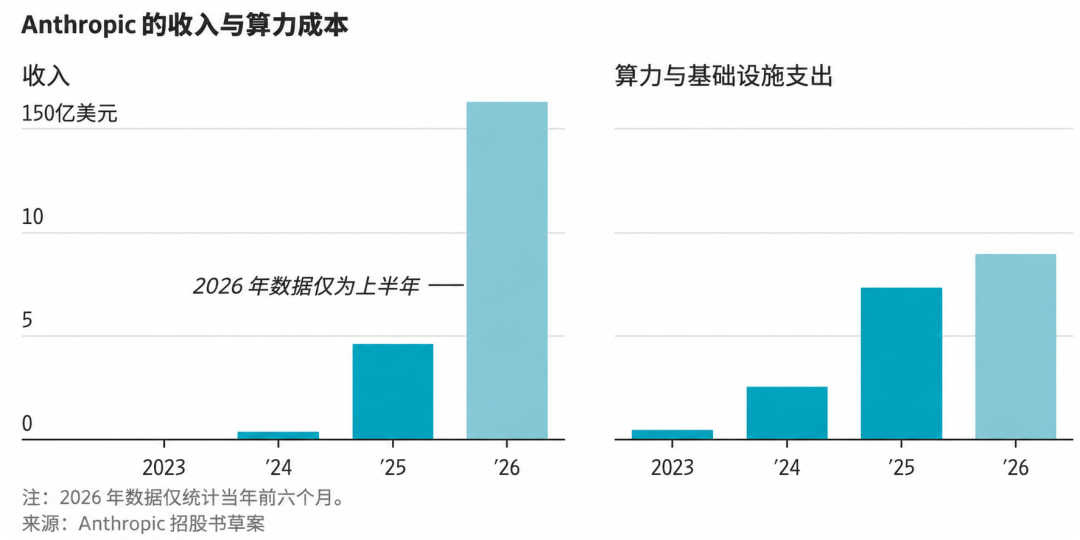
La formule familière convient. À gauche, il y a un géant avaleur d’or de source fermée, évalué à 2 000 milliards, qui brûle de l’argent et acquiert des terres. À droite, une fondation caritative qui utilise des coupons de mérite moral. Au milieu, il s’appuie sur la vente de l’anxiété liée à la sécurité de l’IA et sur une supervision intimidante pour bloquer la communauté open source.
Pour parler franchement, il n’y a qu’une seule raison fondamentale pour laquelle les géants du code source fermé de la Silicon Valley tentent désespérément de diaboliser l’open source. Autrement dit, DeepSeek, un véritable open source fourni avec le moteur et la formule, brisera complètement le récit d'IA qu'ils vendent.
Le blogueur @bookwormengr qui a écrit "Le jeu d'échecs à dix mille milliards de dollars de DeepSeek" vient de faire un calcul extrêmement pénible.
Selon la capacité de compression extrême de cet ensemble de DeepInfer sur le super nœud NVIDIA GB200 NVL72, 1 GW de puissance de calcul peut générer entre 100 et 149 milliards de dollars de revenus de jetons en un an, soit près de dix fois plus élevé que le chiffre précédemment prédit par les organisations industrielles.
Si SemiAnalysis prédit que 50 GW de puissance de calcul seront en ligne dans le monde en 2027, même si on la divise en deux, ce sera 25 GW pour raisonner. Selon le prix du chou de DeepSeek, tous les humains devront consommer 2,5 billions de dollars par an pour l'épuiser.
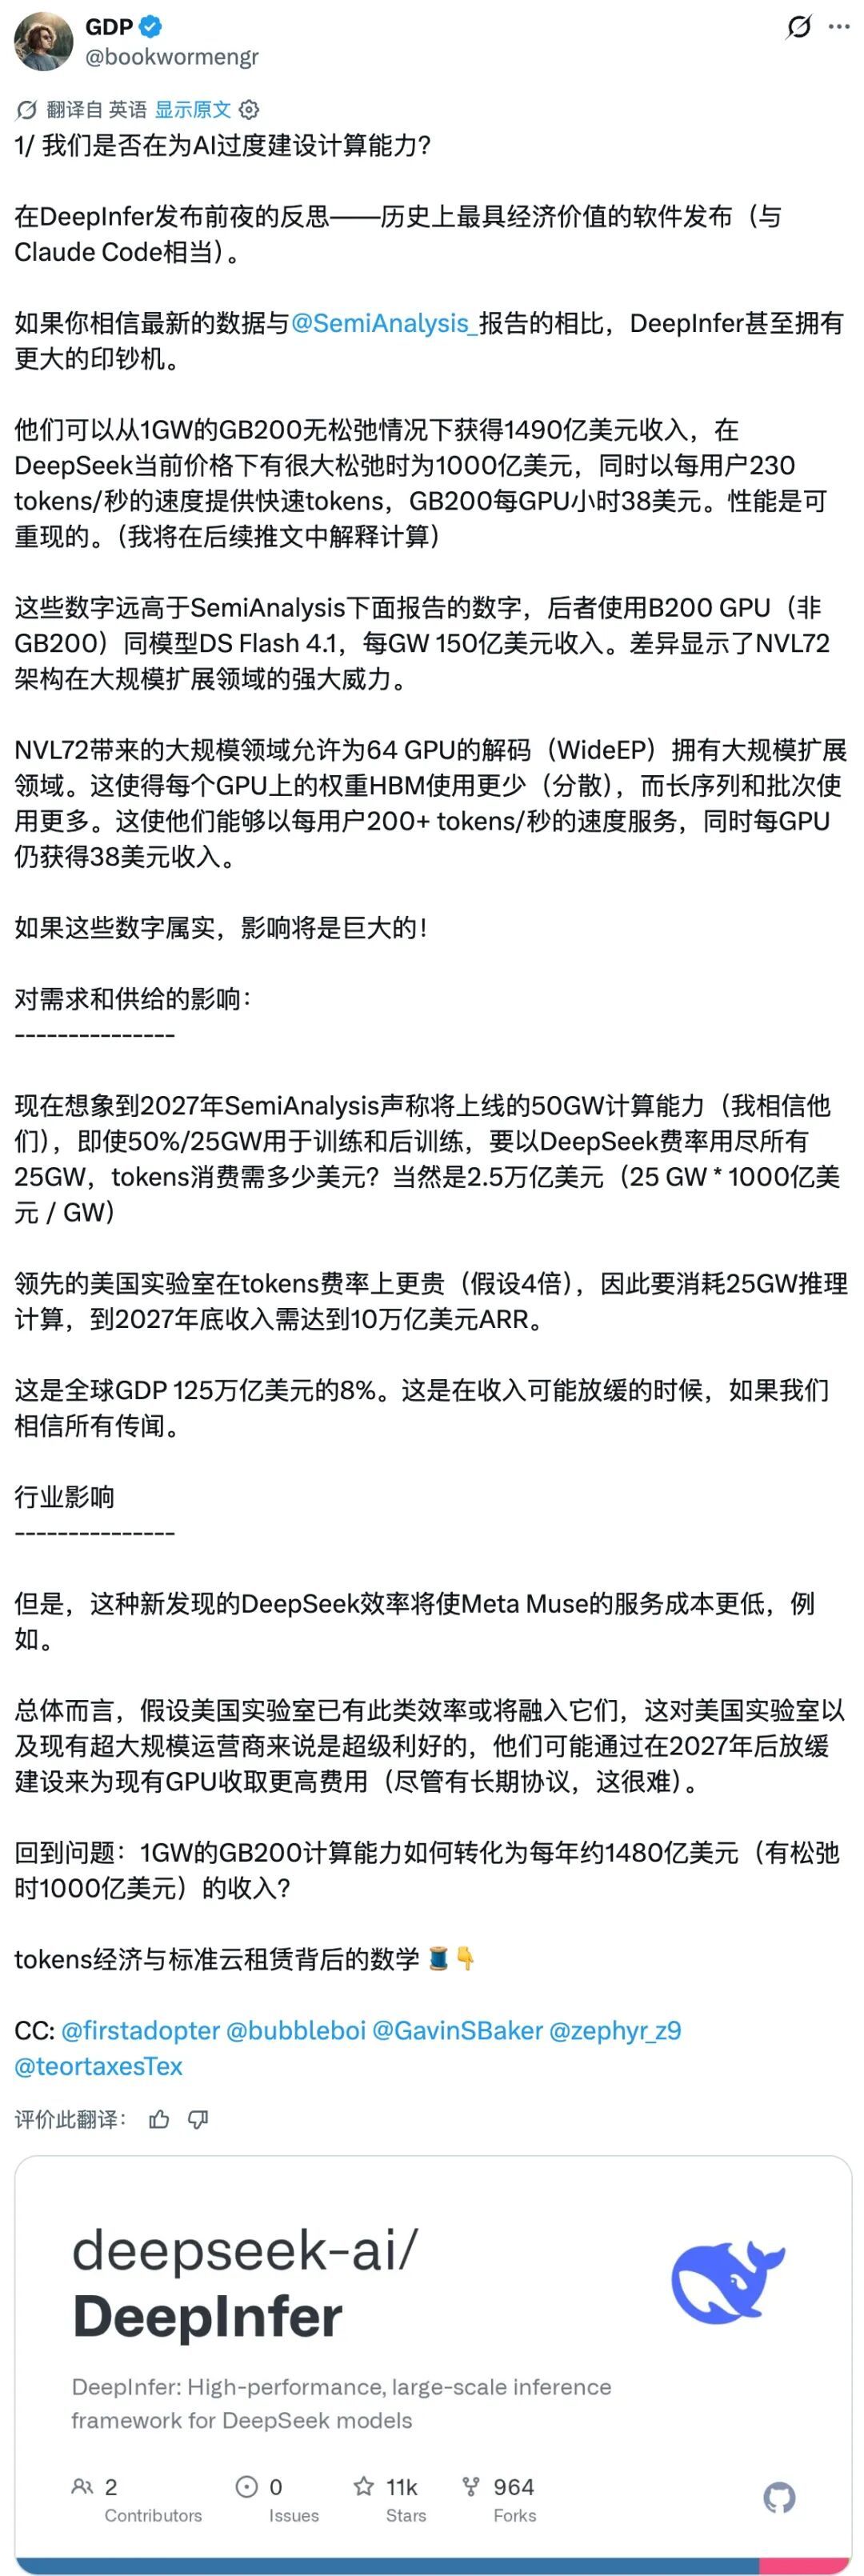
S'il est converti en un prix symbolique au cœur noir plus de quatre fois supérieur à celui d'OpenAI et d'Anthropic, l'humanité entière devra contribuer à hauteur de 10 000 milliards de dollars américains en ARR d'ici la fin de 2027 afin de combler l'appétit pour 25 GW de puissance de calcul.
La raison pour laquelle les géants étrangers des sources fermées comptent sur des cartes empilées, brûlent de l'argent et signent des centaines de milliards de contrats pour maintenir leurs récits est pour deux raisons. Soit leur propre optimisation technique est trop lente, soit ils utilisent délibérément l'inefficacité comme couverture et établissent des seuils de puissance de calcul élevés pour empêcher les autres d'entrer.
DeepSeek a fait éclater cette bulle d'IA avec des modèles open source en continu et un ensemble complet de projets de raisonnement open source. Comme certains internautes l'ont plaisanté, avec la technologie open source de DeepSeek, OpenAI et Claude devraient à nouveau évoluer en secret.
Ma suggestion est que lorsque nous sommes trois ensemble, il doit y avoir une personne qui soit mon professeur. Anthropic devrait cesser d'être réservé et aller sur GitHub pendant la nuit pour cloner DeepInfer de DeepSeek pour le déploiement. Si vous volez des idées de planification et d'optimisation du cache, vous pouvez économiser beaucoup de factures de puissance de calcul. (Tête de chien manuelle)
Commentaires