Résumé :
C'est fou. En seulement deux jours, 4 nouveaux modèles sont apparus ! Sur le devant de la scène, xAI de Lao Ma vient de terminer la publication de Grok 4.7. Immédiatement après, OpenAI a soudainement abandonné GPT-6 Sol et Luna, et le prix a été réduit de moitié. Le même jour, Anthropic a également mis sur la table le Claude Opus 5.5, 40% moins cher que la génération précédente. Le 22 septembre, une image animée est devenue virale sur X, avec près d'un million de vues.
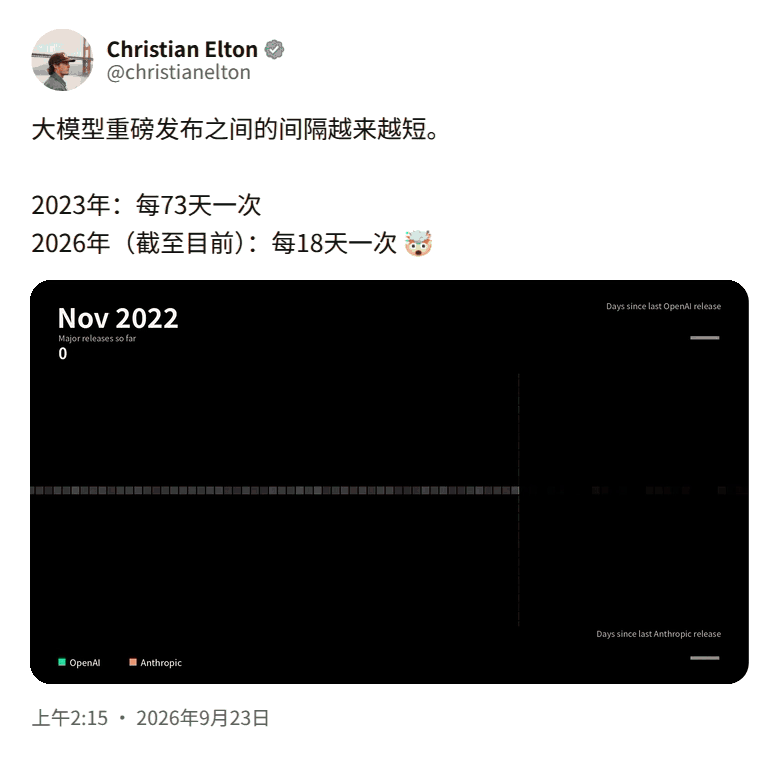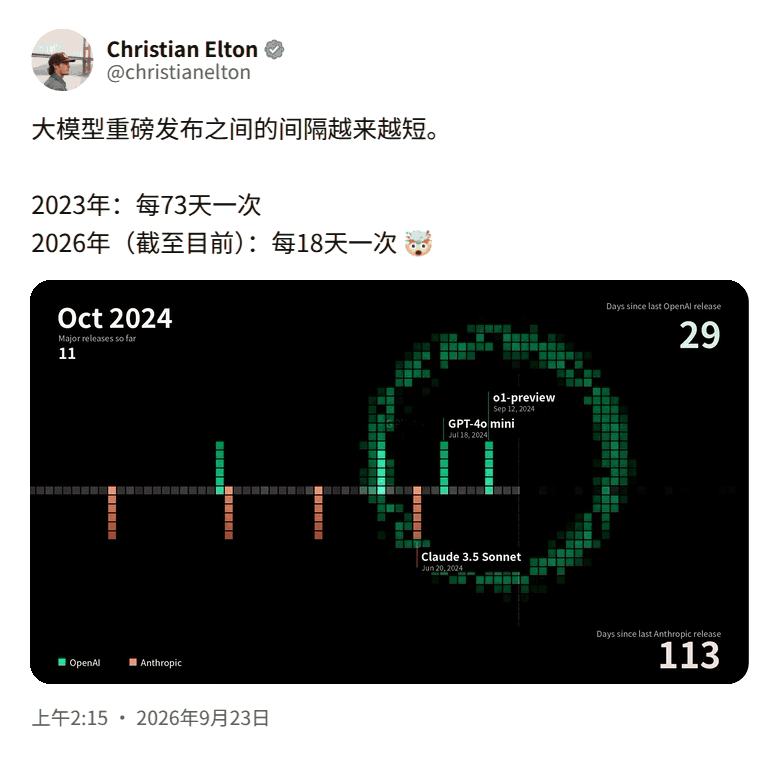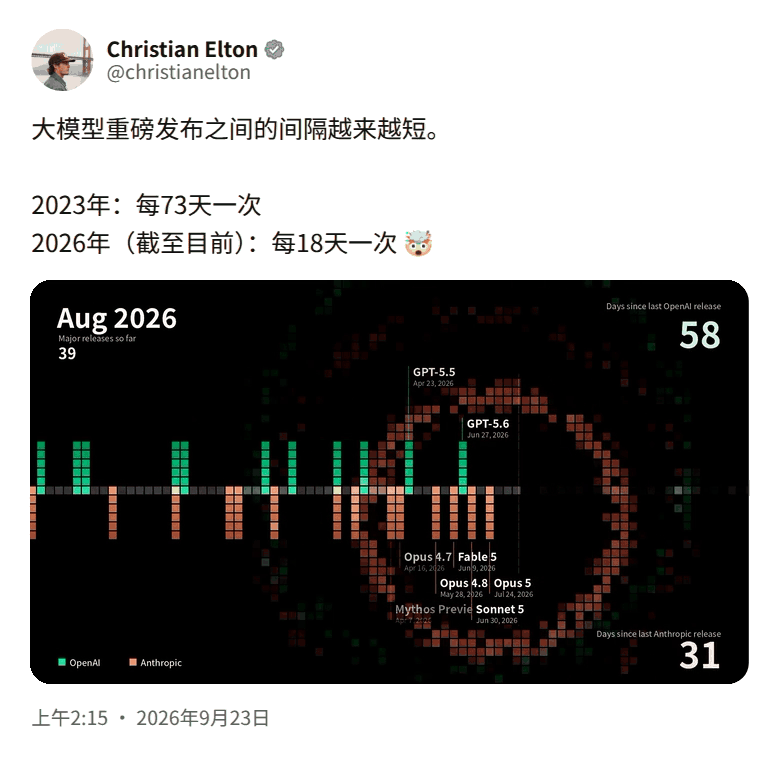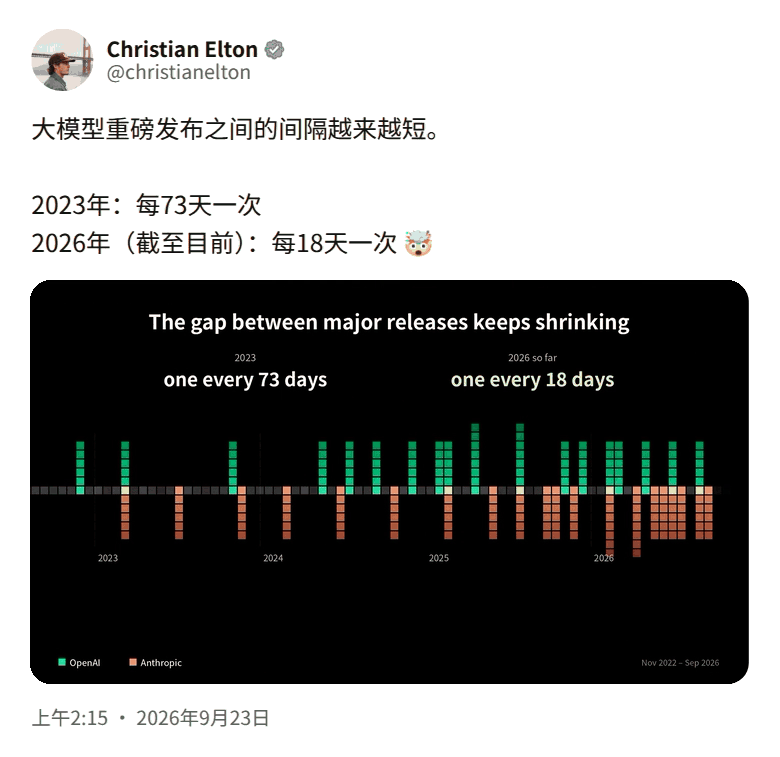
En 2023, les grands modèles seront mis à jour tous les 73 jours, et en 2026, ils seront mis à jour tous les 18 jours.
Depuis le lancement de ChatGPT, OpenAI et Anthropic ont bombardé 42 modèles à succès (44 dont GPT-6 Sol et Luna sortis ce jour-là).
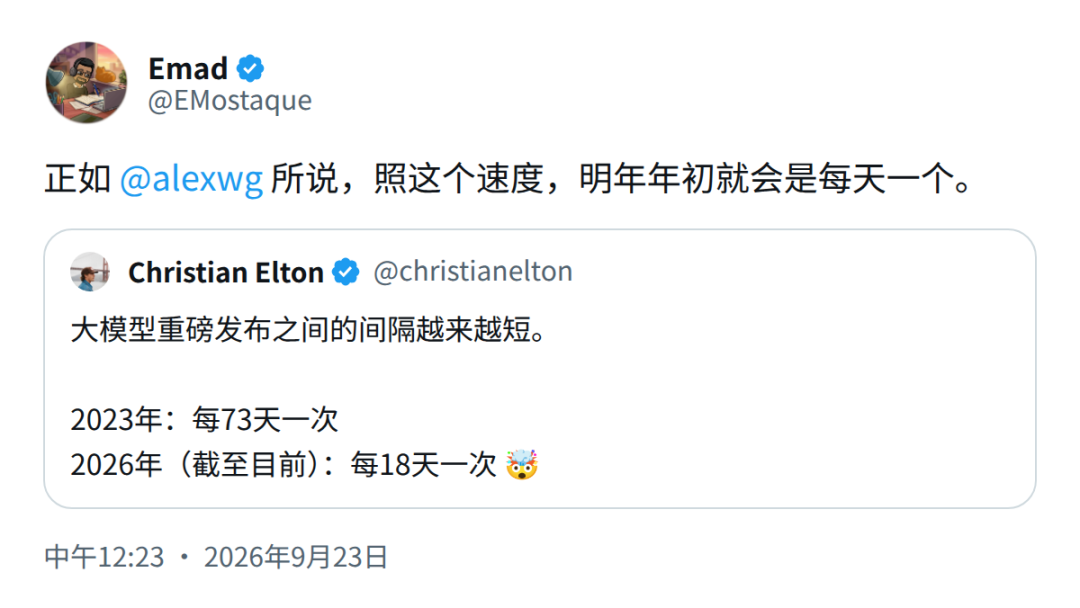
Quelques heures plus tard, le fondateur de Stability AI, Emad Mostaque, a retweeté la photo et ajouté une prophétie.
"Comme Alex l'a dit, à ce rythme-là, il y en aura un par jour au début de l'année prochaine."
Deux géants, déployez la "mise à jour bimensuelle"
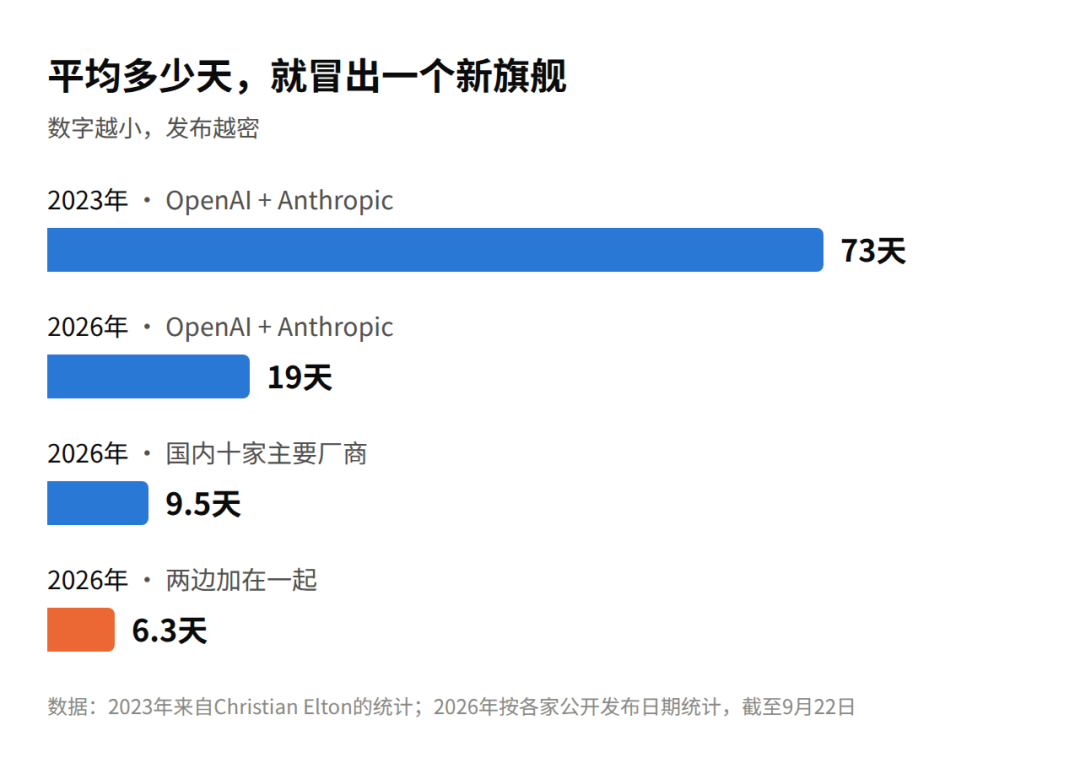
En fait, le nombre de "mises à jour tous les 18 jours" est assez conservateur, car il ne prend en compte que OpenAI et Anthropic.
Du début de cette année au 22 septembre, Anthropic a sorti 8 modèles phares et OpenAI 6. Les 14 modèles se sont répartis sur 265 jours, avec une moyenne de 19 jours par modèle.
Au cours de la même période, les dix principaux fabricants nationaux de grands modèles ont lancé au moins 28 modèles phares supplémentaires, soit une moyenne de plus d'un tous les 9 jours.
Il y a eu des moments où ils se sont lancés ensemble. Au cours de la semaine précédant la Fête du Printemps, quatre sociétés ont lancé successivement de nouveaux produits phares ; du 20 au 24 avril, quatre autres compagnies se sont relayées pendant cinq jours.
En prenant les deux côtés ensemble, un nouveau produit phare émerge en moyenne en plus de 6 jours, ce qui n'est pas loin du "un par jour" évoqué par Emad.
L'augmentation de la vitesse d'Anthropic est visible à l'œil nu.
Au premier semestre, il fallait en moyenne 46 jours pour sortir un modèle, et au second semestre, 26 jours. L'opus 4.8 aura lieu le 28 mai, l'opus 5 le 24 juillet et l'opus 5.5 le 22 septembre.
OpenAI choisit la voie consistant à « retenir le mouvement ultime, puis à le retirer ».
GPT-6 Astra vient de faire exploser l'ensemble du réseau le 3 septembre, et seulement 19 jours plus tard, Sol et Luna ont emboîté le pas.
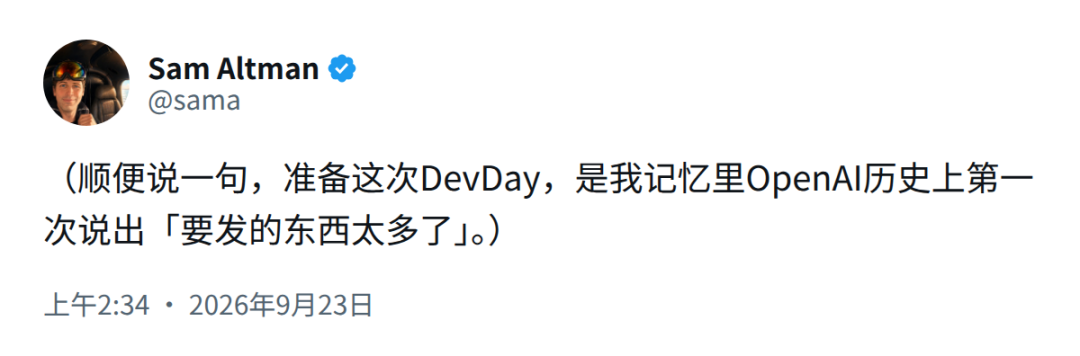
Il y aura la conférence DevDay la semaine prochaine. Altman a déploré que c'est la première fois de sa mémoire qu'OpenAI crie "il y a trop de choses à publier" lors de la préparation d'une conférence de presse.
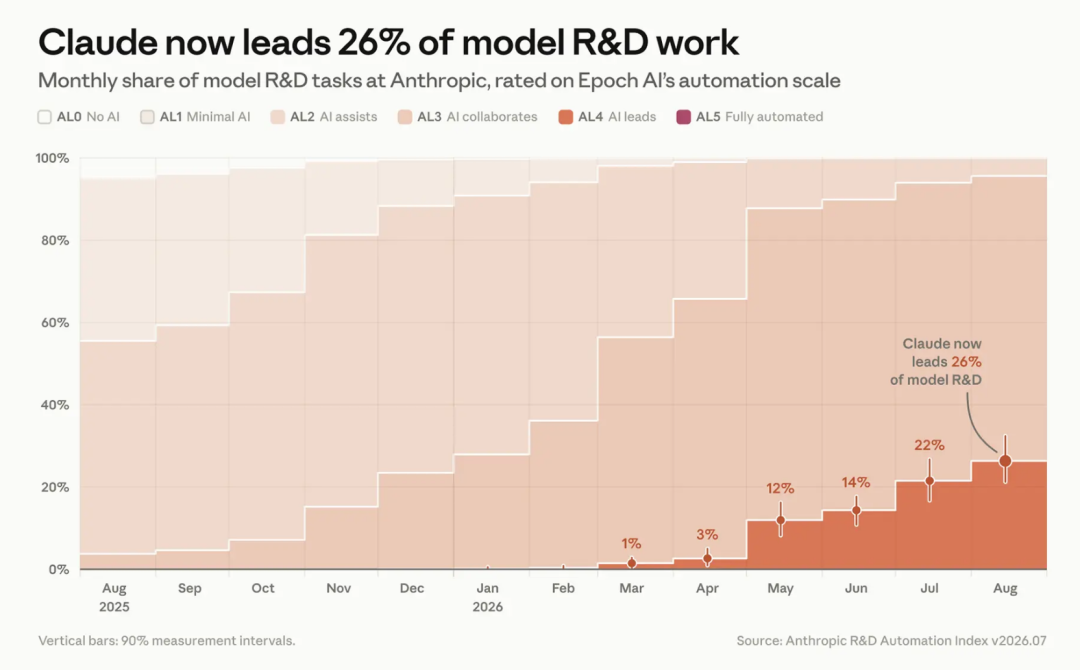
Pourquoi l’édition devient-elle de plus en plus dense ? Anthropic a donné la réponse dans un rapport. L’IA contribue déjà à créer la prochaine génération d’IA.
En février de cette année, Claude pouvait diriger de manière indépendante moins de 1 % des travaux de R&D en IA. Par la suite, il s'est amélioré presque tous les mois, atteignant 12 % en mai, 22 % en juillet et 26 % en août.
Chez OpenAI, à la mi-août, le nombre de jours de travail investis par les agents d'IA était 3,1 fois supérieur à celui des chercheurs humains (sur la base de 8 heures par jour).
Chez Anthropic, un quart du travail de réalisation des modèles a été confié à Claude lui-même. Les prochains modèles arriveront les uns après les autres.
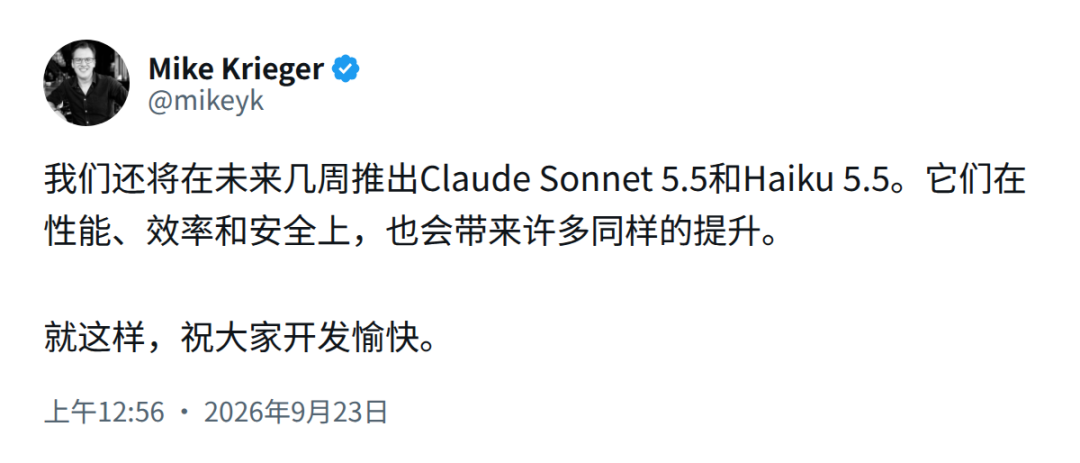
La file d'attente a déjà atteint la porte. Mike Krieger d'Anthropic a révélé que Sonnet 5.5 et Haiku 5.5 arriveront dans les prochaines semaines.
Le Gemini 4 de Google a lancé « le pré-entraînement le plus ambitieux à ce jour » dès juillet, et le monde extérieur parie généralement qu'il sera dévoilé vers la fin de l'année. Au moins deux sociétés nationales ont officiellement annoncé leurs produits phares de nouvelle génération, avec une seule date de sortie manquante.
La "métaphysique" durement gagnée
Il sera mis au rebut immédiatement après deux mois
Plus le grand modèle s'exécute rapidement, plus cela devient embarrassant pour les personnes qui écrivent le code en aval.
Vous êtes resté éveillé quelques nuits blanches fin juillet et venez de déplacer l'application vers l'Opus 5. Chaque paramètre a été ajusté en douceur. Deux mois plus tard, Opus 5.5 est sorti, et vous avez heureusement changé l'interface - cliquez, et certaines requêtes signalaient directement des erreurs.
En parcourant les récents guides de mots officiels de ces deux sociétés, vous constaterez qu'ils transmettent le même fait. La plupart des invites ancestrales que vous avez écrites pour le modèle de la génération précédente sont devenues des vieux papiers.
La première chose est de faire une soustraction.
OpenAI indique clairement dans le guide Astra que les instructions de processus qui étaient trop détaillées dans le passé seront désormais un frein. Des mots tels que « lire attentivement le document avant de modifier le code » et « n'oubliez pas d'exécuter des tests » peuvent tous être supprimés.
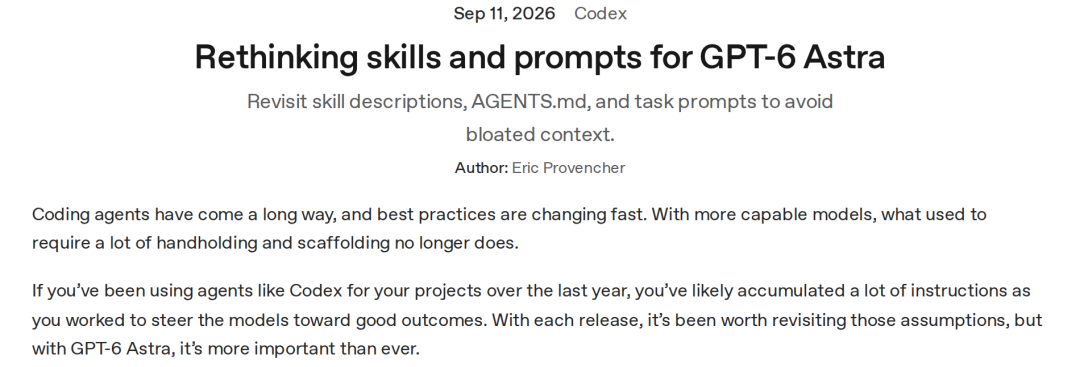
Le guide d'Anthropic veut également dire cela.
Dans le passé, les mots d'invite devaient souvent ajouter la phrase "Vérifiez-le une fois terminé", mais l'Opus 5 peut déjà le vérifier tout seul. Si cette phrase n'est pas supprimée, elle sera survérifiée.
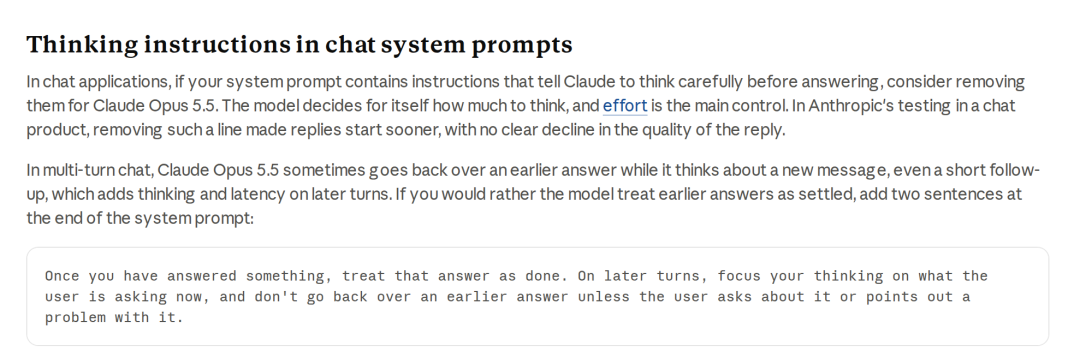
Dans Opus 5.5, il est recommandé de supprimer la phrase PUA « réfléchissez bien avant de répondre » dans la scène de chat. Après l'avoir supprimé, la réponse est plus rapide et la qualité n'a pas diminué de manière significative.
Après avoir supprimé les anciens, vous devez en ajouter de nouveaux, car chaque génération a un nouveau caractère.
L'Opus 5.5 aime toujours revenir en arrière et réfléchir à des questions auxquelles on a déjà répondu au cours de plusieurs cycles de dialogue, ce qui constitue un gaspillage de puissance de calcul. Le correctif officiel a été donné : "Ce qui a été répondu est passé."
Les paramètres et les valeurs par défaut changent également silencieusement.
Sur Opus 5.5, désactiver le mode réflexion signale directement une erreur 400 ; sans écrire le paramètre d'effort, la vitesse par défaut est réduite de élevée à moyenne, et le coût et l'effet sont mélangés en conséquence.
À cet égard, la suggestion officielle est de réexécuter le test d'effort et de ne pas transférer directement les anciens paramètres de l'Opus 5.
Un ensemble de mots d'invite plus un ensemble de paramètres, chaque génération doit décoller des couches de peau. Si le réglage n’a pas été effectué, la facture peut varier considérablement.
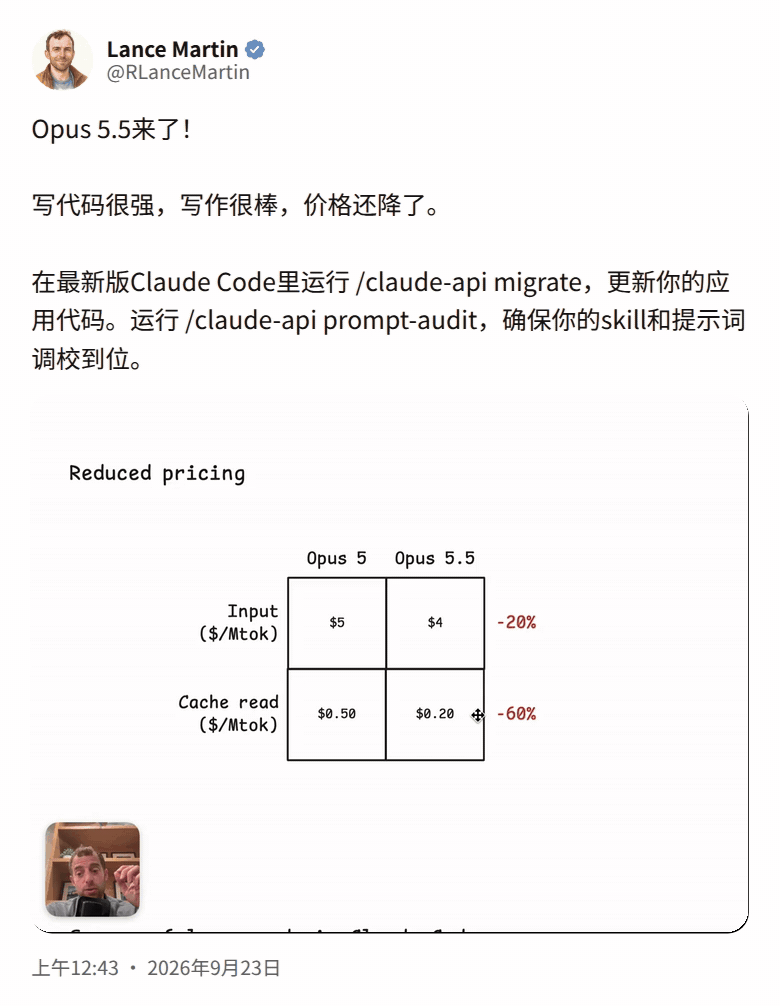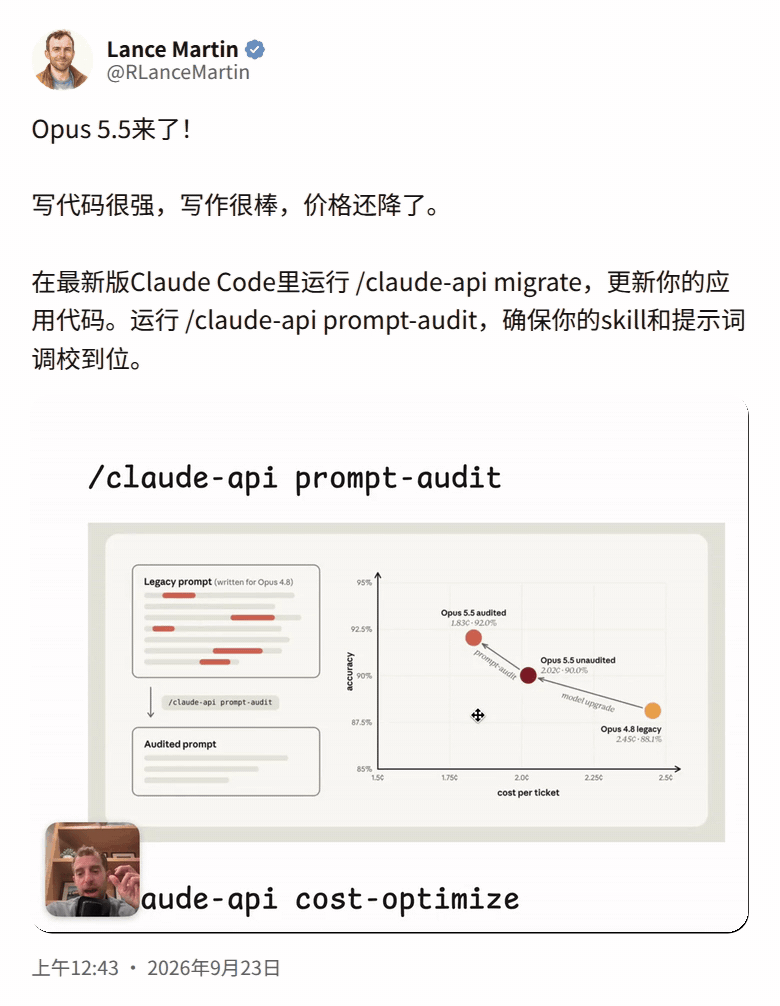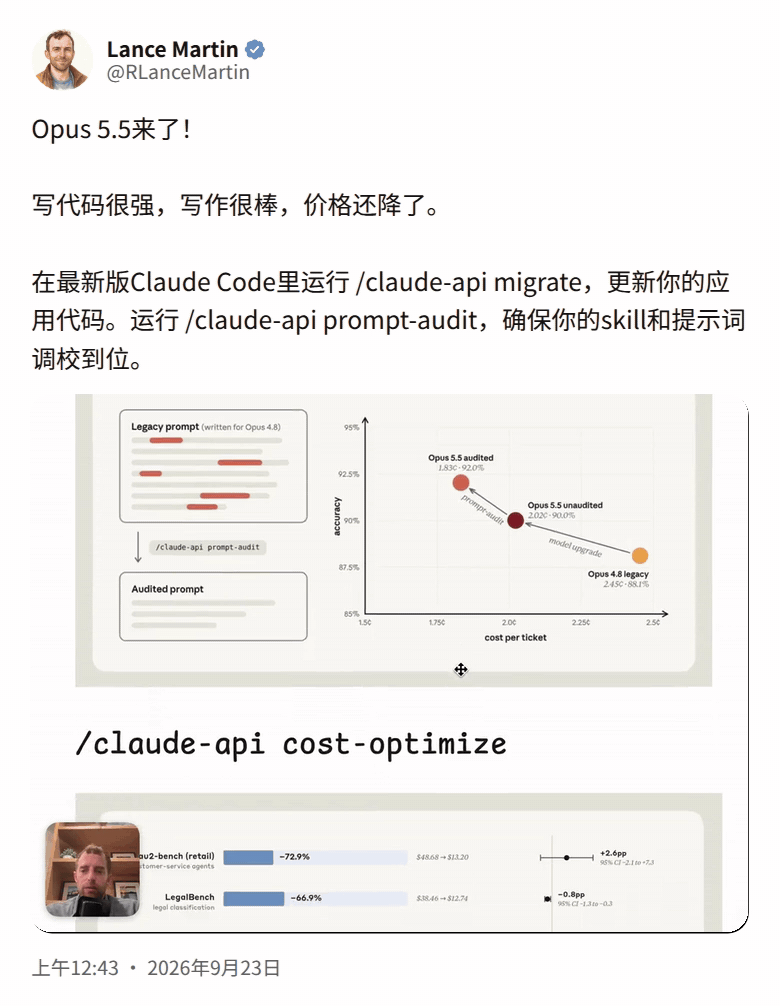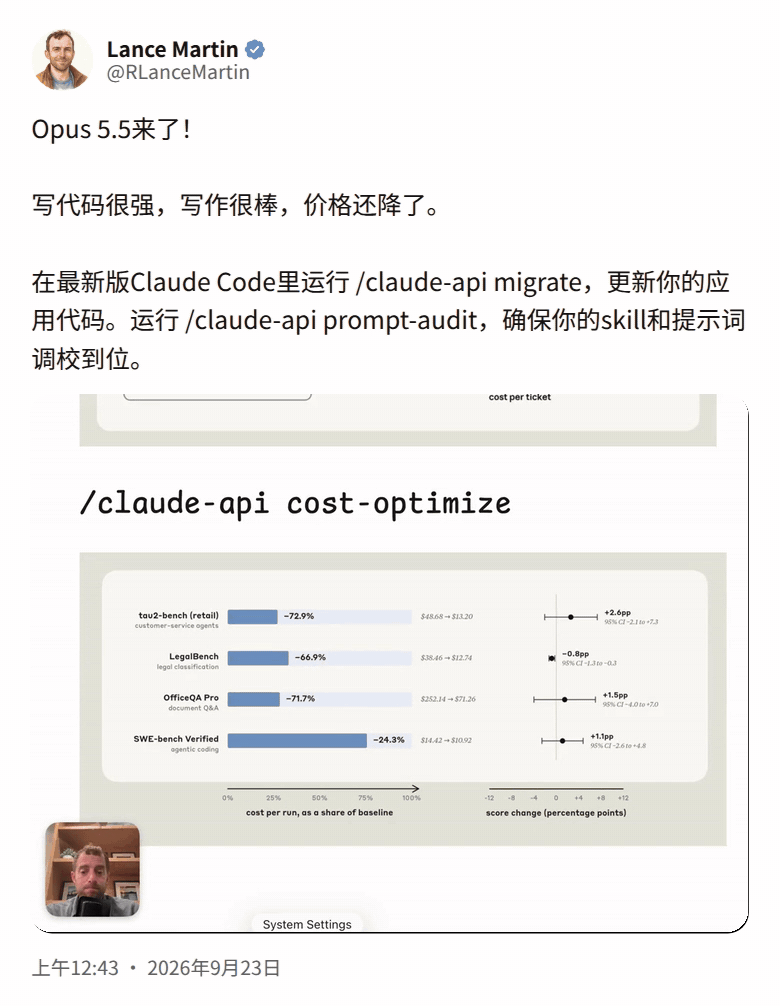
Lance Martin d'Anthropic a démontré dans la vidéo qu'une ancienne invite écrite pour l'Opus 4.8 coûtait 2,45 cents par bon de travail, et qu'il en coûtait 2,02 cents pour la remplacer directement par l'Opus 5.5. Après l'avoir lavé à nouveau avec les outils officiels, le taux de précision est passé à 92,0 % et le coût a été réduit à 1,83 centimes.
En plus de cela, la durée de vie du modèle lui-même est également raccourcie.
OpenAI a publié 9 annonces de dépréciation cette année, impliquant plus de 40 modèles et fonctions.
Parmi eux, GPT-5.5, qui vient d'être publié le 23 avril, sera supprimé de ChatGPT et du Codex le 14 octobre et a survécu moins de six mois.
Même la plateforme d'évaluation Evals d'OpenAI fermera ses portes fin novembre.
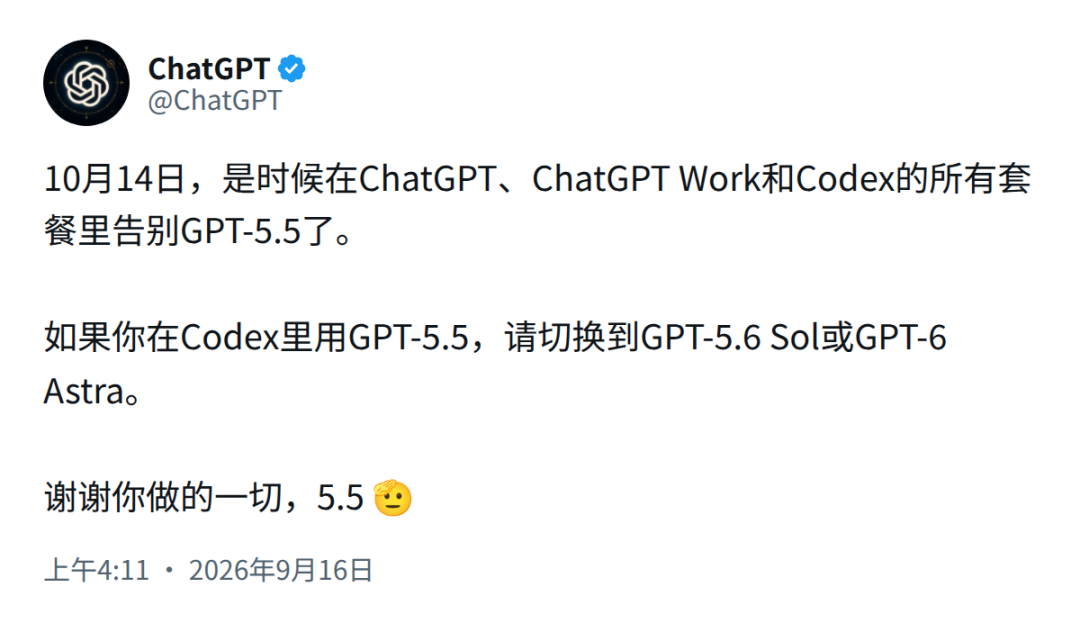
Brosser la liste ? Une nouvelle série de questions de test a été élaborée en six mois.
Peu importe si les gens n'arrivent pas à suivre, maintenant même les « copies d'examen » ne suffisent plus.
En mars de cette année, ARC-AGI-3, qui prétend se spécialiser dans l'IA et tester le QI sans mémoriser les questions, a été lancé. Gemini 3.1 Pro, qui se classait premier à l'époque, n'a obtenu que 0,37 %, tandis que les humains ont obtenu 100 %.
Le 3 septembre, GPT-6 Astra est entré dans la salle d'examen, obtenant un score de 62,7 % au test standard, et a directement atteint 99,9 % en utilisant un cadre spécifique. Dans 96 % des niveaux, il a fallu moins de pas qu’un humain.
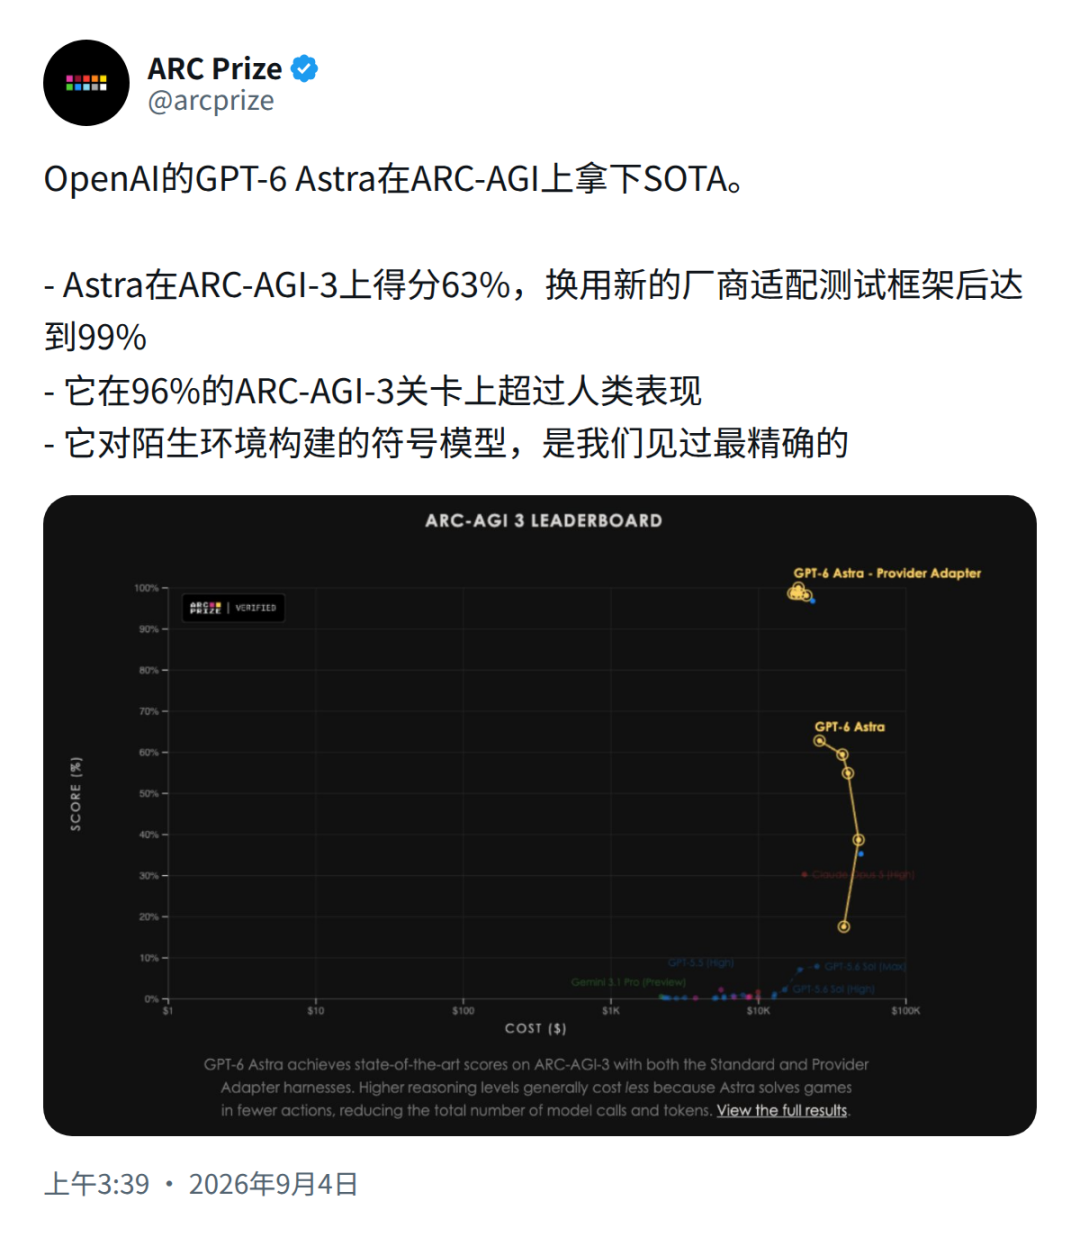
Une nouvelle série de questions de test a été décomposée en six mois, et les responsables de l'ARC ont commencé à réfléchir à la manière de produire la prochaine génération d'évaluations.
Sur la liste de codage (Next.js), Sol, Opus 5.5 et Fable 5.1 ont tous obtenu un score de 97 %, à égalité pour la première place ; sur la liste d'écriture, Opus 5.5 Fault mène la deuxième place avec 307 points.
Ce score constitue le plus grand saut de l'histoire de la liste. Le blogueur a dit que c'était scandaleux après l'avoir lu, et a presque pensé qu'il y avait un bug dans son propre benchmark !
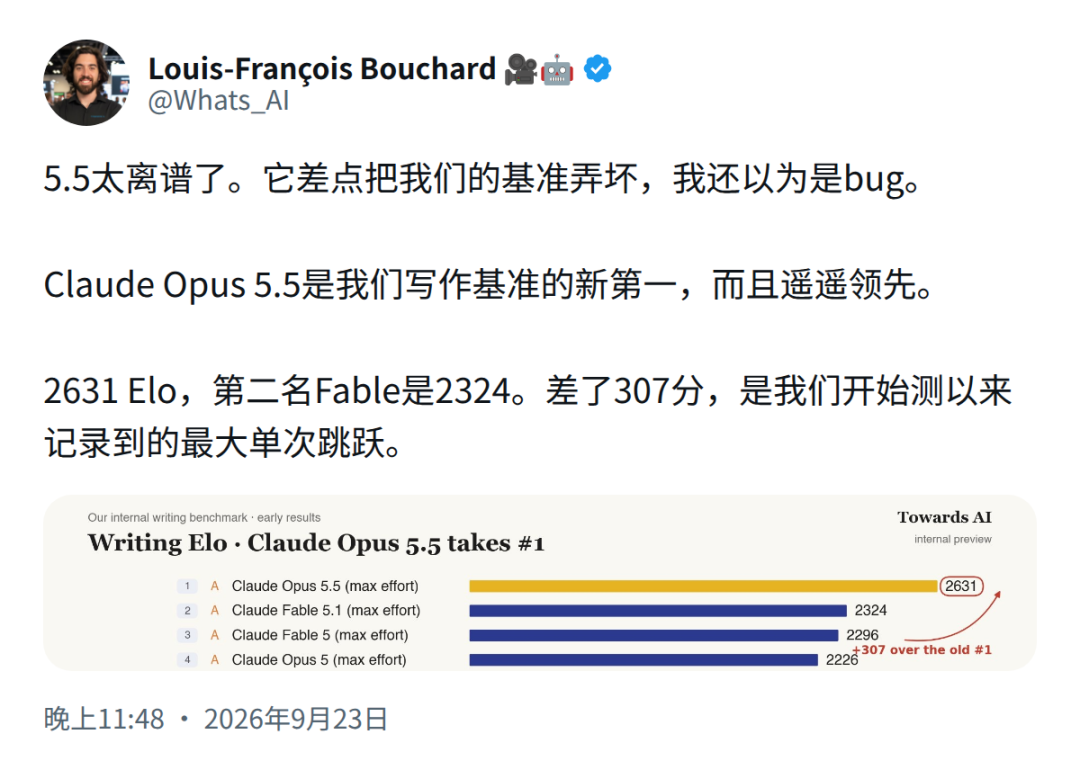
Chaque fois qu'un nouveau modèle arrive, les développeurs doivent recommencer le processus de test comme Sisyphe.
Selon le rythme actuel, si l'année prochaine on atteint réellement « une mise à jour par jour », les mots d'invite et les liens d'agent que vous avez ajustés aujourd'hui pourraient ne pas durer plus d'une semaine.
Pour la première fois, la vitesse de remplacement du modèle a complètement dépassé la vitesse d'adaptation des humains.
Les coureurs les plus lents aujourd'hui sont en réalité ceux qui utilisent l'IA.
Commentaires