
Résumé :
Mars 2016, Four Seasons Hotel Séoul. Au milieu du deuxième match de la bataille homme-machine, AlphaGo a laissé tomber une tache solaire sur la cinquième ligne. Les commentaires sur place étaient à court de mots, et certaines personnes soupçonnaient qu'il y avait un bug dans le programme, car selon le bon sens des joueurs d'échecs professionnels, ce coup était presque un lancer franc.
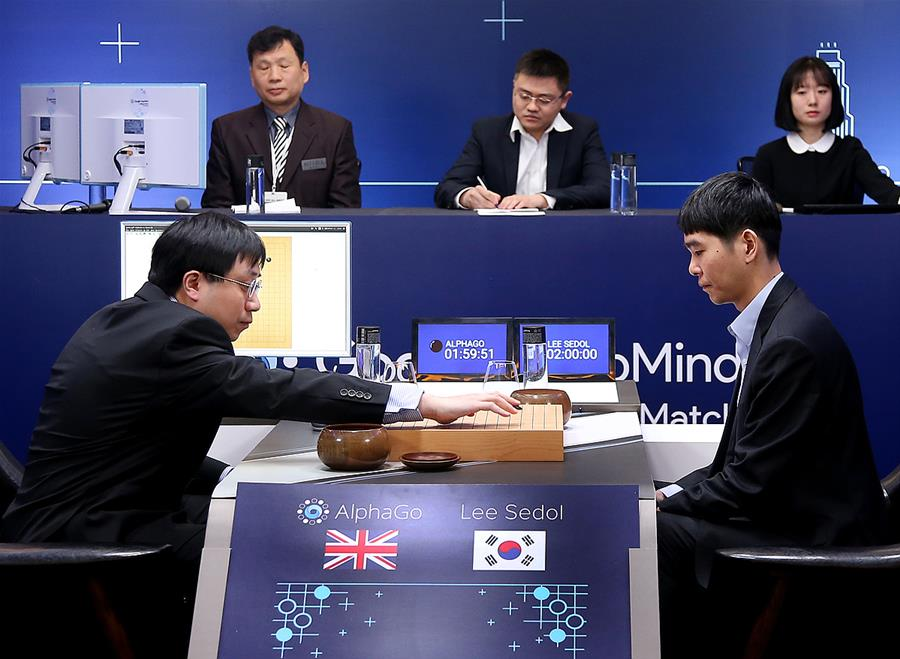
Tout le monde connaît l'histoire qui a suivi. AlphaGo a non seulement remporté ce match, mais a également battu Lee Sedol avec un score total de 4 : 1. Après le match, Lee Sedol a déclaré quelque chose qui est souvent cité : "Au départ, je pensais qu'AlphaGo n'était qu'une machine basée sur le calcul de probabilités. Mais après avoir vu cette main, j'ai changé d'avis. AlphaGo doit être créatif."
C'est le fameux coup 37.
Dix ans plus tard, l'homme qui a construit AlphaGo s'est levé et a déclaré : l'IA d'aujourd'hui n'a pas les capacités sur lesquelles repose ce jeu d'échecs.
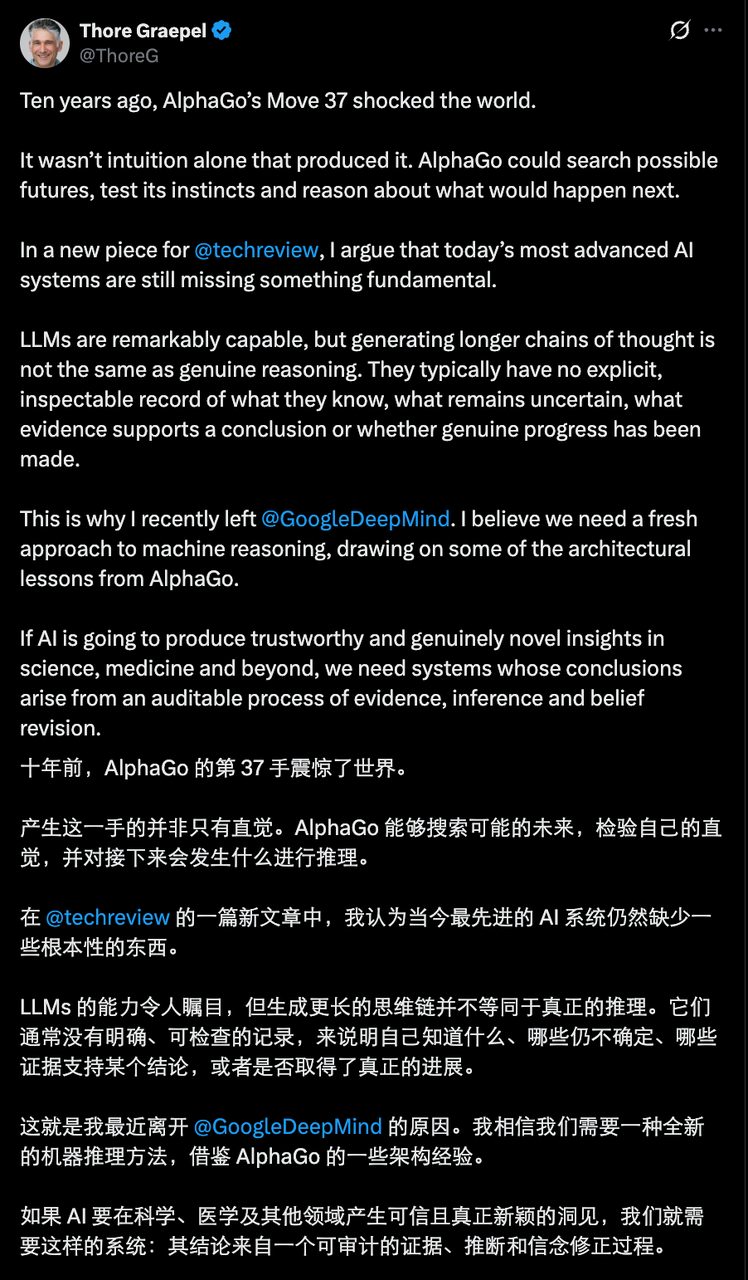
La personne qui a dit cela est Thore Graepel, l'un des principaux auteurs d'AlphaGo et est engagé depuis longtemps dans la recherche sur l'apprentissage automatique. Récemment, il a pris une décision intrigante : quitter Google DeepMind pour créer une entreprise dans le but de faire quelque chose qu'il considère comme plus important : équiper les machines de véritables capacités de raisonnement.
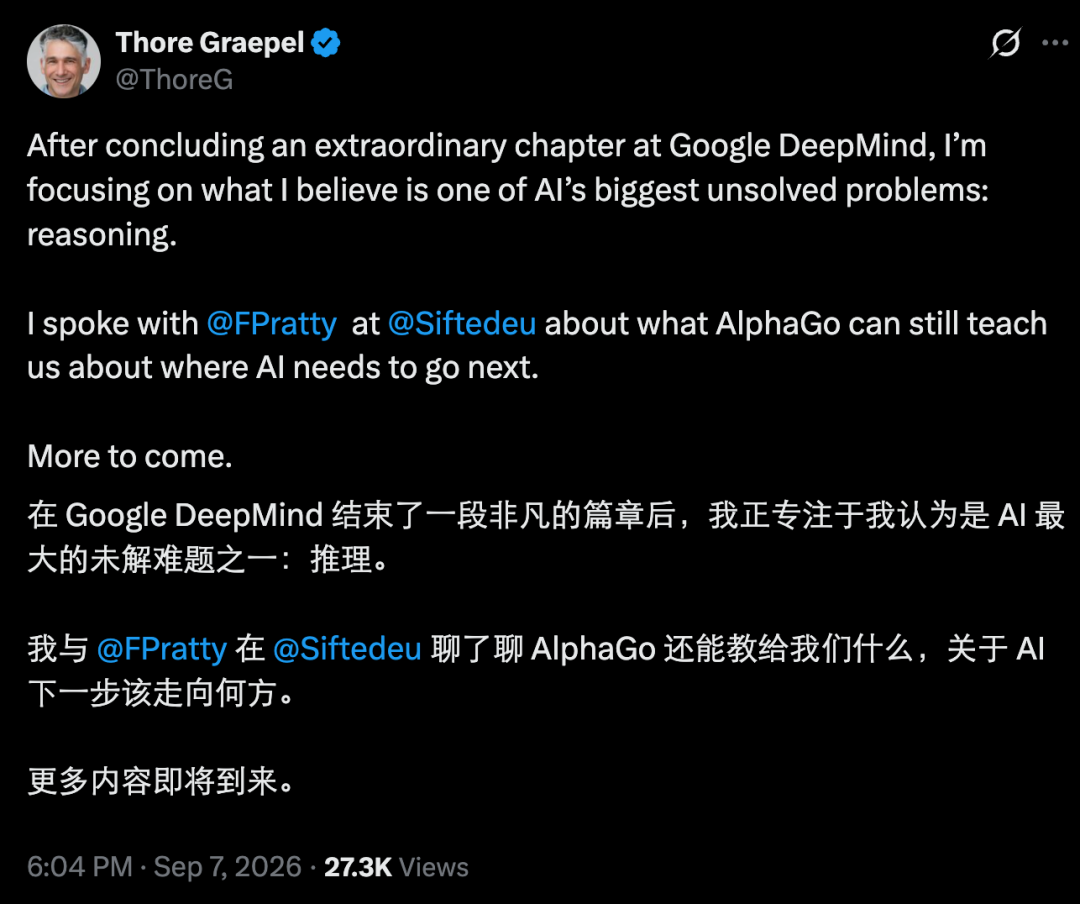
Ce point poignant vient d'un article qu'il a récemment publié dans la MIT Technology Review. Le titre de l'article est très simple, intitulé « Ne vous laissez pas berner : les LLM ne peuvent pas raisonner ». Après avoir lu cet article, Yann LeCun, lauréat du prix Turing, a exprimé son appréciation, soulignant que « le vrai raisonnement doit impliquer la recherche, et le LLM n'a pas cette capacité ».
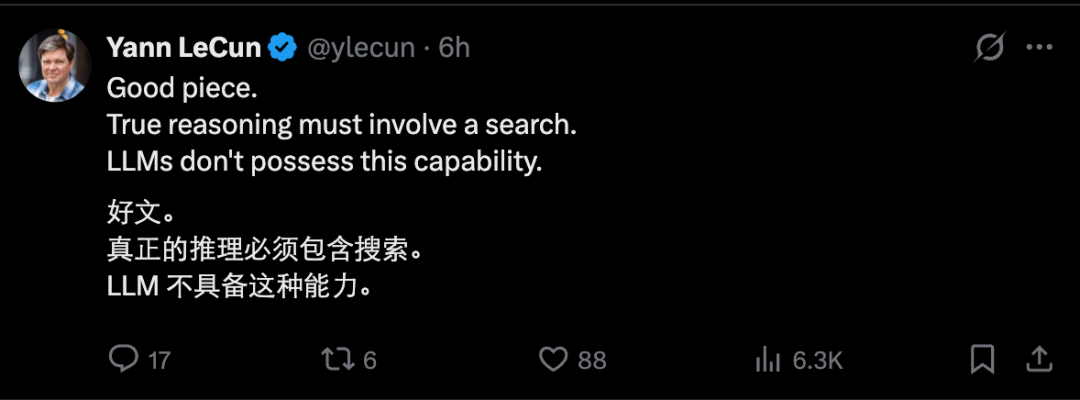
Pourquoi Thore Graepel a-t-il dit cela ? Jetons un coup d'œil à ce qui est écrit dans cet article.
Le coup 37 n'était pas un « éclair d'inspiration »,
C'est le produit d'un raisonnement
Beaucoup de gens décrivent le 37ème coup comme un "moment mythique d'intuition machine" - dans un éclair, l'IA a vu un coup magistral au-delà des mille ans d'histoire des échecs humains. Graepel a déclaré que c'était le plus gros malentendu à propos d'AlphaGo.
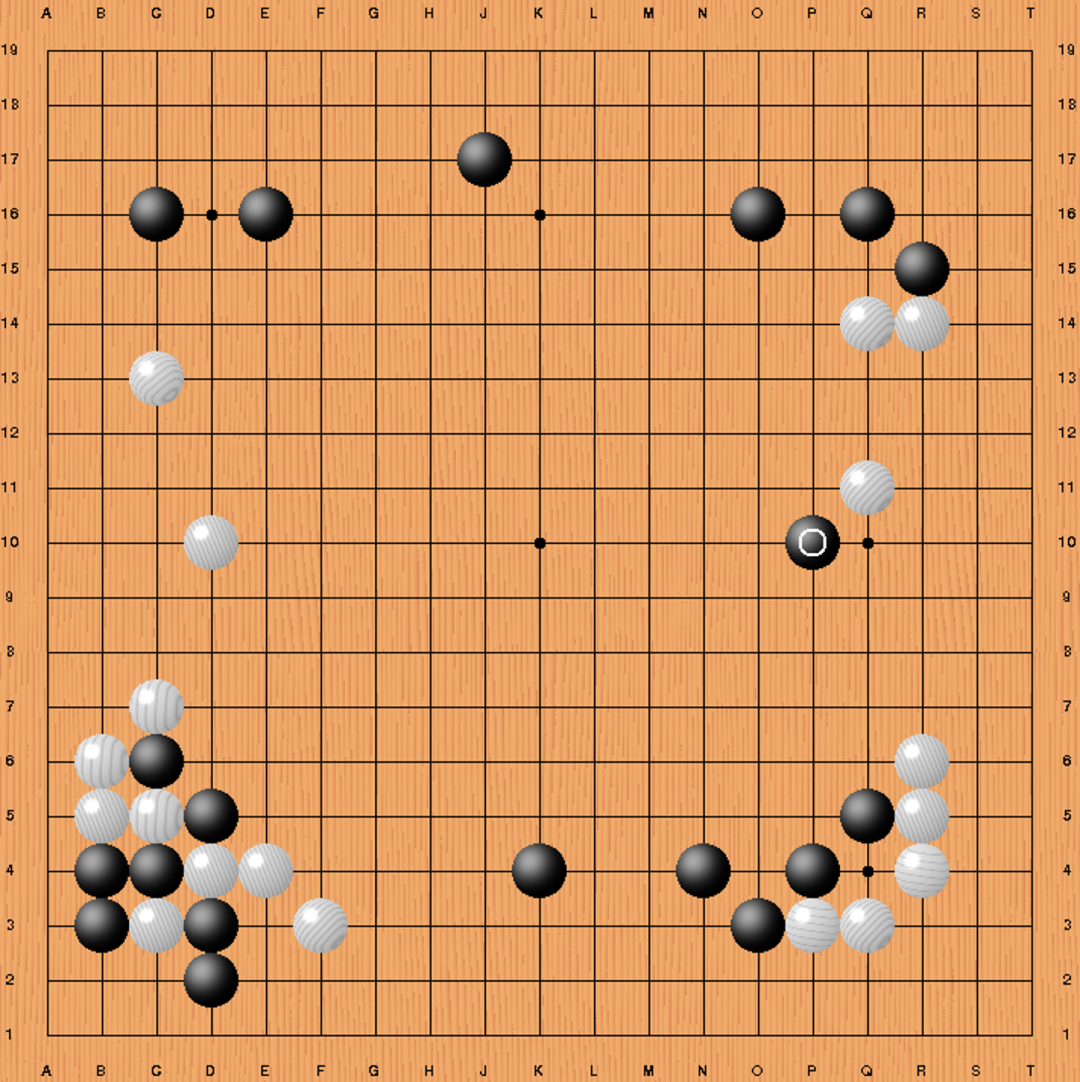
Pour comprendre cela, il faut d'abord démonter la structure interne d'AlphaGo. Il se compose de deux systèmes : l'un est un réseau politique, qui apprend à partir d'enregistrements d'échecs humains massifs pour prédire "comment le maître jouera dans cette situation". C'est la partie intuitive. L'autre est un mécanisme de recherche, qui ne se soucie pas de savoir si un certain coup d'échecs "ressemble à avoir été joué par un humain", mais construit explicitement un arbre de jeu contenant des milliers de branches pour en déduire l'avenir auquel mène chaque position candidate.
Le point clé est le suivant : aux yeux du réseau stratégique, le coup 37 n'a rien de remarquable : la probabilité qu'un joueur d'échecs humain professionnel joue ce coup n'est que d'environ 1 sur 10 000. Si vous écoutez uniquement votre intuition, cette main ne sera pas du tout choisie. C'est le mécanisme de recherche qui, après un calcul minutieux, a découvert que ce mouvement « incroyable » menait à une meilleure fin.
Graepel emprunte le célèbre cadre de Kahneman pour expliquer cela. La pensée humaine est divisée en deux modes : le système 1 est rapide, intuitif et sans effort ; Le système 2 est lent, étape par étape et soigneusement pesé. AlphaGo se trouve être une combinaison rare de ces deux modes sur la machine : le réseau neuronal fournit l'intuition de « ce coup a une chance » et « cette situation est à gagner », et le mécanisme de recherche est chargé de tester ces intuitions lors de futurs changements offensifs et défensifs. Cela ne fonctionnera pas sans moitié : l'intuition seule ne fera jamais le 37ème coup ; les recherches violentes ne pourront à elles seules éliminer les possibilités astronomiques du Go.
Il existe ici une autre comparaison qui est souvent négligée. Deep Blue a vaincu Kasparov en 1997 en s'appuyant sur des règles codées en dur par des humains pour évaluer 200 millions de positions d'échecs par seconde et avoir six à huit longueurs d'avance. La complexité de Go est à un tout autre niveau. La valeur d'une pièce dépend de la croissance et du déclin de l'élan et du terrain après des dizaines de tours. Même si seulement une petite partie de tous les changements était calculée, un superordinateur devrait le calculer sur des milliards d’années. Par conséquent, AlphaGo doit apprendre à « voir clairement la situation d'un seul coup d'œil » et même à créer des mouvements auxquels les humains n'ont jamais pensé. Cela ne se gagne pas en écrasant la puissance de calcul, qui est cruciale.
Grand modèle de langage :
Un système entraîné à l'extrême 1
Regardons l'IA d'aujourd'hui.
Le principe de fonctionnement des grands modèles linguistiques est de prédire le prochain jeton encore et encore. Il s'agit essentiellement du Système 1 en action : rapide, associatif et capable de réaliser des modèles époustouflants dans presque tous les domaines sur lesquels les humains ont jamais écrit, mais sans la partie « réfléchissez avant de répondre ».
Peu de temps après la naissance de ChatGPT, l'industrie s'est rendu compte que la maîtrise d'une langue ne pouvait pas, à elle seule, être réellement utile. Tout le monde connaît le plan de solution : ne pas laisser le modèle se précipiter pour répondre, générer d'abord des étapes intermédiaires, décomposer le problème et amener les résultats intermédiaires - c'est-à-dire la chaîne de pensée.
L'amélioration de la chaîne de pensée est réelle, notamment en mathématiques et en codage. Mais Graepel a souligné un fait qui est facilement masqué par l'excitation : ces étapes de raisonnement intermédiaires sont toujours le même processus de « prédire le prochain jeton », il itère juste un peu plus longtemps avant de donner la réponse finale. Il n'introduit pas de mécanisme de raisonnement véritablement indépendant comme la recherche d'AlphaGo. L'intuition est tendue, mais elle ne se transforme pas en prudence.
Il a en outre énuméré trois lacunes pour expliquer pourquoi les actions du chatbot ne correspondent pas au « type de raisonnement reconnu par les scientifiques ».
Premièrement, le modèle ne dispose pas d'un état cognitif clair, continuellement mis à jour et inspectable. Quelles hypothèses il envisage actuellement, quelle confiance il accorde aux diverses explications, quelles preuves il évalue et quelles questions restent sans réponse. Ces éléments devraient être systématiquement révisés à mesure que de nouvelles informations arrivent, mais il n'existe pas de « grand livre ouvert » dans le modèle.
Deuxièmement, le modèle ne parvient pas à séparer « ce qu'il faut savoir » et « comment utiliser les connaissances ». La connaissance et le raisonnement sont étroitement liés aux poids du réseau neuronal, et il n’existe pas de système de croyance indépendant et explicitement exprimé.
Troisièmement, et le plus subtil : les chaînes de pensées ressemblent à une délibération réfléchie, mais la recherche a montré que les modèles les inventent souvent après coup. La réponse s'obtient en marchant dans un sens, mais ce qui vous est rapporté est dans un autre sens. Une « histoire qui semble raisonnable » et un « raisonnement qui s’est réellement produit » sont deux choses différentes.
Que le raisonnement soit vrai ou faux,
Est-ce si important ?
Si vous ne faites que discuter et discuter, peu importe que le raisonnement soit vrai ou faux. Mais dans les domaines aux enjeux élevés qui nous tiennent vraiment à cœur – médecine, ingénierie, recherche scientifique – ce qu’un système atteint est tout aussi important que la manière dont il y parvient. Lorsque quelque chose ne va pas, comme une erreur de diagnostic ou de traitement, nous devons être capables d’identifier où se situe l’erreur : y a-t-il un problème avec le processus de raisonnement, accepte-t-il des preuves invalides ou fait-il une hypothèse erronée ? On ne peut pas faire confiance à un système qui ne peut qu’inventer des histoires après coup ni le rendre responsable dans de tels scénarios.
C'est exactement pourquoi Graepel a quitté DeepMind. Il pense que nous avons besoin d’une nouvelle voie de raisonnement automatique, et l’inspiration vient d’AlphaGo il y a dix ans.
AlphaGo conserve à tout moment un enregistrement de toutes ses connaissances sur la situation actuelle, ce qui constitue l'arbre du jeu. L'arbre contient tous les changements qu'il a pris en compte, tous les futurs possibles, et chaque mouvement et chaque situation est marqué par le jugement du réseau neuronal. Au fur et à mesure que la déduction progresse, elle met continuellement à jour l'arbre et détermine finalement le mouvement en fonction des informations contenues dans l'arbre.
Graepel pense qu'il en va de même pour les systèmes de raisonnement généraux : maintenir un état cognitif qui exprime clairement ce qui est confirmé, ce qui est douteux, ce qui a été exclu et quelles questions restent ouvertes. Et le « raisonnement » est une série d'« actions » qui modifient cet état cognitif – tirer des conclusions, démanteler les problèmes et, plus important encore : décider quelles questions poser ensuite, quels calculs effectuer et quelles expériences mener.
Bien sûr, raisonner dans un monde ouvert est bien plus difficile que jouer aux échecs. L'état sur le plateau Go est entièrement visible et les règles sont fixes ; dans le monde réel, la situation actuelle n’est que partiellement connue, les actions disponibles sont nombreuses et complexes, et les conséquences des actions sont pleines de hasard, voire totalement inconnues.
Mais la bonne nouvelle est que les progrès du LLM et d'autres modèles neuronaux au fil des années n'ont fourni que des éléments pour cela : LLM peut proposer une voie pour résoudre le problème sur la base des informations connues et des ressources disponibles ; il peut interagir avec des outils via des API et des codes ; cela peut aider à évaluer si une conclusion est étayée par des preuves existantes. Plus important encore, il doit y avoir un « arbitre » indépendant dans le système qui évalue chaque mouvement de raisonnement en fonction du « degré d’incertitude résolue par cette étape » – et ne met à jour les croyances que lorsqu’elles sont étayées par des preuves. Une fois les règles établies, le système peut accumuler des connaissances certifiées, tirer des leçons des expériences de raisonnement passées et améliorer ses propres stratégies de raisonnement.
Graepel a donné à cette image une expression vivante : la méthode scientifique sous stéroïdes. Il n’y a qu’un seul objectif : produire des connaissances qui résistent à un examen minutieux.
Plus grand système 1,
Le système 2 ne se développera pas automatiquement
À la fin de l'article, il a clairement exprimé son attitude : une intelligence machine digne de confiance ne peut être obtenue en agrandissant le Système 1. L'échelle aiguise l'intuition, mais pas la prudence.
La raison pour laquelle le coup 37 est important est parce qu'une machine a défendu une position, a pesé les futurs possibles, puis a sélectionné un mouvement que même son propre « instinct » aurait probablement rejeté.
La société humaine a davantage besoin de ces « mains de Dieu » dans les domaines de la découverte de médicaments, de nouveaux matériaux, du climat et du diagnostic médical. L’échiquier là-bas ne ressemblait en rien au Go, et personne ne nous a même remis les règles. De telles connaissances ne peuvent provenir que de systèmes qui raisonnent réellement : des conclusions tirées d’une chaîne de preuves vérifiables, d’inférences et de révisions de croyances, plutôt que d’une histoire convaincante concoctée après coup.
Il y a dix ans, AlphaGo utilisait sa 37e main pour dire au monde que les machines pouvaient surpasser l'intuition humaine.
Dix ans plus tard, l'un de ses créateurs nous le rappelle : ne vous laissez pas tromper par le langage fluide. Ce véritable saut ne s’est pas encore produit pour le LLM.
Vous avez dit que LLM ne pouvait pas raisonner,
Est-ce tenable ?
Après la publication de cet article d'opinion, il a provoqué toute une controverse sur X.
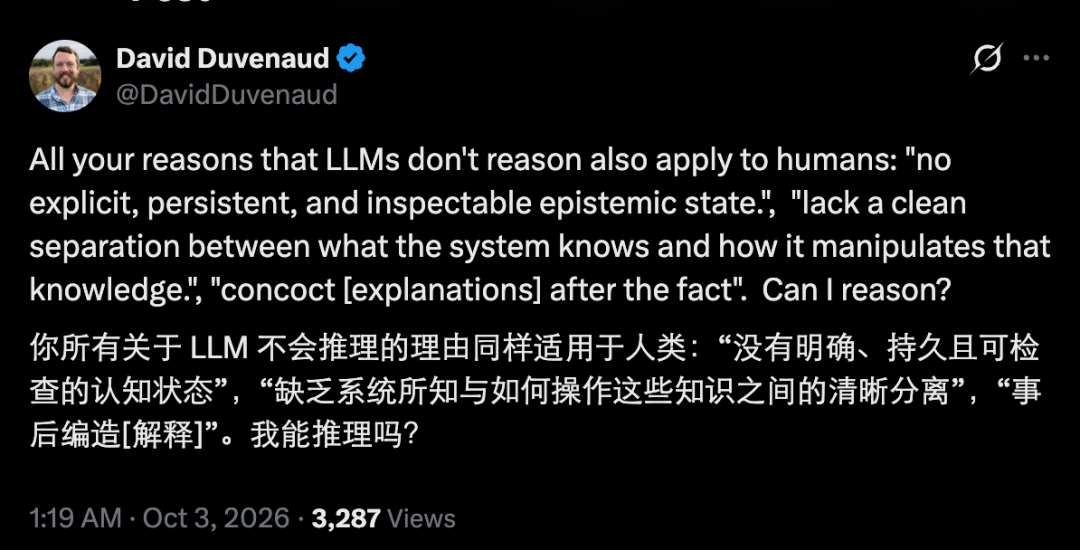
La question la plus incisive est venue du professeur David Duvenaud de l'Université de Toronto (l'un des auteurs du meilleur article NeurIPS sur l'ODE neuronale). Il a mentionné : Les trois accusations de Graepel contre LLM – aucun état cognitif vérifiable, aucune séparation entre connaissances et raisonnement, et fabrication d’explications après coup – sont également valables pour les humains. "Selon cette norme, puis-je être considéré comme bon en raisonnement ?"
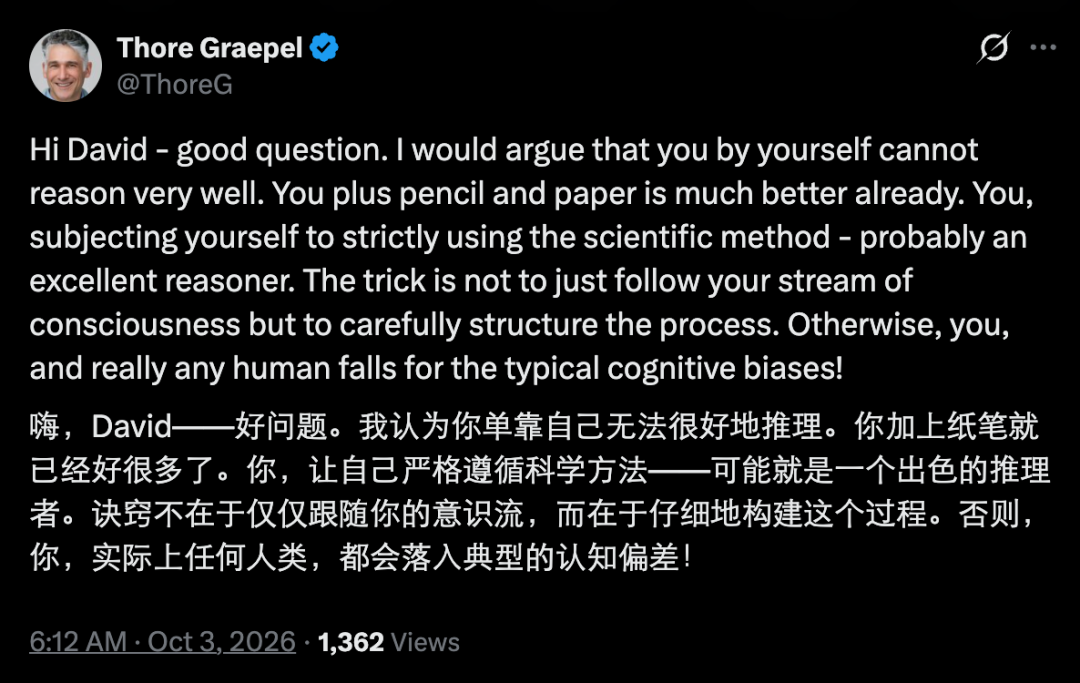
Graepel a répondu : Vous ne pouvez pas bien raisonner tout seul ; si on vous donne du papier et un stylo, ce sera bien mieux ; et si l’on vous demande de suivre strictement la méthode scientifique, vous serez considéré comme un excellent raisonneur. L’astuce n’est jamais de suivre le courant de la conscience, mais de structurer le processus – sinon personne ne pourra échapper aux biais cognitifs.
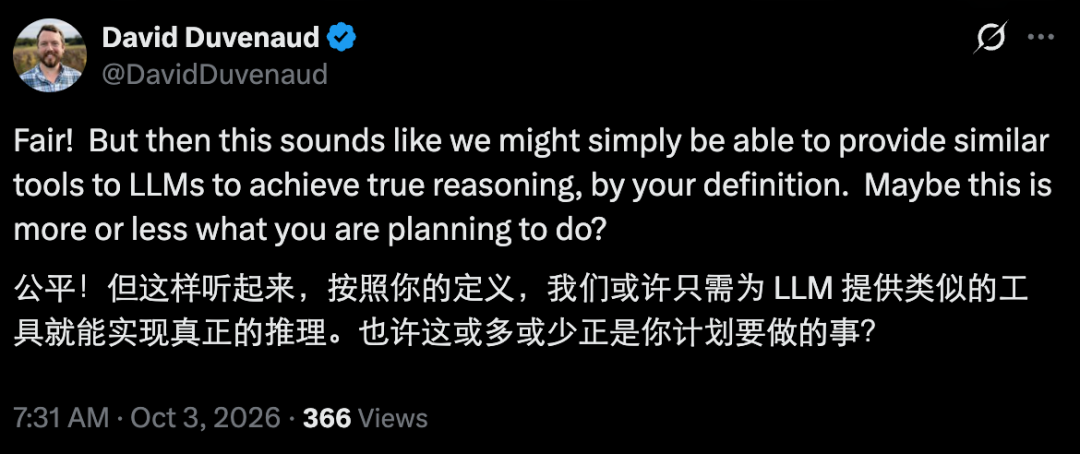
Duvenaud a immédiatement compris l'implication de cette phrase : "Il semble que nous puissions parvenir à un véritable raisonnement selon votre définition tant que nous équipons le LLM d'outils similaires - n'est-ce pas ce que vous avez l'intention de faire ?"
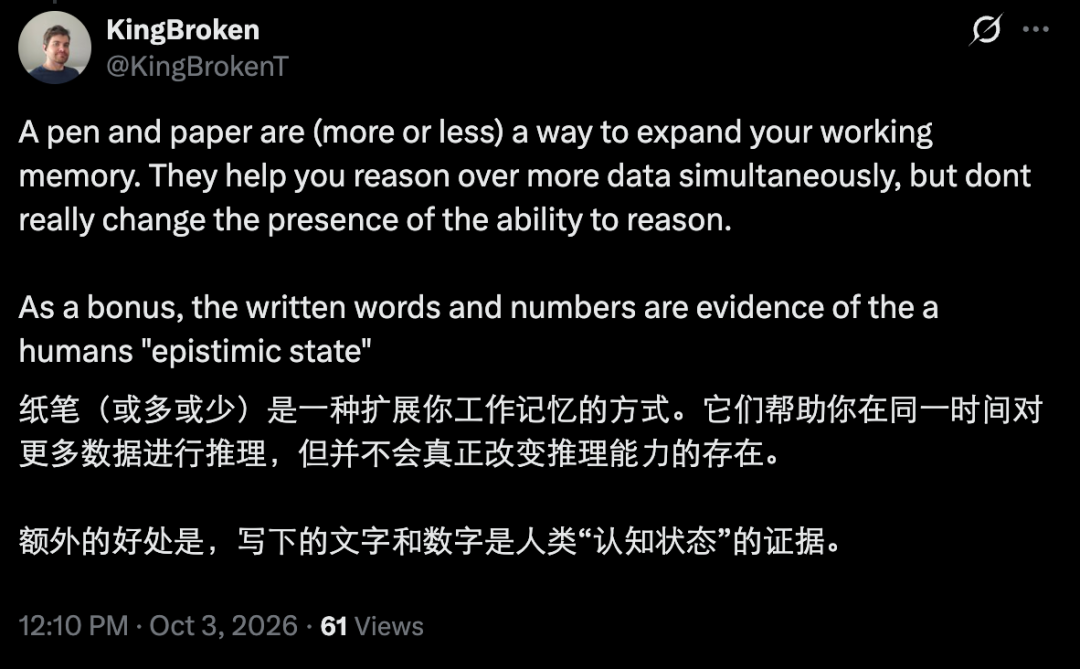
La « théorie de l'amélioration du papier et du crayon » de Graepel a également suscité les doutes d'autres internautes. L'internaute KingBroken a souligné que le papier et le stylo sont essentiellement un plug-in pour la mémoire de travail. Cela vous permet de raisonner sur plus de données en même temps, mais cela ne change pas l'existence d'une capacité de raisonnement « à partir de rien » ; mais cela présente un avantage supplémentaire : les mots et les chiffres écrits se révèlent être des preuves vérifiables du « statut cognitif » humain.
Immédiatement après, l'internaute Daniel Grant a posé une question plus pointue : selon cela, la méthode de raisonnement humain est équivalente à « modèle existant + système de plug-in », alors construisez-vous un modèle avec des capacités de raisonnement interne plus fortes que les deux ? Ou est-ce que j'ai raté une nuance ?
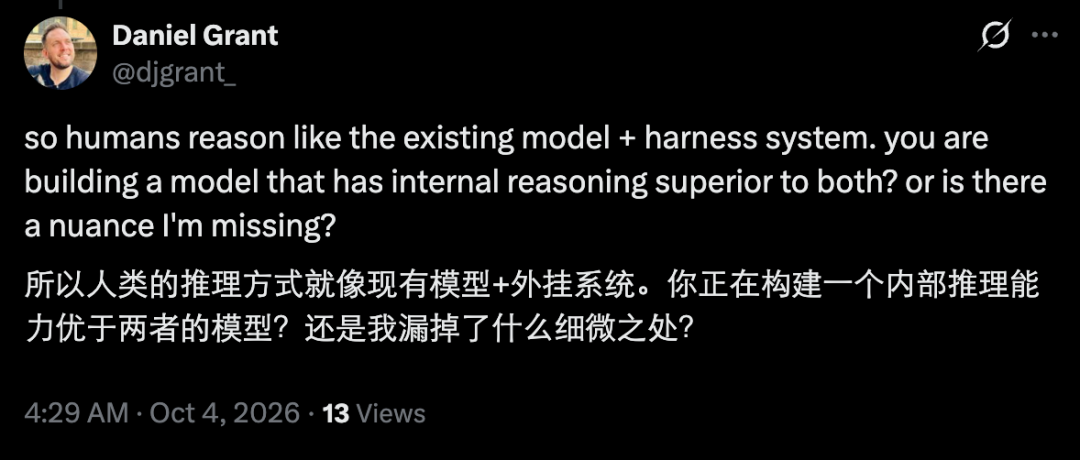
Graepel n'a pas encore répondu à ces questions.
Une autre voix a estimé que cette discussion était inutile. L'internaute visimo-dino a dit sans ambages : « Je ne peux pas croire qu'il y ait encore des gens qui écrivent ce genre d'article » : LLM a déjà bien performé dans trop de domaines, et la déclaration « ne peut pas raisonner » est soit ridicule, soit hors de propos, et des centaines d'articles similaires ont été publiés.
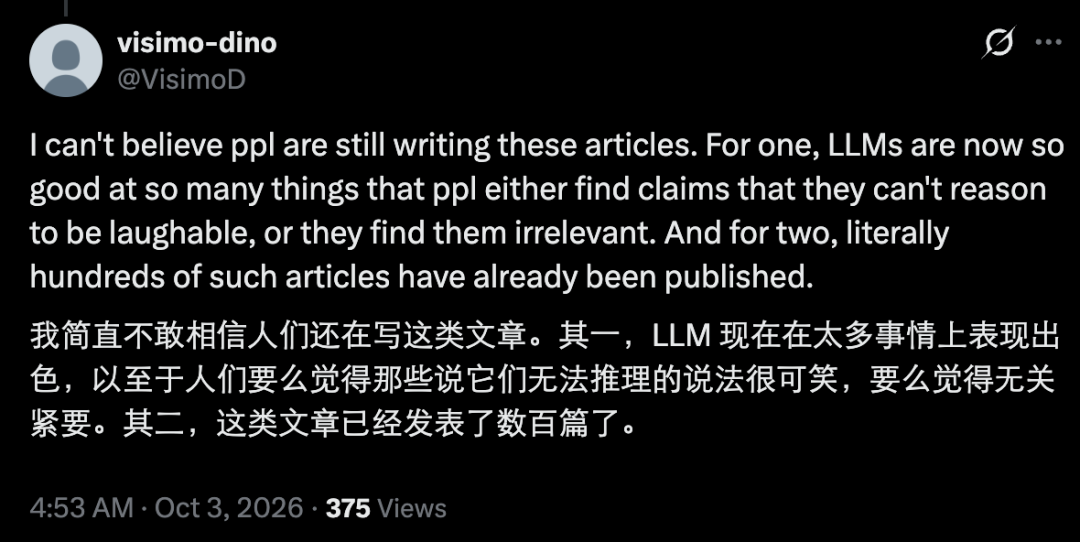
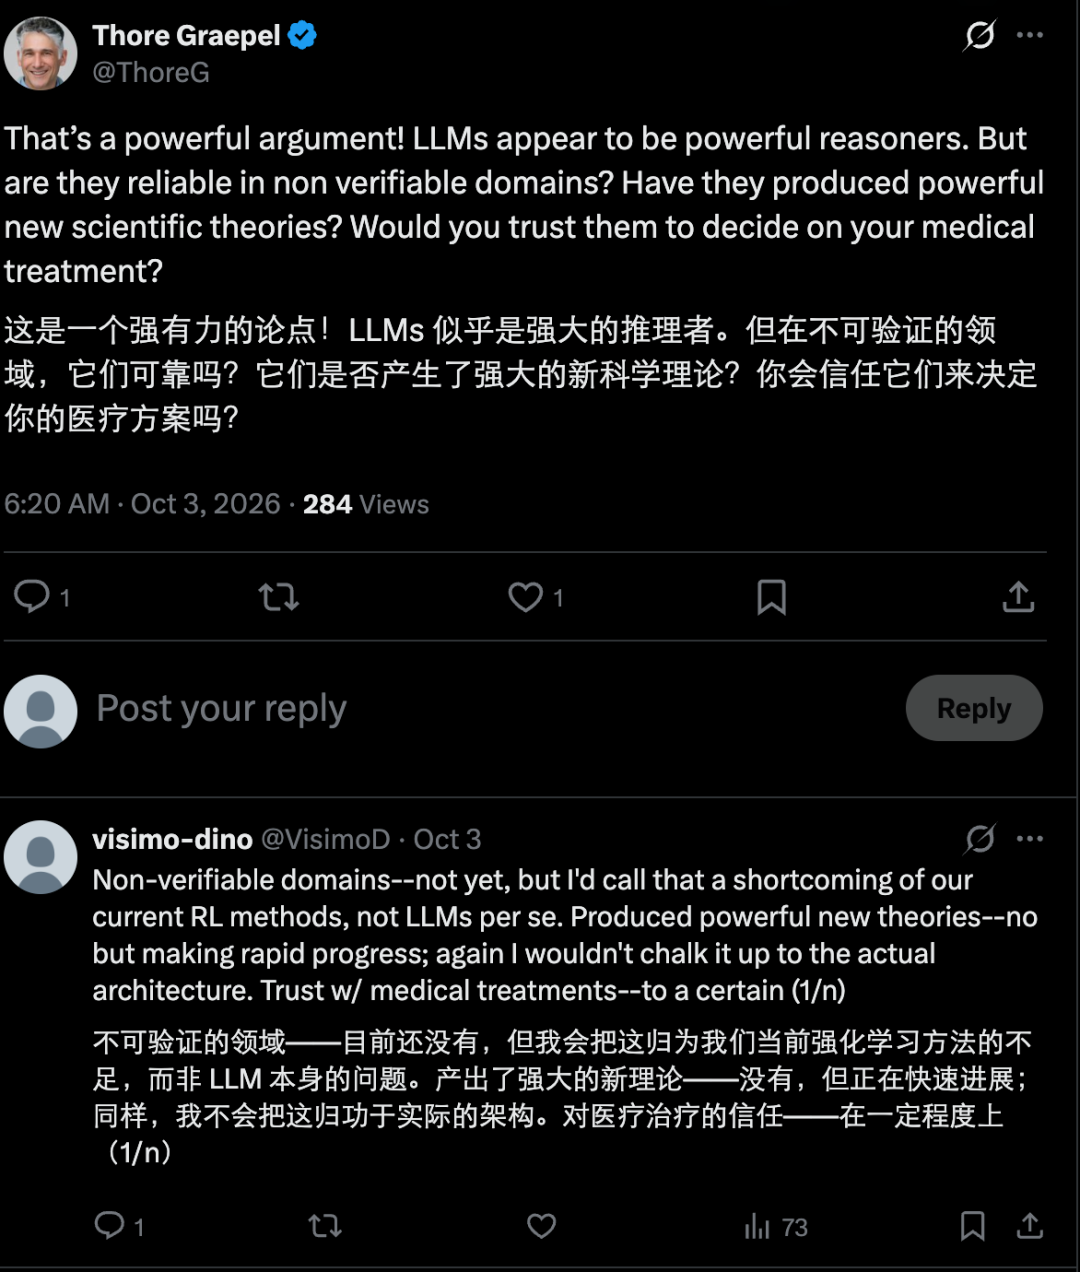
Graepel ne s'est pas attardé là-dessus, se contentant de soulever trois questions : sont-ils fiables dans les domaines où ils ne peuvent pas être vérifiés ? A-t-il produit une nouvelle théorie scientifique puissante ? Oserez-vous le laisser dicter votre traitement médical ? L'autre partie a été franche, admettant "pas encore", mais blâmant les méthodes d'apprentissage par renforcement existantes plutôt que l'architecture LLM elle-même - l'implication est que le problème sera résolu avec le temps. C’est probablement là la vraie différence entre les deux groupes : l’un pense que ce qui manque, c’est le temps, et l’autre pense que ce qui manque, c’est la structure.
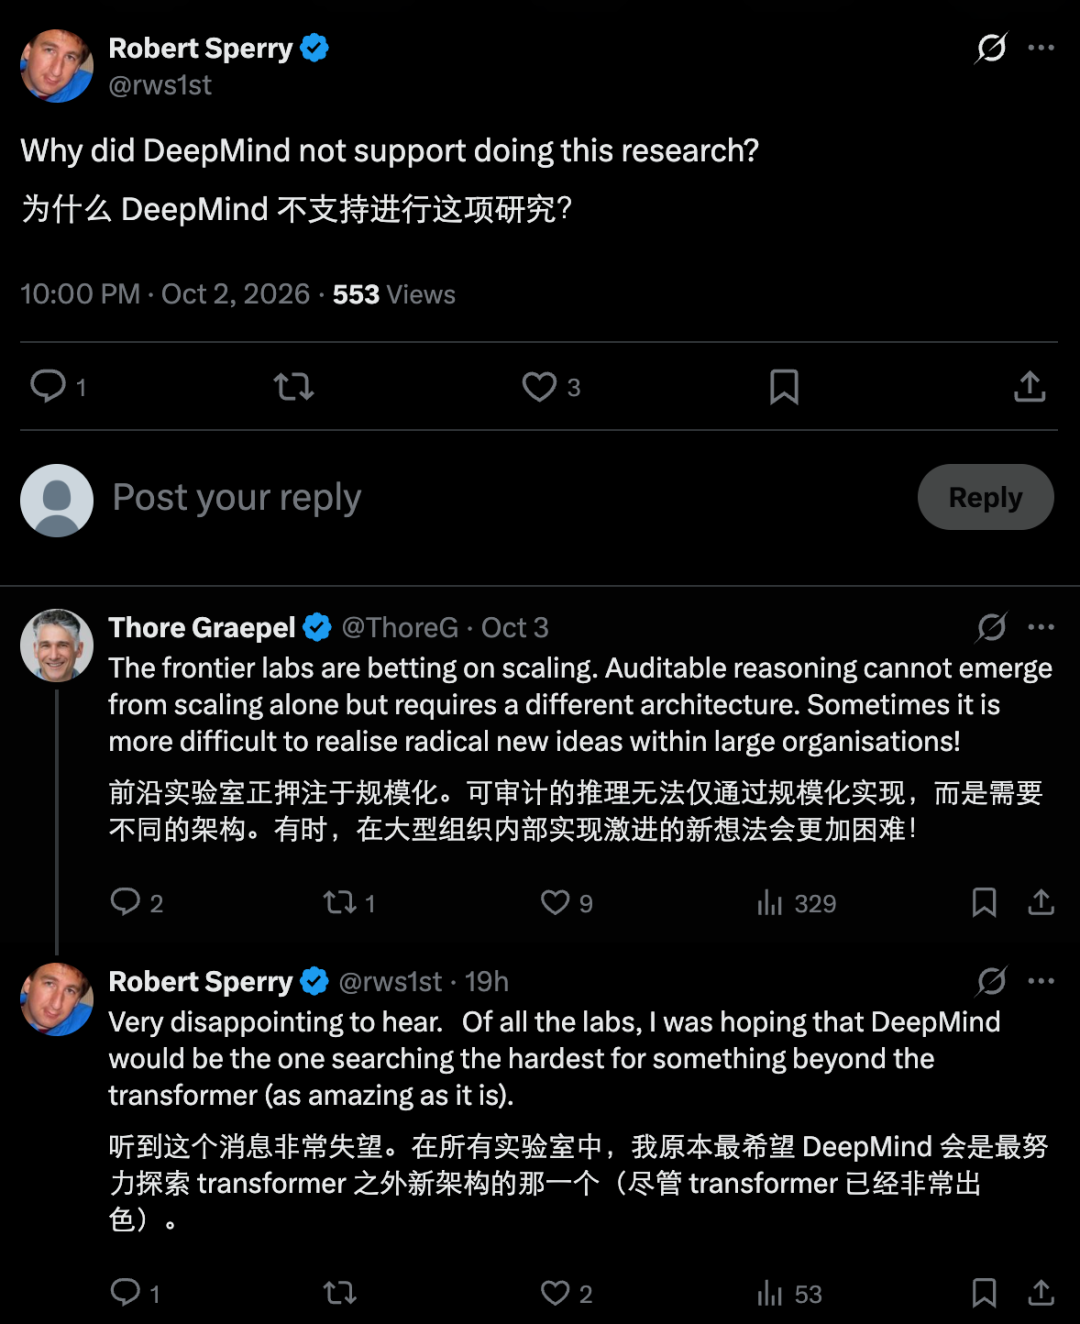
Un autre commentaire demandait ce que pensent de nombreuses personnes : pourquoi DeepMind ne soutient-il pas cette recherche ? La réponse de Graepel est simple : les laboratoires de pointe parient sur la mise à l'échelle, et un raisonnement vérifiable ne peut émerger de la seule mise à l'échelle. Cela nécessite une architecture différente. « Parfois, les nouvelles idées radicales sont plus difficiles à mettre en œuvre au sein des grandes organisations. » La déception de l'interrogateur Robert Sperry était palpable : de tous les laboratoires, il s'attendait à ce que DeepMind soit celui qui travaillerait le plus dur pour trouver des réponses au-delà de Transformer.
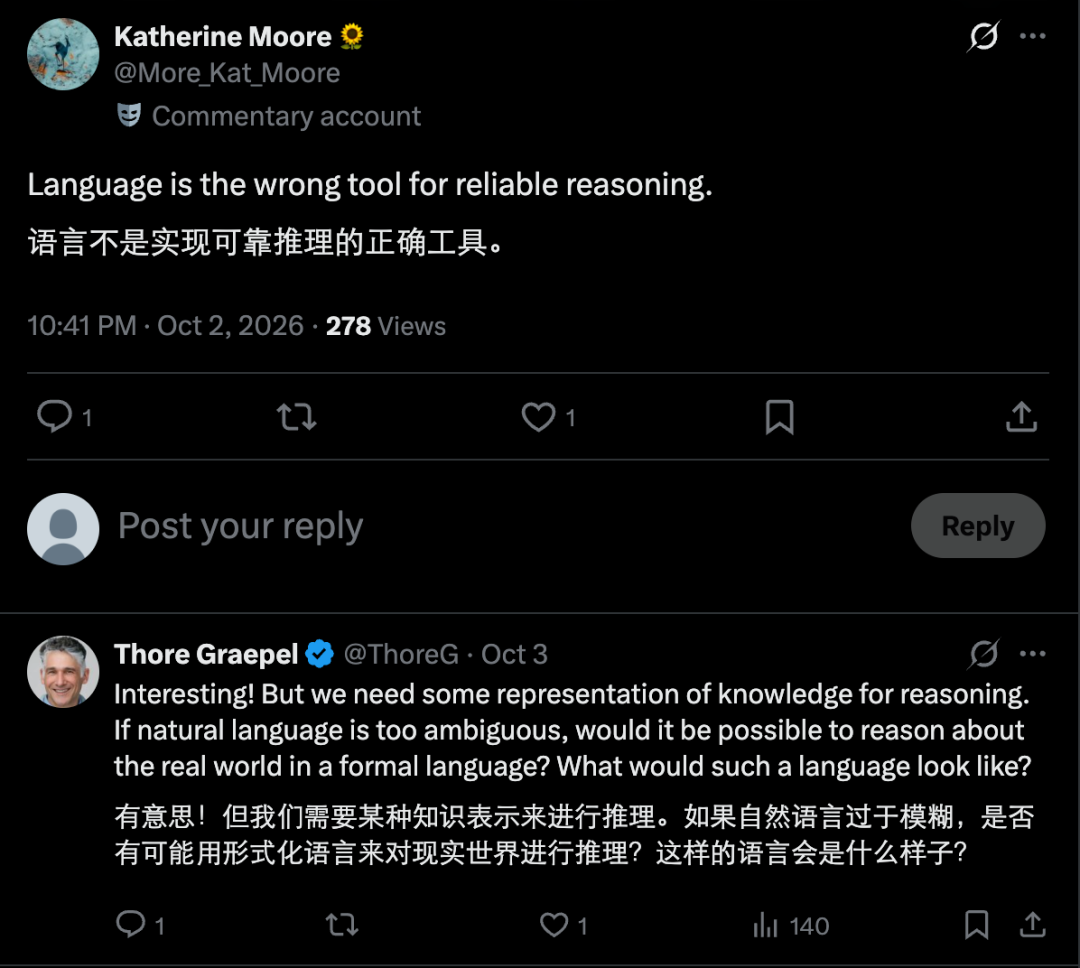
Certaines personnes ont également pointé du doigt un élément plus fondamental. La commentatrice Katherine Moore n'a laissé qu'une seule phrase : « Le langage lui-même n'est pas un bon outil, et on ne peut pas élaborer un raisonnement fiable avec lui. Graepel a pris cette position plus radicale au sérieux et a soulevé une question ouverte : le raisonnement nécessite une certaine forme de représentation des connaissances. Si le langage naturel est trop vague, le langage formel peut-il être utilisé pour raisonner sur le monde réel ? À quoi ressemblerait un tel langage ? . Il n'a pas donné de réponse, mais c'est peut-être la question à laquelle certaines personnes répondront lorsqu'elles créeront leur propre entreprise.
Commentaires