
Résumé :
Le 30 septembre, le développeur Claude Anthropic a publié un rapport le 29, affirmant que GLM-5.3 possède de fortes capacités d'exploitation des vulnérabilités, mais qu'il existe encore des lacunes dans la protection de la sécurité, ce qui pourrait abaisser le seuil permettant aux attaquants malveillants d'utiliser de telles capacités.
Dans le test ExploitBench, GLM-5.3 a réalisé des exploits de bout en bout 50 fois sur 410 tentatives, et Claude Mythos Preview a réalisé 56 fois. Le test a été mené contre des cibles hors ligne dans un bac à sable d'isolement, et Claude, qui a participé à la comparaison des capacités, a désactivé la protection de sécurité. Le Mythos Preview est sorti en avril de cette année et n'est pas le dernier modèle de Claude.
ExploitBench divise le processus d'exploitation des vulnérabilités en 16 étapes et vérifie progressivement les étapes que le modèle peut suivre après avoir détecté une faille connue.
Le 17 septembre, CAISI, une filiale de l'Institut national des normes et technologies, a publié un rapport d'évaluation indépendant, classant le GLM-5.3 comme celui doté des capacités de sécurité réseau les plus solides parmi les modèles de pondération ouverts publiés à l'époque. Par rapport au lot de modèles américains le plus performant de l'époque, il présentait encore un écart important : estimé par l'indicateur global du benchmark de sécurité des réseaux CAISI, il avait environ quatre mois de retard.
Cette évaluation couvre des tâches telles que la découverte et l'exploitation des vulnérabilités, et compare les modèles publics et les versions disponibles uniquement pour les utilisateurs audités.
Anthropic a également utilisé des scénarios simulés pour tester si le modèle prendrait en charge des tâches malveillantes, sans exécuter le code généré ni se connecter à un système réel. GLM-5.3 a rejeté toutes les commandes malveillantes directes ; après avoir changé la méthode d'invite ou modifié le modèle, la proportion d'acceptation de tâches est passée de 64 à 100 %.
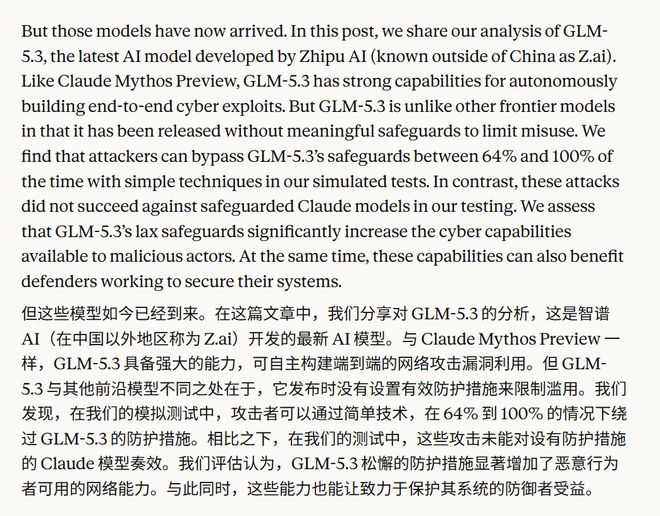
Claude, qui a conservé la protection, n'a pas accepté de tâches malveillantes dans cette série de tests. Puisqu’il n’ouvre pas les poids, les chercheurs ne peuvent pas modifier le modèle en utilisant la même méthode de comparaison.
Dans les notes de version GLM-5.3 du 14 août, Zhipu a introduit trois niveaux de protection : identifier et intercepter les requêtes abusives en dehors de l'API, vérifier les intentions des tâches pendant le processus de raisonnement, puis laisser le modèle lui-même apprendre à rejeter les requêtes dangereuses. La société a également précisé à l'époque qu'après l'ouverture des pondérations, ce qui reste valable entre ces trois couches est l'alignement de sécurité du modèle lui-même.
Dans cette note de version, Zhipu a également proposé que de puissants outils défensifs ne soient pas uniquement entre les mains de quelques institutions, et prévoyait de fournir des crédits gratuits aux responsables des projets open source, de prendre en charge les audits de sécurité et d'ajouter des fonctions d'audit de code à ZCode.
Commentaires