
Résumé :
Nvidia envisage d'investir dans d‑Matrix, selon trois personnes au courant de l'accord. Cette entreprise de 7 ans se concentre sur la recherche et le développement de puces de serveur pour l'intelligence artificielle, et son objectif produit est de concurrencer Nvidia. Cet investissement proposé est une initiative de Nvidia visant à promouvoir la compatibilité de sa propre technologie avec les concepteurs de puces concurrents et à intégrer les concurrents dans son écosystème matériel dominant, alors même que la part de Nvidia sur le marché des puces d'inférence d'IA continue d'augmenter.
Il s'agit également du premier accord de Nvidia avec une start-up de puces d'inférence d'IA depuis la signature d'un accord de licence technologique de 20 milliards de dollars avec Groq en décembre de l'année dernière. Cela montre que Nvidia n’a pas l’intention de miser uniquement sur cette seule entreprise.
Il y a trois mois, Nvidia a lancé un modèle de coopération avec ses concurrents en matière de puces, permettant aux puces des deux sociétés de fonctionner ensemble et de partager différentes tâches dans le même ensemble de charges de travail d'inférence d'IA. L’objectif est d’améliorer l’efficacité opérationnelle de ces tâches informatiques.
Il est difficile pour les concurrents d'ébranler l'énorme avance de Nvidia, c'est pourquoi de plus en plus de fabricants choisissent de travailler avec les GPU de Nvidia au lieu de les remplacer complètement. NVIDIA encourage ses concurrents à se connecter à son propre écosystème, et cela peut également bénéficier de ses produits matériels réseau ; ces produits peuvent interconnecter plusieurs groupes de racks de serveurs en tant que système global pour effectuer des calculs d'IA à forte charge. Cette solution technique est le calcul parallèle.
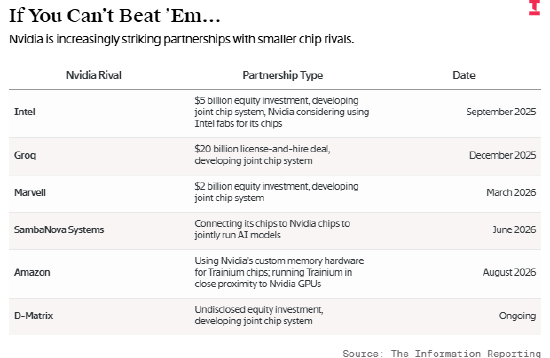
Au cours des 12 derniers mois, Nvidia a réalisé des investissements de plusieurs milliards de dollars dans Intel et Broadcom, deux autres grands concurrents en matière de puces d'IA, en partie pour promouvoir l'intégration des GPU Nvidia avec ces deux puces d'entreprise. On ne sait pas quand de telles intégrations seront disponibles à grande échelle. Des personnes de plusieurs start-ups de puces ont révélé que Nvidia avait également promu des solutions auprès de plusieurs autres start-ups de puces, dans l'espoir que leurs puces puissent être compatibles avec les GPU équipés de la technologie réseau Nvidia.
En août de cette année, Amazon a également proposé une idée d'intégration similaire : laissez le GPU Nvidia et la puce Trainium AI développée par Amazon coexister et fonctionner simultanément dans le même centre de données à l'aide d'un rack de serveur avec une architecture unifiée ; dans le même temps, la puce Trainium peut également faire appel au matériel réseau et mémoire de Nvidia.
SambaNova Systems, une autre start-up spécialisée dans les puces, a également présenté en juin une solution permettant d'interconnecter ses propres puces avec des GPU NVIDIA pour exécuter ensemble des modèles d'IA. Tout en favorisant l'intégration hétérogène mentionnée ci-dessus, NVIDIA développe également de manière indépendante un système de puce combinant le GPU avec la puce d'inférence IA dédiée de Groq. Auparavant, NVIDIA avait également absorbé l'équipe fondatrice de Groq et de nombreux employés dans le cadre de cette transaction de licence technologique de 20 milliards de dollars.
Le ministère américain de la Justice cherche à savoir si Nvidia a conçu l'accord Groq de manière à contourner une enquête officielle du ministère de la Justice sur l'impact de l'accord sur le marché des puces, selon des sources proches de l'enquête. La nouvelle a été rapportée pour la première fois par le New York Times.
Appeler des puces de différents fabricants pour traiter conjointement la même tâche d'IA est un concept industriel relativement nouveau, appelé
inférence désagrégée
. Neurone AWS. Bien que NVIDIA développe activement des solutions d'inférence découplée avec des concurrents plus petits, NVIDIA a déclaré publiquement qu'elle pouvait toujours gérer plus efficacement presque toutes les charges de travail d'IA avec ses propres puces.Même ainsi, les fournisseurs de services cloud et les principales sociétés de développement d'IA telles qu'Anthropic et OpenAI ne souhaitent pas s'appuyer entièrement sur un seul fournisseur de puces. En plus d'acheter des puces auprès d'autres fabricants pour réduire leur dépendance à l'égard de Nvidia, ces deux sociétés d'IA développent également leurs propres puces d'inférence d'IA.
L'objectif technique de d‑Matrix est le
décodage spéculatif
, cette technologie peut améliorer la vitesse d'exécution des modèles d'IA. Dans ce système commun qui sera lancé par NVIDIA, la puce d-Matrix exécutera un petit modèle d'IA et prédira à l'avance les résultats que le grand modèle devrait fournir à l'utilisateur ; tandis que le grand modèle fonctionnera sur le GPU NVIDIA pour vérifier les résultats supposés et confirmer leur adoption.The Information avait précédemment rapporté que d‑Matrix recherchait à l'époque une nouvelle ronde de financement, avec une valorisation post-monétaire cible de 5 milliards de dollars ; il n’est actuellement pas certain que le financement de Nvidia soit inclus dans ce tour de table. La dernière ronde de financement de d‑Matrix a eu lieu en novembre 2025, levant 275 millions de dollars, avec une valorisation post-money de 2 milliards de dollars. La société a achevé cet été la production en série de ses puces de première génération et teste actuellement ses puces de deuxième génération.
Commentaires